Cơ Chế Chú Ý và Mạng Nơ-ron Hồi Quy Tăng Cường
Mạng nơ-ron hồi quy (RNN) là một trong những công cụ nền tảng của học sâu, cho phép mạng nơ-ron làm việc với các chuỗi dữ liệu như văn bản, âm thanh và video. Chúng có thể cô đọng một chuỗi thành hiểu biết ở mức cao, gắn nhãn cho chuỗi, và thậm chí sinh ra chuỗi mới từ đầu.
Thiết kế RNN cơ bản gặp khó khăn với các chuỗi dài, nhưng một biến thể đặc biệt, mạng "long short-term memory" (LSTM), có thể xử lý cả những trường hợp này. Các mô hình như vậy rất mạnh, đạt kết quả đáng chú ý trong nhiều nhiệm vụ như dịch máy, nhận dạng giọng nói và chú thích ảnh. Vì thế, RNN đã trở nên phổ biến trong vài năm gần đây.
Cùng với sự phổ biến đó, ngày càng có nhiều nỗ lực bổ sung cho RNN những thuộc tính mới. Bốn hướng sau đặc biệt thú vị:
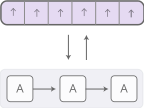 Neural Turing Machines có bộ nhớ ngoài để đọc và ghi.
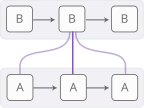 Giao diện attention cho phép RNN tập trung vào các phần của đầu vào.
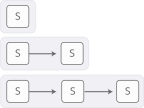 Adaptive Computation Time cho phép thay đổi lượng tính toán ở mỗi bước.
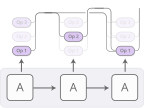 Neural Programmer có thể gọi hàm và xây dựng chương trình trong khi chạy.
Xét riêng lẻ, các kỹ thuật này đều là những phần mở rộng mạnh cho RNN. Điều nổi bật hơn là chúng có thể kết hợp với nhau và dường như chỉ là các điểm khác nhau trong một không gian rộng hơn. Hơn nữa, tất cả đều dựa vào cùng một mẹo nền tảng: một thứ gọi là attention, hay cơ chế chú ý.
Chúng tôi cho rằng các "RNN tăng cường" này sẽ đóng vai trò quan trọng trong việc mở rộng năng lực của học sâu trong những năm tới.
Neural Turing Machines
Neural Turing Machines kết hợp một RNN với một ngân hàng bộ nhớ ngoài. Vì vector là ngôn ngữ tự nhiên của mạng nơ-ron, bộ nhớ được biểu diễn như một mảng các vector:
Nhưng việc đọc và ghi hoạt động như thế nào? Thách thức là ta muốn các thao tác này khả vi. Cụ thể hơn, ta muốn chúng khả vi theo vị trí đọc hoặc ghi, để mô hình có thể học nên đọc và ghi ở đâu. Điều này khó vì địa chỉ bộ nhớ có vẻ là rời rạc. NTM dùng một giải pháp rất khéo: ở mỗi bước, chúng đọc và ghi ở mọi nơi, chỉ khác nhau về mức độ.
Hãy tập trung vào thao tác đọc. Thay vì chỉ định một vị trí duy nhất, RNN xuất ra một "phân phối attention" mô tả mức độ quan tâm tới từng vị trí bộ nhớ. Kết quả của phép đọc vì thế là một tổng có trọng số.
Tương tự, ta ghi vào mọi nơi cùng lúc nhưng với các mức độ khác nhau. Một phân phối attention mô tả lượng ghi tại từng vị trí. Giá trị mới của một vị trí trong bộ nhớ là tổ hợp lồi giữa nội dung cũ và giá trị cần ghi, trong đó attention weight quyết định điểm nằm giữa hai giá trị đó.
Vậy NTM quyết định tập trung vào vị trí nào trong bộ nhớ bằng cách nào? Chúng thực ra dùng kết hợp hai phương pháp: attention dựa trên nội dung và attention dựa trên vị trí. Attention dựa trên nội dung giúp NTM tìm trong bộ nhớ những nơi khớp với thứ nó đang tìm. Attention dựa trên vị trí cho phép di chuyển tương đối trong bộ nhớ, nhờ đó NTM có thể lặp.
Khả năng đọc và ghi này cho phép NTM thực hiện nhiều thuật toán đơn giản, điều trước đây nằm ngoài khả năng của mạng nơ-ron. Ví dụ, chúng có thể học cách lưu một chuỗi dài vào bộ nhớ rồi lặp qua chuỗi đó để phát lại nhiều lần. Khi chúng làm vậy, ta có thể quan sát nơi chúng đọc và ghi để hiểu rõ hơn chúng đang làm gì:
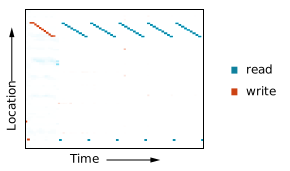 Xem thêm các thí nghiệm trong bài báo của Graves và cộng sự. Hình này dựa trên thí nghiệm Repeat Copy.
Chúng cũng có thể học cách bắt chước bảng tra cứu, hoặc thậm chí học sắp xếp số, dù theo một cách hơi "lách luật". Mặt khác, chúng vẫn chưa làm được nhiều việc cơ bản như cộng hay nhân số.
Kể từ bài báo NTM ban đầu, đã có nhiều công trình thú vị đi theo các hướng tương tự. Neural GPU khắc phục việc NTM không thể cộng và nhân. Một số công trình huấn luyện NTM bằng học tăng cường thay vì các phép đọc/ghi khả vi ban đầu. Neural Random Access Machines dựa trên con trỏ. Một số bài báo khác khám phá các cấu trúc dữ liệu khả vi như stack và queue. Memory networks cũng là một cách tiếp cận khác cho các vấn đề tương tự.
Theo một nghĩa khách quan, nhiều nhiệm vụ mà các mô hình này làm được, chẳng hạn học cách cộng số, không phải là quá khó. Cộng đồng tổng hợp chương trình truyền thống có thể xử lý chúng rất dễ dàng. Nhưng mạng nơ-ron còn có nhiều năng lực khác, và các mô hình như Neural Turing Machine dường như đã phá bỏ một giới hạn rất sâu trong khả năng của chúng.
Mã nguồn
Có nhiều triển khai mã nguồn mở cho các mô hình này. Các triển khai Neural Turing Machine gồm bản của Taehoon Kim (TensorFlow), Shawn Tan (Theano), Fumin (Go), Kai Sheng Tai (Torch), và Snip (Lasagne). Mã nguồn cho Neural GPU được đưa vào kho TensorFlow Models. Các triển khai Memory Networks gồm Facebook (Torch/Matlab), YerevaNN (Theano), và Taehoon Kim (TensorFlow).
Giao diện Attention
Khi dịch một câu, tôi đặc biệt chú ý tới từ mình đang dịch. Khi chép lại một bản ghi âm, tôi nghe kỹ đoạn mình đang viết xuống. Và nếu bạn yêu cầu tôi mô tả căn phòng tôi đang ngồi, tôi sẽ liếc quanh các đồ vật khi mô tả chúng.
Mạng nơ-ron có thể đạt được hành vi tương tự bằng attention: tập trung vào một phần của tập thông tin được cung cấp. Ví dụ, một RNN có thể chú ý lên đầu ra của một RNN khác. Ở mỗi bước thời gian, nó tập trung vào các vị trí khác nhau trong RNN kia.
Ta muốn attention khả vi để có thể học nên tập trung vào đâu. Để làm điều đó, ta dùng cùng mẹo với Neural Turing Machines: tập trung vào mọi nơi, nhưng với các mức độ khác nhau.
Phân phối attention thường được tạo bằng attention dựa trên nội dung. RNN đang chú ý sinh ra một truy vấn mô tả thứ nó muốn tập trung vào. Mỗi mục được nhân vô hướng với truy vấn để tạo điểm số, thể hiện mức độ khớp với truy vấn. Các điểm số đi qua softmax để tạo thành phân phối attention.
Một ứng dụng của attention giữa các RNN là dịch máy. Mô hình sequence-to-sequence truyền thống phải nén toàn bộ đầu vào thành một vector duy nhất rồi mở rộng nó trở lại. Attention tránh điều này bằng cách cho RNN xử lý đầu vào truyền thông tin về từng từ nó thấy, còn RNN sinh đầu ra thì tập trung vào các từ liên quan khi cần.
Kiểu attention giữa các RNN này còn có nhiều ứng dụng khác. Nó có thể dùng trong nhận dạng giọng nói: một RNN xử lý âm thanh, còn RNN khác lướt qua kết quả đó, tập trung vào các phần liên quan khi sinh bản chép lời.
Các ứng dụng khác gồm phân tích cú pháp văn bản, nơi mô hình có thể liếc tới các từ khi sinh cây cú pháp, và mô hình hội thoại, nơi mô hình tập trung vào các phần trước đó của cuộc trò chuyện khi sinh phản hồi.
Attention cũng có thể dùng ở giao diện giữa mạng nơ-ron tích chập và RNN. Điều này cho phép RNN nhìn vào các vị trí khác nhau của ảnh ở mỗi bước. Một ứng dụng phổ biến là chú thích ảnh. Trước hết, conv net xử lý ảnh và trích xuất đặc trưng cấp cao. Sau đó RNN chạy để sinh mô tả ảnh. Khi sinh từng từ, RNN tập trung vào phần diễn giải tương ứng của conv net. Ta có thể trực quan hóa điều này:
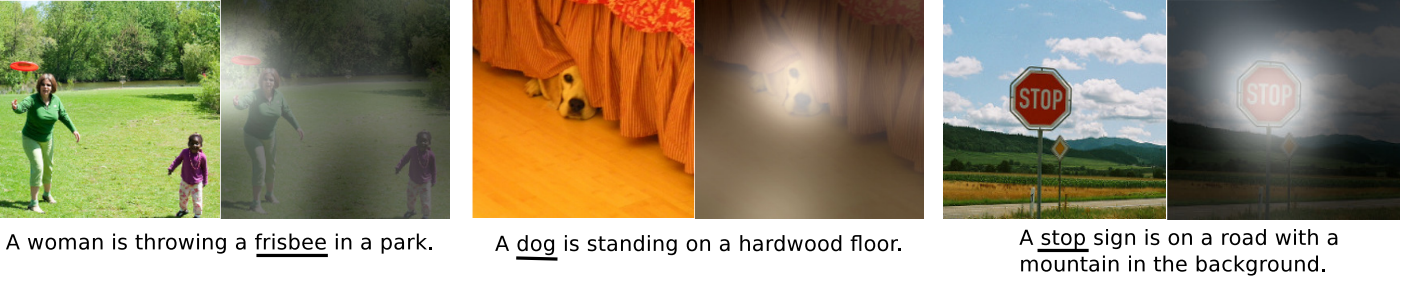 Hình từ Xu và cộng sự.
Rộng hơn, giao diện attention có thể dùng bất cứ khi nào ta muốn kết nối với một mạng nơ-ron có cấu trúc lặp trong đầu ra.
Giao diện attention đã được chứng minh là một kỹ thuật cực kỳ tổng quát và mạnh mẽ, và đang ngày càng phổ biến.
Adaptive Computation Time
RNN tiêu chuẩn thực hiện cùng một lượng tính toán cho mỗi bước thời gian. Điều này không trực giác lắm. Chẳng phải ta nên suy nghĩ nhiều hơn khi việc khó hơn sao? Nó cũng giới hạn RNN ở mức O(n) phép toán cho một danh sách độ dài n.
Adaptive Computation Time là cách để RNN thực hiện lượng tính toán khác nhau ở mỗi bước. Ý tưởng tổng quát rất đơn giản: cho phép RNN chạy nhiều bước tính toán cho mỗi bước thời gian.
Để mạng học được nên chạy bao nhiêu bước, ta muốn số bước là khả vi. Ta đạt được điều này bằng cùng mẹo trước đó: thay vì quyết định chạy một số bước rời rạc, ta có một phân phối attention trên số bước sẽ chạy. Đầu ra là tổ hợp có trọng số của đầu ra ở từng bước.
Còn vài chi tiết bị lược bỏ trong sơ đồ trước. Đây là sơ đồ đầy đủ của một bước thời gian với ba bước tính toán.
Sơ đồ đó hơi phức tạp, nên hãy đi từng bước. Ở mức cao, ta vẫn chạy RNN và xuất ra một tổ hợp có trọng số của các trạng thái:
Trọng số cho mỗi bước được xác định bởi một "halting neuron". Đó là một neuron sigmoid nhìn vào trạng thái RNN và đưa ra trọng số dừng, có thể hiểu như xác suất nên dừng ở bước đó.
Ta có tổng ngân sách cho các trọng số dừng là 1, nên theo dõi ngân sách đó ở phía trên. Khi nó giảm xuống dưới epsilon, ta dừng.
Khi dừng, có thể vẫn còn một phần ngân sách dừng vì ta dừng khi nó nhỏ hơn epsilon. Nên làm gì với phần còn lại? Về mặt kỹ thuật, nó được chuyển cho các bước tương lai, nhưng ta không muốn tính các bước đó, nên gán nó cho bước cuối cùng.
Khi huấn luyện mô hình Adaptive Computation Time, ta thêm một hạng "ponder cost" vào hàm chi phí. Hạng này phạt mô hình theo lượng tính toán nó dùng. Hạng phạt càng lớn, mô hình càng đánh đổi hiệu năng để giảm thời gian tính toán.
Adaptive Computation Time là một ý tưởng rất mới, nhưng chúng tôi tin rằng nó, cùng các ý tưởng tương tự, sẽ rất quan trọng.
Mã nguồn
Triển khai mã nguồn mở duy nhất của Adaptive Computation Time hiện có vẻ là bản của Mark Neumann trên TensorFlow.
Neural Programmer
Mạng nơ-ron làm rất tốt nhiều nhiệm vụ, nhưng vẫn gặp khó với những việc cơ bản như số học, vốn là chuyện tầm thường trong các cách tính toán thông thường. Sẽ rất hữu ích nếu có cách dung hợp mạng nơ-ron với lập trình truyền thống để lấy được ưu điểm của cả hai.
Neural Programmer là một cách tiếp cận cho mục tiêu này. Nó học cách tạo chương trình để giải một nhiệm vụ. Thực ra, nó học sinh các chương trình như vậy mà không cần ví dụ về chương trình đúng. Nó khám phá cách tạo chương trình như một phương tiện để đạt mục tiêu của nhiệm vụ.
Mô hình trong bài báo trả lời câu hỏi về bảng bằng cách sinh các chương trình giống SQL để truy vấn bảng. Tuy nhiên, có một số chi tiết làm mô hình đó hơi phức tạp, nên hãy bắt đầu bằng một mô hình đơn giản hơn: nhận một biểu thức số học và sinh chương trình để tính giá trị của nó.
Chương trình được sinh ra là một chuỗi các phép toán. Mỗi phép toán được định nghĩa để hoạt động trên đầu ra của các phép toán trước đó. Ví dụ, một phép toán có thể là "cộng đầu ra của phép toán cách đây 2 bước với đầu ra của phép toán cách đây 1 bước". Nó giống một Unix pipe hơn là một chương trình có biến được gán và đọc.
Chương trình được sinh từng phép toán một bởi một RNN điều khiển. Ở mỗi bước, RNN điều khiển xuất ra một phân phối xác suất cho phép toán tiếp theo. Ví dụ, ta có thể khá chắc muốn thực hiện phép cộng ở bước đầu, rồi khó quyết định giữa nhân và chia ở bước thứ hai, v.v.
Phân phối kết quả trên các phép toán giờ có thể được đánh giá. Thay vì chạy một phép toán duy nhất ở mỗi bước, ta dùng mẹo attention quen thuộc: chạy tất cả rồi lấy trung bình các đầu ra, có trọng số theo xác suất ta chạy phép toán đó.
Miễn là ta định nghĩa được đạo hàm xuyên qua các phép toán, đầu ra của chương trình sẽ khả vi theo các xác suất. Khi đó ta định nghĩa loss và huấn luyện mạng nơ-ron sinh ra chương trình cho đáp án đúng. Theo cách này, Neural Programmer học sinh chương trình mà không cần ví dụ chương trình tốt; tín hiệu giám sát duy nhất là đáp án chương trình cần tạo ra.
Đó là ý tưởng cốt lõi của Neural Programmer, nhưng phiên bản trong bài báo trả lời câu hỏi về bảng thay vì biểu thức số học. Có thêm vài mẹo đáng chú ý:
Nhiều kiểu dữ liệu: Nhiều phép toán trong Neural Programmer xử lý các kiểu khác số vô hướng. Một số phép toán xuất ra lựa chọn cột hoặc lựa chọn ô trong bảng. Chỉ các đầu ra cùng kiểu mới được gộp lại với nhau.
Tham chiếu đầu vào: Neural Programmer cần trả lời các câu hỏi như "Có bao nhiêu thành phố có dân số lớn hơn 1.000.000?" khi được cung cấp bảng thành phố có cột dân số. Để làm điều này, một số phép toán cho phép mạng tham chiếu tới hằng số trong câu hỏi hoặc tên cột. Việc tham chiếu này xảy ra bằng attention, theo phong cách pointer networks.
Neural Programmer không phải cách duy nhất để mạng nơ-ron sinh chương trình. Một cách tiếp cận thú vị khác là Neural Programmer-Interpreter, có thể hoàn thành nhiều nhiệm vụ rất hay nhưng cần giám sát dưới dạng chương trình đúng.
Chúng tôi cho rằng không gian tổng quát này, việc bắc cầu giữa lập trình truyền thống và mạng nơ-ron, là cực kỳ quan trọng. Dù Neural Programmer rõ ràng chưa phải lời giải cuối cùng, có rất nhiều bài học quan trọng có thể rút ra từ nó.
Mã nguồn
Phiên bản Neural Programmer mới hơn cho hỏi đáp đã được các tác giả mở mã nguồn và có sẵn dưới dạng một TensorFlow Model. Ngoài ra còn có triển khai Neural Programmer-Interpreter của Ken Morishita trên Keras.
Bức Tranh Lớn
Một con người có giấy bút, theo một nghĩa nào đó, thông minh hơn nhiều so với khi không có. Một người có ký hiệu toán học có thể giải những bài toán mà nếu không thì không giải được. Truy cập vào máy tính giúp ta làm được những điều phi thường, vượt xa khả năng nếu thiếu chúng.
Nhìn chung, nhiều dạng trí tuệ thú vị dường như là sự tương tác giữa trực giác heuristic sáng tạo của con người và một số phương tiện sắc nét, cẩn trọng hơn, như ngôn ngữ hoặc phương trình. Đôi khi phương tiện đó là thứ tồn tại vật lý, lưu trữ thông tin cho ta, ngăn ta mắc lỗi, hoặc gánh phần tính toán nặng. Trong trường hợp khác, phương tiện là một mô hình trong đầu để ta thao tác. Dù theo cách nào, nó dường như rất nền tảng đối với trí tuệ.
Các kết quả gần đây trong học máy bắt đầu mang hương vị này: kết hợp trực giác của mạng nơ-ron với một thứ khác. Một hướng là "tìm kiếm heuristic". Ví dụ, AlphaGo có mô hình về cách cờ vây vận hành và khám phá các diễn biến ván cờ dưới sự dẫn dắt của trực giác từ mạng nơ-ron. Tương tự, DeepMath dùng mạng nơ-ron như trực giác để thao tác các biểu thức toán học. Các "RNN tăng cường" được bàn trong bài này là một hướng khác, nơi ta kết nối RNN với các phương tiện được thiết kế để mở rộng năng lực tổng quát của chúng.
Tương tác với một phương tiện tự nhiên bao gồm một chuỗi hành động: thực hiện hành động, quan sát, rồi thực hiện thêm hành động. Điều này tạo ra một thách thức lớn: làm sao ta học được nên chọn hành động nào? Nghe giống một bài toán học tăng cường, và ta chắc chắn có thể đi theo hướng đó. Nhưng văn liệu học tăng cường đang tấn công phiên bản khó nhất của bài toán này, và lời giải của nó khó dùng. Điều tuyệt vời của attention là nó cho ta một lối ra dễ hơn: thực hiện một phần tất cả hành động ở các mức độ khác nhau. Điều này hoạt động vì ta có thể thiết kế các phương tiện, như bộ nhớ NTM, để cho phép hành động phân số và khả vi. Học tăng cường buộc ta đi một con đường duy nhất rồi cố học từ đó. Attention đi mọi hướng ở một ngã rẽ rồi gộp các đường lại với nhau.
Một điểm yếu lớn của attention là ta phải thực hiện mọi "hành động" ở mỗi bước. Điều này khiến chi phí tính toán tăng tuyến tính khi tăng lượng bộ nhớ trong Neural Turing Machine. Ta có thể tưởng tượng việc làm attention thưa hơn để chỉ cần chạm vào một số vùng nhớ. Tuy nhiên, điều này vẫn khó vì ta có thể muốn attention phụ thuộc vào nội dung bộ nhớ, và cách làm ngây thơ buộc ta nhìn vào từng ô nhớ. Đã có một số nỗ lực ban đầu tấn công vấn đề này, nhưng còn rất nhiều việc phải làm. Nếu thật sự làm được attention thời gian dưới tuyến tính, điều đó sẽ rất mạnh.
Mạng nơ-ron hồi quy tăng cường, cùng kỹ thuật attention nằm bên dưới, là một hướng cực kỳ thú vị. Chúng tôi mong chờ xem điều gì sẽ xảy ra tiếp theo.