Deconvolution và Hiện Tượng Checkerboard
Khi nhìn thật kỹ các ảnh do mạng nơ-ron sinh ra, ta thường thấy một mẫu artefact dạng bàn cờ kỳ lạ. Nó rõ hơn trong một số trường hợp so với những trường hợp khác, nhưng phần lớn các mô hình gần đây đều biểu hiện hành vi này.
Một cách khó hiểu, mẫu bàn cờ này thường nổi bật nhất trong các ảnh có màu sắc mạnh. Chuyện gì đang xảy ra? Mạng nơ-ron ghét màu sáng sao? Nguyên nhân thật sự của các artefact này hóa ra rất đơn giản, và cách tránh chúng cũng vậy.
Deconvolution và sự chồng lấn
Khi ta để mạng nơ-ron sinh ảnh, ta thường cho chúng xây ảnh dần lên từ các mô tả mức cao, độ phân giải thấp. Điều này cho phép mạng mô tả hình ảnh thô rồi sau đó điền các chi tiết.
Để làm vậy, ta cần một cách đi từ ảnh độ phân giải thấp lên ảnh độ phân giải cao hơn. Thông thường ta dùng phép deconvolution. Nói đại khái, các lớp deconvolution cho phép mô hình dùng từng điểm trong ảnh nhỏ để "vẽ" một ô vuông trong ảnh lớn hơn.
Deconvolution có nhiều cách diễn giải và nhiều tên gọi khác nhau, bao gồm "transposed convolution". Trong bài này, chúng tôi dùng tên "deconvolution" cho ngắn gọn. Để đọc một thảo luận xuất sắc về deconvolution, xem .
Đáng tiếc, deconvolution rất dễ tạo ra "chồng lấn không đều", tức đặt nhiều "sơn" ẩn dụ hơn ở một số vị trí so với những vị trí khác . Cụ thể, deconvolution có chồng lấn không đều khi kích thước kernel, tức kích thước cửa sổ đầu ra, không chia hết cho stride, tức khoảng cách giữa các điểm ở phía trên. Về nguyên tắc, mạng có thể học trọng số thật cẩn thận để tránh điều này, như ta sẽ bàn kỹ hơn sau, nhưng trong thực tế mạng nơ-ron khó tránh hoàn toàn.
Mẫu chồng lấn cũng hình thành trong hai chiều. Các chồng lấn không đều trên hai trục nhân với nhau, tạo ra mẫu cường độ thay đổi giống bàn cờ.
Thực ra, chồng lấn không đều thường còn cực đoan hơn trong hai chiều. Vì hai mẫu được nhân với nhau, độ không đều bị bình phương. Ví dụ, trong một chiều, deconvolution stride 2, size 3 có một số đầu ra nhận số đầu vào gấp đôi các đầu ra khác; nhưng trong hai chiều, điều này trở thành hệ số bốn.
Giờ đây, mạng nơ-ron thường dùng nhiều lớp deconvolution khi tạo ảnh, lặp đi lặp lại việc xây ảnh lớn hơn từ một chuỗi mô tả độ phân giải thấp. Dù về lý thuyết các deconvolution xếp chồng có thể triệt tiêu artefact của nhau, chúng thường cộng hưởng và tạo artefact ở nhiều thang đo.
Deconvolution stride 1, thứ ta thường thấy như lớp cuối trong các mô hình thành công, khá hiệu quả trong việc làm dịu artefact. Chúng có thể loại bỏ các artefact có tần số chia hết cho kích thước của chúng, và giảm các artefact khác có tần số nhỏ hơn kích thước đó. Tuy nhiên, artefact vẫn có thể lọt qua, như đã thấy trong nhiều mô hình gần đây.
Ngoài các artefact tần số cao dạng bàn cờ mà ta quan sát ở trên, các deconvolution sớm có thể tạo artefact tần số thấp hơn; ta sẽ khám phá điều này kỹ hơn ở phần sau.
Các artefact này thường nổi bật nhất khi mô hình xuất ra các màu bất thường. Vì các lớp mạng nơ-ron thường có bias, tức một giá trị học được cộng vào đầu ra, việc xuất ra màu trung bình là dễ. Một màu càng xa màu trung bình, chẳng hạn đỏ sáng, deconvolution càng phải đóng góp nhiều hơn.
Chồng lấn và học
Suy nghĩ theo chồng lấn không đều là một khung nhìn hữu ích, nhưng cũng hơi đơn giản. Dù tốt hay xấu, các mô hình của ta học trọng số cho deconvolution.
Về lý thuyết, mô hình có thể học cách ghi thật cẩn thận vào các vị trí chồng lấn không đều để đầu ra được cân bằng.
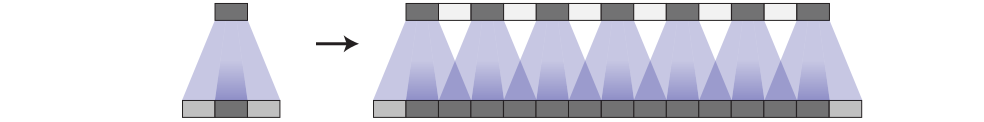
Đây là một bài toán cân bằng khó, đặc biệt khi có nhiều kênh tương tác. Tránh artefact giới hạn đáng kể các bộ lọc có thể có, làm hy sinh năng lực mô hình. Trong thực tế, mạng nơ-ron khó học cách tránh hoàn toàn các mẫu này.
Thực ra, không chỉ các mô hình có chồng lấn không đều không học được cách tránh điều này; ngay cả các mô hình có chồng lấn đều cũng thường học kernel gây ra artefact tương tự. Dù đó không phải hành vi mặc định như trong trường hợp chồng lấn không đều, deconvolution chồng lấn đều vẫn rất dễ tạo artefact.
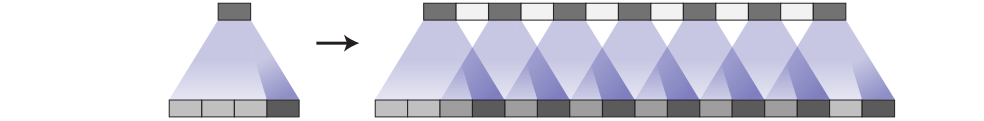
Tránh artefact hoàn toàn vẫn là một ràng buộc đáng kể lên bộ lọc, và trong thực tế artefact vẫn xuất hiện trong các mô hình này, dù có vẻ nhẹ hơn. Xem , dùng deconvolution stride 2 size 4, như một ví dụ.
Có lẽ có nhiều yếu tố cùng tác động. Ví dụ, trong Generative Adversarial Networks (GAN), một vấn đề có thể nằm ở discriminator và gradient của nó, điều ta sẽ bàn sau. Nhưng phần lớn vấn đề dường như nằm ở deconvolution. Ở mức tốt nhất, deconvolution mong manh vì nó rất dễ biểu diễn các hàm tạo artefact, ngay cả khi kích thước được chọn cẩn thận. Ở mức tệ nhất, tạo artefact là hành vi mặc định của deconvolution.
Có cách upsample nào khác chống artefact tốt hơn không?
Upsampling tốt hơn
Để tránh các artefact này, ta muốn một lựa chọn thay thế cho deconvolution thông thường, tức "transposed convolution". Khác với deconvolution, cách upsampling này không nên mặc định tạo artefact. Lý tưởng hơn, nó nên có thiên hướng chống lại các artefact đó.
Một cách là bảo đảm bạn dùng kích thước kernel chia hết cho stride, tránh vấn đề chồng lấn. Điều này tương đương với "sub-pixel convolution", một kỹ thuật gần đây thành công trong siêu phân giải ảnh . Tuy nhiên, dù cách này hữu ích, deconvolution vẫn dễ rơi vào việc tạo artefact.
Một cách khác là tách upsampling lên độ phân giải cao hơn khỏi convolution dùng để tính đặc trưng. Ví dụ, bạn có thể resize ảnh bằng nội suy nearest-neighbor hoặc nội suy bilinear, rồi sau đó dùng một lớp convolution. Đây có vẻ là cách tự nhiên, và các phương pháp gần tương tự đã hoạt động tốt trong siêu phân giải ảnh, chẳng hạn .
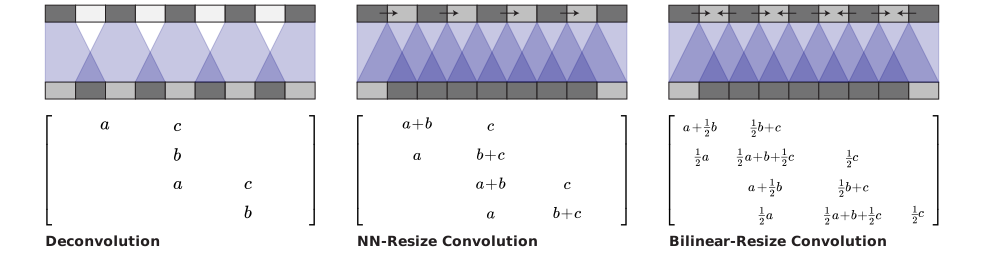
Cả deconvolution lẫn các cách resize-convolution đều là phép toán tuyến tính, và có thể diễn giải như ma trận. Đây là một cách hữu ích để thấy sự khác nhau giữa chúng. Trong khi deconvolution có một entry riêng cho mỗi cửa sổ đầu ra, resize-convolution ngầm buộc chia sẻ trọng số theo cách làm nản lòng artefact tần số cao.
Chúng tôi đạt kết quả tốt nhất với nội suy nearest-neighbor, và gặp khó khăn khi làm bilinear resize hoạt động tốt. Điều này có thể đơn giản là, với mô hình của chúng tôi, nearest-neighbor tình cờ phù hợp với các siêu tham số đã tối ưu cho deconvolution. Nó cũng có thể chỉ ra các vấn đề khó hơn khi dùng bilinear interpolation một cách ngây thơ, vì nó chống lại đặc trưng ảnh tần số cao quá mạnh. Chúng tôi không nhất thiết nghĩ một trong hai cách là lời giải cuối cùng cho upsampling, nhưng chúng thật sự sửa được artefact bàn cờ.
Mã nguồn
Các lớp resize-convolution có thể được triển khai dễ dàng trong TensorFlow bằng tf.image.resize_images(). Để có kết quả tốt nhất, dùng tf.pad() trước khi convolution với tf.nn.conv2d() để tránh artefact ở biên.
Kết quả sinh ảnh
Kinh nghiệm của chúng tôi là nearest-neighbor resize theo sau bởi convolution hoạt động rất tốt trong nhiều bối cảnh.
Một trường hợp mà chúng tôi thấy cách này hữu ích là Generative Adversarial Networks. Chỉ cần thay các lớp deconvolution tiêu chuẩn bằng nearest-neighbor resize rồi convolution, các artefact ở nhiều tần số khác nhau biến mất.
Deconv in last two layers.
Other layers use resize-convolution.
Artifacts of frequency 2 and 4.
Deconv only in last layer.
Other layers use resize-convolution.
Artifacts of frequency 2.
All layers use resize-convolution.
No artifacts.
Thực ra, khác biệt về artefact có thể thấy ngay cả trước khi huấn luyện. Nếu nhìn các ảnh generator tạo ra khi khởi tạo với trọng số ngẫu nhiên, ta đã thấy artefact:
Deconvolution in last two layers.
Artifacts prior to any training.
Deconvolution only in last layer.
Artifacts prior to any training.
All layers use resize-convolution.
No artifacts before or after training.
Điều này gợi ý rằng artefact đến từ chính phương pháp sinh ảnh, chứ không phải từ huấn luyện đối kháng. Nó cũng gợi ý rằng ta có thể học được nhiều điều về thiết kế generator tốt mà không cần vòng phản hồi chậm của việc huấn luyện mô hình.
Một lý do khác để tin rằng các artefact này không riêng gì GAN là ta thấy chúng trong các loại mô hình khác, và thấy rằng chúng cũng biến mất khi chuyển sang upsampling bằng resize-convolution. Ví dụ, xét style transfer nghệ thuật thời gian thực, nơi một mạng nơ-ron được huấn luyện để trực tiếp sinh ảnh đã chuyển style. Chúng tôi thấy chúng dễ bị artefact bàn cờ, đặc biệt khi hàm chi phí không chống lại artefact một cách tường minh. Tuy nhiên, thay các lớp deconvolution bằng resize-convolution làm artefact biến mất.
Using deconvolution.
Heavy checkerboard artifacts.
Using resize-convolution.
No checkerboard artifacts.
Các bài báo sắp tới từ nhóm Google Brain sẽ trình bày lợi ích của kỹ thuật này trong các thí nghiệm kỹ hơn và kết quả state-of-the-art. Chúng tôi chọn trình bày kỹ thuật này riêng vì cảm thấy nó xứng đáng được thảo luận chi tiết hơn, và vì nó cắt ngang nhiều bài báo.
Artefact trong gradient
Bất cứ khi nào ta tính gradient của một lớp convolution, ta thực hiện deconvolution, tức transposed convolution, ở lượt truyền ngược. Điều này có thể tạo mẫu bàn cờ trong gradient, giống như khi ta dùng deconvolution để sinh ảnh.
Sự hiện diện của "nhiễu" tần số cao trong gradient của mô hình ảnh đã được biết trong cộng đồng trực quan hóa đặc trưng, nơi nó là một thách thức lớn. Bằng cách nào đó, các phương pháp trực quan hóa đặc trưng phải bù trừ nhiễu này.
Ví dụ, DeepDream dường như gây triệt tiêu giữa các artefact theo nhiều cách, như tối ưu nhiều đặc trưng đồng thời, và tối ưu ở nhiều offset và thang đo. Cụ thể, "jitter" khi tối ưu ở các offset khác nhau triệt tiêu một phần artefact bàn cờ.
DeepDream only applying the neural network to a fixed position.
Severe artifacts.
DeepDream applying the network to a different position each step.
Reduced artifacts.
Một số artefact là mẫu bàn cờ tiêu chuẩn của ta, nhưng số khác là mẫu tần số cao ít có tổ chức hơn. Chúng tôi tin rằng chúng do max pooling gây ra. Max pooling từng được liên hệ với artefact tần số cao trong .
Các công trình gần đây hơn trong trực quan hóa đặc trưng, chẳng hạn , đã nhận ra rõ ràng và bù trừ các thành phần gradient tần số cao này. Ta có thể tự hỏi liệu kiến trúc mạng nơ-ron tốt hơn có làm các nỗ lực đó trở nên không cần thiết hay không.
Các artefact gradient này có ảnh hưởng đến GAN không? Nếu artefact gradient có thể ảnh hưởng tới một ảnh đang được tối ưu dựa trên gradient của mạng nơ-ron trong trực quan hóa đặc trưng, ta cũng có thể kỳ vọng nó ảnh hưởng tới họ ảnh được generator tham số hóa khi chúng được discriminator tối ưu trong GAN.
Chúng tôi thấy điều này thật sự xảy ra trong một số trường hợp. Khi generator không thiên về cũng không chống lại mẫu bàn cờ, strided convolution trong discriminator có thể gây ra chúng.
Discriminator has stride 2 convolution in first layer.
Strong frequency 2 artifacts.
Discriminator has regular convolution in first layer.
Very mild artifacts.
Chưa rõ các hệ quả rộng hơn của artefact gradient là gì. Một cách nghĩ về chúng là một số neuron sẽ nhận gradient lớn gấp nhiều lần các lân cận của chúng, gần như tùy tiện. Tương đương, mạng sẽ quan tâm tới một số pixel trong đầu vào nhiều hơn hẳn các pixel khác mà không có lý do tốt. Cả hai điều đó đều không lý tưởng.
Có thể việc một số pixel ảnh hưởng tới đầu ra mạng nhiều hơn các pixel khác sẽ khuếch đại các phản ví dụ đối kháng. Vì đạo hàm tập trung vào một số ít pixel, nhiễu nhỏ trên các pixel đó có thể có tác động quá mức. Chúng tôi chưa khảo sát điều này.
Kết luận
Cách tiếp cận tiêu chuẩn để tạo ảnh bằng deconvolution, dù có nhiều thành công, có một số vấn đề rất đơn giản về mặt khái niệm dẫn tới artefact trong ảnh sinh ra. Dùng một lựa chọn thay thế tự nhiên không có các vấn đề này làm artefact biến mất. Các lập luận tương tự gợi ý rằng các lớp strided convolution tiêu chuẩn cũng có thể có vấn đề.
Đây có vẻ là một cơ hội thú vị đối với chúng tôi. Nó gợi ý rằng vẫn còn những thành quả dễ hái trong việc suy nghĩ cẩn thận về kiến trúc mạng nơ-ron, ngay cả với những kiến trúc mà ta tưởng đã có lời giải hoạt động sạch sẽ.
Trong lúc đó, chúng tôi đã cung cấp một lời giải dễ dùng giúp cải thiện chất lượng của nhiều cách sinh ảnh bằng mạng nơ-ron. Chúng tôi mong chờ xem mọi người sẽ làm gì với nó, và liệu nó có giúp trong các miền như âm thanh, nơi artefact tần số cao đặc biệt gây vấn đề hay không.