Bốn Thí Nghiệm với Mạng Nơ-ron Viết Tay
Hãy bắt đầu bằng việc sinh nét chữ mới dựa trên nét viết tay bạn nhập vào.
Mạng nơ-ron là một cách tiếp cận cực kỳ thành công trong học máy, nhưng rất khó hiểu vì sao chúng hành xử như vậy. Điều này đã tạo ra nhiều quan tâm và nỗ lực nhằm hiểu và trực quan hóa chúng; chúng tôi nghĩ rằng cho tới nay ta mới chỉ chạm vào bề mặt của những gì có thể làm được.
Trong bài viết này, chúng tôi thử đẩy hướng đó tiến thêm bằng cách lấy một mô hình sinh chữ viết tayMô hình dùng trong bài này là một phiên bản của mô hình được mô tả ở Mục 4.2 của bài Generating Sequences With Recurrent Neural Network của Alex Graves . Đó là một LSTM nhỏ, có 500 hidden units, được huấn luyện cho nhiệm vụ sinh chữ viết tay vô điều kiện. Để xem mô tả chi tiết về mô hình và quy trình huấn luyện, hãy tham khảo bài blog này cùng với bài của Graves. Sau khi huấn luyện LSTM, chúng tôi lượng tử hóa trọng số bằng số nguyên 8-bit và xuất trọng số sang một tệp nhỏ định dạng JSON-Base64. rồi trực quan hóa nó theo nhiều cách. Mô hình khá đơn giản để chạy tốt trong trình duyệt, nên đầu ra được sinh chủ yếu là các chữ và từ vô nghĩa, dù trông giống chữ viết tay thật. Tuy vậy, nó vẫn hữu ích cho mục đích khám phá các kỹ thuật trực quan hóa.
Cuối cùng, chúng tôi không có một câu trả lời hay một trực quan hóa tối hậu nào, nhưng có một số ý tưởng thú vị để chia sẻ. Chúng tôi hy vọng chúng giúp việc rút ra ý nghĩa từ bên trong các mô hình này trở nên dễ hơn.
Nhìn vào đầu ra của mô hình
Thí nghiệm đầu tiên là cách hiển nhiên nhất: khi muốn xem ai đó học một nhiệm vụ tốt đến đâu, ta thường yêu cầu họ trình diễn. Vì vậy, hãy yêu cầu mô hình viết gì đó cho ta và xem nó làm tốt đến mức nào.
Phần lớn các nét là vô nghĩa, nhưng nhiều nét lại thuyết phục một cách đáng ngạc nhiên. Một số từ thật hoặc gần như thật thậm chí bắt đầu xuất hiện. Một điều đáng chú ý là phong cách chữ viết tổng thể ít nhiều nhất quán trong mỗi mẫu. Lý do là kiểu kiến trúc dùng cho mô hình này, LSTM, có cơ chế ghi nhớ các nét trước đó. Vì vậy nó có thể nhớ những điều như chữ viết vòng vèo hay gãy khúc ra sao, hoặc chữ cái nào đứng trước chữ hiện tại. Chris Olah có một bài nhập môn hay về LSTM và cách chúng ghi nhớ .
Ngay cả với bộ nhớ này, kỹ thuật sinh mẫu từ mạng nơ-ron vẫn mang tính xác suất, nghĩa là mỗi mẫu chỉ là một trong không gian khả năng lớn hơn rất nhiều. Xem từng mẫu một tạo cảm giác chưa thỏa đáng: làm sao ta suy luận được nhiều từ một hoặc hai mẫu khi có gần như vô hạn khả năng? Nếu thứ gì đó trông sai, làm sao biết đó là vì mô hình có vấn đề căn bản hay chỉ là xui rủi?
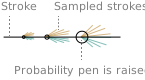
Ở mỗi vòng lặp, mô hình có thể tạo ra nhiều đường đi. Thay vì chọn một đường rồi bỏ phần còn lại, hãy vẽ, chẳng hạn, 50 đường. Các nét màu xanh bên dưới là những nơi mô hình có thể rẽ sang phải so với nét đã chọn, còn màu cam là nơi nó có thể rẽ sang trái.
Với kỹ thuật này, ta đang chiếu sáng một vùng rộng hơn của không gian khả năng. Bạn có thể thấy một số vùng nơi mô hình có đồng thuận chung về việc nên làm tiếp theo. Những vùng khác có cảm giác "bất cứ điều gì cũng có thể xảy ra". Một số vùng dường như cho thấy một ngã rẽ: ta có thể đang vẽ chữ "a" hoặc "g". Vài bước sau, rõ ràng mô hình đã hội tụ về chữ "g" viết liền.
Ngoài việc trực quan hóa các mẫu do mô hình sinh ra, kỹ thuật này cũng có thể áp dụng cho mẫu do con người tạo. Bên dưới, ta có thể thấy mô hình sẽ làm gì tại từng điểm nếu nó tiếp quản từ người viết.
Từ các thí nghiệm này, rõ ràng mô hình đã học được khá nhiều về chữ viết tay của con người. Điều đó đặt ra câu hỏi: ta có thể trích xuất tri thức đó theo một cách có ý nghĩa nào không, thay vì chỉ dùng mù quáng để bắt chước chữ viết?
Khảo sát bên trong mô hình
Mô hình của chúng ta có 500 cell, hoạt động như một dạng bộ nhớ mà nó dùng như một phần đầu vào khi quyết định sinh gì tiếp theo. Nếu có thể thấy các cell đó hoạt động ra sao khi mô hình tiến triển, ta có thể có trực giác về việc mô hình đang làm gì.
Ta bắt đầu bằng cách hiển thị activation của các cell theo thời gian. Mỗi cột trong heatmap bên dưới biểu diễn một đoạn thẳng của chữ viết tay. Mỗi hàng biểu diễn một cell của mô hình và được tô màu theo activation của cell đó trên phần nét tương ứng. Khi quan sát sơ đồ, bạn có thể thấy một số mẫu trong cách một số cell kích hoạt cho các loại nét nhất định. Bạn có thể thay đổi cell dùng để tô màu nét bằng cách nhấp vào sơ đồ.
Bạn có thể đã chọn được một hoặc hai cell có mẫu thú vị, nhưng chúng tôi có lý do để tin rằng các cell hoạt động theo nhóm, nên hoạt động của một cell riêng lẻ có thể không thú vị bằng hoạt động của một nhóm cell.
Có cách nào sắp xếp các cell để cấu trúc này rõ hơn không? Chúng tôi thấy rằng áp dụng t-SNE một chiều lên activation của các cell theo thời gian có thể tổ chức chúng, đưa các cell có hành vi tương tự lại gần nhau. Điều này làm sơ đồ dễ đọc hơn. Chúng tôi dùng vài mẹo nhỏ để đạt kết quả tốt nhất.Chúng tôi dùng hai mẹo khác nhau để việc tổ chức neuron bằng t-SNE hoạt động tốt hơn. Thứ nhất, nếu trạng thái cell phần lớn là âm, chúng tôi chuẩn hóa bằng cách đổi dấu nó. Từ góc nhìn của LSTM, điều này hoàn toàn tương đương, miễn là ta đổi dấu một số trọng số. Dấu của trạng thái cell là tùy ý. Thứ hai, chúng tôi thử dùng các metric khác nhau trên các điểm trong tập dữ liệu cho t-SNE, khuyến khích nó đặt những điểm ta xem là tương tự ở gần nhau. Chúng tôi đạt kết quả tốt khi dựa metric trên dữ liệu làm mờ, để các cell lệch tiến hoặc lùi một bước vẫn gần nhau, và một metric Sobolev làm mờ để khuyến khích các thay đổi sắc nét thẳng hàng. Kết quả trình bày trong bài còn tốt hơn một chút nhờ tạo metric dựa trên percentile của activation cell trong một lân cận. Xem `bin/sort` trong repository để biết chi tiết.
Trong phiên bản này, ta có thể tìm thấy vài hành vi rõ ràng. Ví dụ, các cell 11-70 ở phía trên dường như nhạy với các hướng và độ cong hơi khác nhau của đường bút, đặc biệt là cell 25 và 55. Ngược lại, ở phía dưới, các cell dưới 427 dường như tập trung vào nhấc bút; ví dụ, cell 494 có vẻ dự đoán liệu bút sắp được nhấc lên hay không. Ở giữa, ta thấy nhiều loại cell, bao gồm một số cell theo dõi vị trí tuyệt đối. Cell 136 và các lân cận có vẻ quan tâm tới vị trí ngang, trong khi các cell quanh 236 quan tâm tới vị trí dọc. Cell 242 dường như theo dõi vị trí bên trong một từ.
Một cách khác để khám phá activation là đưa cho mô hình một mẫu và xem activation tương tác. Bên dưới, bạn có thể viết và xem activation của tất cả cell theo thời gian thực.
Kết luận
Danh tiếng "hộp đen" của các mô hình học máy là có cơ sở, nhưng chúng tôi tin một phần danh tiếng đó sinh ra từ bối cảnh lập trình mà chúng bị khóa trong đó. Trải nghiệm có một mô hình dễ kiểm tra trong cùng bối cảnh lập trình với môi trường trực quan hóa tương tác, ở đây là JavaScript, tỏ ra rất hiệu quả cho việc tạo mẫu và khám phá ý tưởng mới cho bài viết này.
Khi ta có thể đưa các mô hình ngày càng nhiều vào cùng bối cảnh lập trình nơi công việc giao diện người dùng diễn ra, chúng tôi tin rằng các hình thức tương tác người-AI phong phú hơn sẽ nở rộ. Điều này chắc chắn có thể tác động rõ rệt tới việc gỡ lỗi và xây dựng mô hình, nhưng cũng ảnh hưởng tới cách mô hình được sử dụng. Nghiên cứu học máy thường tìm cách bắt chước và thay thế con người, và ngày càng làm được điều đó. Điều có vẻ ít được khám phá hơn là dùng học máy để tăng cường con người. Kiểu tương tác người-máy phức tạp này được khám phá tốt nhất khi toàn bộ năng lực của mô hình có sẵn trong bối cảnh giao diện người dùng.