Spanner: Google's Globally-Distributed Database
Google, Inc.
Abstract
Spanner is Google’s scalable, multi-version, globally-distributed, and synchronously-replicated database. It is the first system to distribute data at global scale and support externally-consistent distributed transactions. This paper describes how Spanner is structured, its feature set, the rationale underlying various design decisions, and a novel time API that exposes clock uncertainty. This API and its implementation are critical to supporting external consistency and a variety of powerful features: non-blocking reads in the past, lock-free read-only transactions, and atomic schema changes, across all of Spanner.
Spanner: Cơ sở dữ liệu phân tán toàn cầu của Google
James C. Corbett, Jeffrey Dean, Michael Epstein, Andrew Fikes, Christopher Frost, JJ Furman, Sanjay Ghemawat, Andrey Gubarev, Christopher Heiser, Peter Hochschild, Wilson Hsieh, Sebastian Kanthak, Eugene Kogan, Hongyi Li, Alexander Lloyd, Sergey Melnik, David Mwaura, David Nagle, Sean Quinlan, Rajesh Rao, Lindsay Rolig, Yasushi Saito, Michal Szymaniak, Christopher Taylor, Ruth Wang, Dale Woodford
Google, Inc.
Tóm tắt
Spanner là cơ sở dữ liệu có khả năng mở rộng, đa phiên bản, phân tán toàn cầu và được sao chép đồng bộ của Google. Đây là hệ thống đầu tiên phân phối dữ liệu ở quy mô toàn cầu và hỗ trợ các giao dịch phân tán có tính nhất quán bên ngoài. Bài báo này mô tả cách Spanner được cấu trúc, tập tính năng của nó, cơ sở lý luận đằng sau các quyết định thiết kế khác nhau, và một API thời gian mới cung cấp khả năng hiển thị độ không chắc chắn của đồng hồ. API này cùng với việc triển khai của nó là yếu tố then chốt để hỗ trợ tính nhất quán bên ngoài và một loạt tính năng mạnh mẽ: đọc không chặn trong quá khứ, các giao dịch chỉ đọc không khóa, và các thay đổi lược đồ nguyên tử, trên toàn bộ Spanner.
1 Introduction
1 Giới thiệu
Spanner is a scalable, globally-distributed database designed, built, and deployed at Google. At the highest level of abstraction, it is a database that shards data across many sets of Paxos [21] state machines in datacenters spread all over the world. Replication is used for global availability and geographic locality; clients automatically failover between replicas. Spanner automatically reshards data across machines as the amount of data or the number of servers changes, and it automatically migrates data across machines (even across datacenters) to balance load and in response to failures. Spanner is designed to scale up to millions of machines across hundreds of datacenters and trillions of database rows.
Spanner là một cơ sở dữ liệu có khả năng mở rộng, phân tán toàn cầu, được thiết kế, xây dựng và triển khai tại Google. Ở mức trừu tượng cao nhất, nó là một cơ sở dữ liệu phân mảnh dữ liệu trên nhiều tập hợp máy trạng thái Paxos [21] tại các datacenter trải rộng khắp thế giới. Sao chép được sử dụng để cung cấp tính sẵn sàng toàn cầu và tính cục bộ theo địa lý; các máy khách tự động chuyển đổi dự phòng giữa các bản sao. Spanner tự động phân mảnh lại dữ liệu trên các máy khi lượng dữ liệu hoặc số lượng server thay đổi, và nó tự động di chuyển dữ liệu giữa các máy (kể cả giữa các datacenter) để cân bằng tải và phản ứng với các sự cố. Spanner được thiết kế để mở rộng tới hàng triệu máy trên hàng trăm datacenter và hàng nghìn tỷ hàng cơ sở dữ liệu.
Applications can use Spanner for high availability, even in the face of wide-area natural disasters, by replicating their data within or even across continents. Our initial customer was F1 [35], a rewrite of Google’s advertising backend. F1 uses five replicas spread across the United States. Most other applications will probably replicate their data across 3 to 5 datacenters in one geographic region, but with relatively independent failure modes. That is, most applications will choose lower latency over higher availability, as long as they can survive 1 or 2 datacenter failures.
Các ứng dụng có thể sử dụng Spanner để đạt tính sẵn sàng cao, ngay cả khi xảy ra các thảm họa tự nhiên trên diện rộng, bằng cách sao chép dữ liệu của chúng trong phạm vi hoặc thậm chí giữa các lục địa. Khách hàng ban đầu của chúng tôi là F1 [35], một bản viết lại của backend quảng cáo của Google. F1 sử dụng năm bản sao trải rộng trên Hoa Kỳ. Hầu hết các ứng dụng khác có lẽ sẽ sao chép dữ liệu của chúng trên 3 đến 5 datacenter trong một vùng địa lý, nhưng với các chế độ sự cố tương đối độc lập. Nghĩa là, hầu hết các ứng dụng sẽ chọn độ trễ thấp hơn thay vì tính sẵn sàng cao hơn, miễn là chúng có thể chịu được 1 hoặc 2 sự cố datacenter.
Spanner’s main focus is managing cross-datacenter replicated data, but we have also spent a great deal of time in designing and implementing important database features on top of our distributed-systems infrastructure. Even though many projects happily use Bigtable [9], we have also consistently received complaints from users that Bigtable can be difficult to use for some kinds of applications: those that have complex, evolving schemas, or those that want strong consistency in the presence of wide-area replication. (Similar claims have been made by other authors [37].) Many applications at Google have chosen to use Megastore [5] because of its semi-relational data model and support for synchronous replication, despite its relatively poor write throughput. As a consequence, Spanner has evolved from a Bigtable-like versioned key-value store into a temporal multi-version database. Data is stored in schematized semi-relational tables; data is versioned, and each version is automatically timestamped with its commit time; old versions of data are subject to configurable garbage-collection policies; and applications can read data at old timestamps. Spanner supports general-purpose transactions, and provides a SQL-based query language.
Trọng tâm chính của Spanner là quản lý dữ liệu được sao chép xuyên datacenter, nhưng chúng tôi cũng đã dành rất nhiều thời gian để thiết kế và triển khai các tính năng cơ sở dữ liệu quan trọng trên nền tảng hạ tầng hệ thống phân tán của mình. Mặc dù nhiều dự án sử dụng Bigtable [9] một cách hiệu quả, chúng tôi cũng liên tục nhận được các phàn nàn từ người dùng rằng Bigtable có thể khó sử dụng đối với một số loại ứng dụng: những ứng dụng có lược đồ phức tạp, thay đổi theo thời gian, hoặc những ứng dụng muốn có tính nhất quán mạnh trong sự hiện diện của sao chép trên diện rộng. (Các nhận định tương tự đã được các tác giả khác đưa ra [37].) Nhiều ứng dụng tại Google đã chọn sử dụng Megastore [5] vì mô hình dữ liệu bán quan hệ và hỗ trợ sao chép đồng bộ của nó, mặc dù thông lượng ghi tương đối kém. Do đó, Spanner đã phát triển từ một kho lưu trữ khóa-giá trị có phiên bản giống Bigtable thành một cơ sở dữ liệu đa phiên bản theo thời gian. Dữ liệu được lưu trữ trong các bảng bán quan hệ có lược đồ; dữ liệu được tạo phiên bản, và mỗi phiên bản được tự động gán dấu thời gian với thời điểm xác nhận của nó; các phiên bản dữ liệu cũ chịu sự điều chỉnh của các chính sách thu gom rác có thể cấu hình; và các ứng dụng có thể đọc dữ liệu tại các dấu thời gian cũ. Spanner hỗ trợ các giao dịch mục đích chung, và cung cấp một ngôn ngữ truy vấn dựa trên SQL.
As a globally-distributed database, Spanner provides several interesting features. First, the replication configurations for data can be dynamically controlled at a fine grain by applications. Applications can specify constraints to control which datacenters contain which data, how far data is from its users (to control read latency), how far replicas are from each other (to control write latency), and how many replicas are maintained (to control durability, availability, and read performance). Data can also be dynamically and transparently moved between datacenters by the system to balance resource usage across datacenters. Second, Spanner has two features that are difficult to implement in a distributed database: it provides externally consistent [16] reads and writes, and globally-consistent reads across the database at a timestamp. These features enable Spanner to support consistent backups, consistent MapReduce executions [12], and atomic schema updates, all at global scale, and even in the presence of ongoing transactions.
Là một cơ sở dữ liệu phân tán toàn cầu, Spanner cung cấp một số tính năng thú vị. Thứ nhất, các cấu hình sao chép cho dữ liệu có thể được các ứng dụng điều khiển động với mức độ chi tiết cao. Các ứng dụng có thể chỉ định các ràng buộc để kiểm soát datacenter nào chứa dữ liệu nào, dữ liệu cách người dùng bao xa (để kiểm soát độ trễ đọc), các bản sao cách nhau bao xa (để kiểm soát độ trễ ghi), và có bao nhiêu bản sao được duy trì (để kiểm soát độ bền, tính sẵn sàng và hiệu năng đọc). Dữ liệu cũng có thể được hệ thống di chuyển động và minh bạch giữa các datacenter để cân bằng việc sử dụng tài nguyên trên các datacenter. Thứ hai, Spanner có hai tính năng khó triển khai trong một cơ sở dữ liệu phân tán: nó cung cấp các thao tác đọc và ghi nhất quán bên ngoài [16], và các thao tác đọc nhất quán toàn cục trên cơ sở dữ liệu tại một dấu thời gian. Các tính năng này cho phép Spanner hỗ trợ sao lưu nhất quán, các lần thực thi MapReduce nhất quán [12], và các cập nhật lược đồ nguyên tử, tất cả ở quy mô toàn cầu, ngay cả khi có các giao dịch đang diễn ra.
These features are enabled by the fact that Spanner assigns globally-meaningful commit timestamps to transactions, even though transactions may be distributed. The timestamps reflect serialization order. In addition, the serialization order satisfies external consistency (or equivalently, linearizability [20]): if a transaction commits before another transaction starts, then 's commit timestamp is smaller than 's. Spanner is the first system to provide such guarantees at global scale.
Các tính năng này được hỗ trợ bởi thực tế rằng Spanner gán các dấu thời gian xác nhận có ý nghĩa toàn cầu cho các giao dịch, mặc dù các giao dịch có thể được phân tán. Các dấu thời gian phản ánh thứ tự tuần tự hóa. Ngoài ra, thứ tự tuần tự hóa thỏa mãn tính nhất quán bên ngoài (hoặc tương đương, tính tuyến tính hóa [20]): nếu một giao dịch xác nhận trước khi một giao dịch khác bắt đầu, thì dấu thời gian xác nhận của nhỏ hơn của . Spanner là hệ thống đầu tiên cung cấp các đảm bảo như vậy ở quy mô toàn cầu.
The key enabler of these properties is a new TrueTime API and its implementation. The API directly exposes clock uncertainty, and the guarantees on Spanner’s timestamps depend on the bounds that the implementation provides. If the uncertainty is large, Spanner slows down to wait out that uncertainty. Google’s cluster-management software provides an implementation of the TrueTime API. This implementation keeps uncertainty small (generally less than 10ms) by using multiple modern clock references (GPS and atomic clocks).
Yếu tố then chốt cho các tính chất này là một API TrueTime mới và phần triển khai của nó. API này trực tiếp phơi bày sự không chắc chắn của đồng hồ, và các đảm bảo trên các dấu thời gian của Spanner phụ thuộc vào các cận mà phần triển khai cung cấp. Nếu độ không chắc chắn lớn, Spanner sẽ giảm tốc độ để chờ hết khoảng không chắc chắn đó. Phần mềm quản lý cụm của Google cung cấp một triển khai của API TrueTime. Triển khai này giữ cho độ không chắc chắn nhỏ (thường nhỏ hơn 10ms) bằng cách sử dụng nhiều tham chiếu đồng hồ hiện đại (GPS và đồng hồ nguyên tử).
Section 2 describes the structure of Spanner’s implementation, its feature set, and the engineering decisions that went into their design. Section 3 describes our new TrueTime API and sketches its implementation. Section 4 describes how Spanner uses TrueTime to implement externally-consistent distributed transactions, lock-free read-only transactions, and atomic schema updates. Section 5 provides some benchmarks on Spanner’s performance and TrueTime behavior, and discusses the experiences of F1. Sections 6, 7, and 8 describe related and future work, and summarize our conclusions.
Section 2 mô tả cấu trúc triển khai của Spanner, tập tính năng của nó, và các quyết định kỹ thuật đã đưa vào thiết kế của chúng. Section 3 mô tả API TrueTime mới của chúng tôi và phác thảo phần triển khai của nó. Section 4 mô tả cách Spanner sử dụng TrueTime để triển khai các giao dịch phân tán nhất quán bên ngoài, các giao dịch chỉ đọc không khóa, và các cập nhật lược đồ nguyên tử. Section 5 cung cấp một số phép đo chuẩn về hiệu năng của Spanner và hành vi của TrueTime, đồng thời thảo luận về các kinh nghiệm của F1. Sections 6, 7, and 8 mô tả công việc liên quan và trong tương lai, đồng thời tóm tắt các kết luận của chúng tôi.
2 Implementation
2 Triển khai
This section describes the structure of and rationale underlying Spanner’s implementation. It then describes the directory abstraction, which is used to manage replication and locality, and is the unit of data movement. Finally, it describes our data model, why Spanner looks like a relational database instead of a key-value store, and how applications can control data locality.
Phần này mô tả cấu trúc và cơ sở lý giải cho cách triển khai Spanner. Tiếp đó, phần này mô tả trừu tượng hóa thư mục (directory), được dùng để quản lý sao chép và tính cục bộ của dữ liệu, đồng thời là đơn vị di chuyển dữ liệu. Cuối cùng, phần này mô tả mô hình dữ liệu của chúng tôi, lý do Spanner có dạng một cơ sở dữ liệu quan hệ thay vì một kho khóa-giá trị, và cách các ứng dụng có thể kiểm soát tính cục bộ của dữ liệu.
A Spanner deployment is called a universe. Given that Spanner manages data globally, there will be only a handful of running universes. We currently run a test/playground universe, a development/production universe, and a production-only universe.
Một bản triển khai Spanner được gọi là một vũ trụ (universe). Do Spanner quản lý dữ liệu trên toàn cầu, sẽ chỉ có một số ít vũ trụ đang hoạt động. Hiện chúng tôi vận hành một vũ trụ dành cho kiểm thử/thử nghiệm, một vũ trụ dành cho phát triển/vận hành thực tế, và một vũ trụ chỉ dành cho vận hành thực tế.
Spanner is organized as a set of zones, where each zone is the rough analog of a deployment of Bigtable servers [9]. Zones are the unit of administrative deployment. The set of zones is also the set of locations across which data can be replicated. Zones can be added to or removed from a running system as new datacenters are brought into service and old ones are turned off, respectively. Zones are also the unit of physical isolation: there may be one or more zones in a datacenter, for example, if different applications’ data must be partitioned across different sets of servers in the same datacenter.
Spanner được tổ chức thành một tập hợp các vùng, trong đó mỗi vùng gần tương đương với một bản triển khai các server Bigtable [9]. Vùng là đơn vị triển khai về mặt quản trị. Tập hợp các vùng cũng là tập hợp các vị trí mà dữ liệu có thể được sao chép giữa chúng. Có thể thêm vùng vào hoặc loại bỏ vùng khỏi một hệ thống đang hoạt động khi các trung tâm dữ liệu mới được đưa vào sử dụng hoặc các trung tâm dữ liệu cũ ngừng hoạt động. Vùng cũng là đơn vị cách ly vật lý: một trung tâm dữ liệu có thể có một hoặc nhiều vùng, chẳng hạn khi dữ liệu của các ứng dụng khác nhau phải được phân vùng trên các tập hợp server khác nhau trong cùng trung tâm dữ liệu.
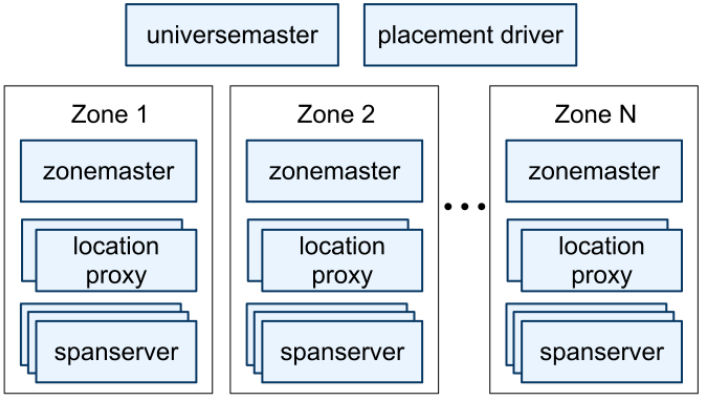
Figure 1 illustrates the servers in a Spanner universe. A zone has one zonemaster and between one hundred and several thousand spanservers. The former assigns data to spanservers; the latter serve data to clients. The per-zone location proxies are used by clients to locate the spanservers assigned to serve their data. The universe master and the placement driver are currently singletons. The universe master is primarily a console that displays status information about all the zones for interactive debugging. The placement driver handles automated movement of data across zones on the timescale of minutes. The placement driver periodically communicates with the spanservers to find data that needs to be moved, either to meet updated replication constraints or to balance load. For space reasons, we will only describe the spanserver in any detail.
Hình 1 minh họa các server trong một vũ trụ Spanner. Một vùng có một zonemaster và từ một trăm đến vài nghìn spanserver. Zonemaster phân công dữ liệu cho các spanserver; các spanserver phục vụ dữ liệu cho máy khách. Máy khách sử dụng các proxy định vị của từng vùng để tìm các spanserver được phân công phục vụ dữ liệu của mình. Hiện tại, bộ chủ quản vũ trụ và bộ điều khiển bố trí đều chỉ có một thực thể duy nhất. Bộ chủ quản vũ trụ chủ yếu là một bảng điều khiển hiển thị thông tin trạng thái về tất cả các vùng để gỡ lỗi tương tác. Bộ điều khiển bố trí xử lý việc tự động di chuyển dữ liệu giữa các vùng trên thang thời gian tính bằng phút. Bộ điều khiển bố trí định kỳ trao đổi với các spanserver để tìm dữ liệu cần di chuyển, nhằm đáp ứng các ràng buộc sao chép đã cập nhật hoặc để cân bằng tải. Do giới hạn dung lượng bài viết, chúng tôi chỉ mô tả chi tiết spanserver.
Figure.
Hình.
2.1 Spanserver Software Stack
2.1 Ngăn xếp phần mềm Spanserver
This section focuses on the spanserver implementation to illustrate how replication and distributed transactions have been layered onto our Bigtable-based implementation. The software stack is shown in Figure 2. At the bottom, each spanserver is responsible for between 100 and 1000 instances of a data structure called a tablet. A tablet is similar to Bigtable’s tablet abstraction, in that it implements a bag of the following mappings:
Phần này tập trung vào cách triển khai spanserver để minh họa cách sao chép và giao dịch phân tán được xây dựng thành các lớp trên bản triển khai dựa trên Bigtable của chúng tôi. Ngăn xếp phần mềm được trình bày trong Hình 2. Ở lớp dưới cùng, mỗi spanserver chịu trách nhiệm quản lý từ 100 đến 1000 thực thể của một cấu trúc dữ liệu gọi là tablet. Tablet tương tự trừu tượng hóa tablet của Bigtable ở chỗ nó triển khai một đa tập các ánh xạ sau:
(key:string, timestamp:int64) → string
(key:string, timestamp:int64) → string
Unlike Bigtable, Spanner assigns timestamps to data, which is an important way in which Spanner is more like a multi-version database than a key-value store. A tablet’s state is stored in set of B-tree-like files and a write-ahead log, all on a distributed file system called Colossus (the successor to the Google File System [15]).
Khác với Bigtable, Spanner gán dấu thời gian cho dữ liệu; đây là một điểm quan trọng khiến Spanner giống cơ sở dữ liệu đa phiên bản hơn là kho khóa-giá trị. Trạng thái của một tablet được lưu trong một tập hợp các file có dạng cây B và một nhật ký ghi trước (write-ahead log), tất cả đều nằm trên một hệ thống file phân tán có tên Colossus (hệ thống kế nhiệm Google File System [15]).
To support replication, each spanserver implements a single Paxos state machine on top of each tablet. (An early Spanner incarnation supported multiple Paxos state machines per tablet, which allowed for more flexible replication configurations. The complexity of that design led us to abandon it.) Each state machine stores its metadata and log in its corresponding tablet. Our Paxos implementation supports long-lived leaders with time-based leader leases, whose length defaults to 10 seconds. The current Spanner implementation logs every Paxos write twice: once in the tablet’s log, and once in the Paxos log. This choice was made out of expediency, and we are likely to remedy this eventually. Our implementation of Paxos is pipelined, so as to improve Spanner’s throughput in the presence of WAN latencies; but writes are applied by Paxos in order (a fact on which we will depend in Section 4).
Để hỗ trợ sao chép, mỗi spanserver triển khai một máy trạng thái Paxos duy nhất trên mỗi tablet. (Một phiên bản ban đầu của Spanner hỗ trợ nhiều máy trạng thái Paxos trên mỗi tablet, cho phép các cấu hình sao chép linh hoạt hơn. Độ phức tạp của thiết kế đó khiến chúng tôi từ bỏ nó.) Mỗi máy trạng thái lưu siêu dữ liệu và nhật ký trong tablet tương ứng. Bản triển khai Paxos của chúng tôi hỗ trợ các nút lãnh đạo tồn tại lâu dài với quyền lãnh đạo có thời hạn dựa trên thời gian, mặc định là 10 giây. Bản triển khai Spanner hiện tại ghi nhật ký mỗi thao tác ghi Paxos hai lần: một lần trong nhật ký của tablet và một lần trong nhật ký Paxos. Lựa chọn này nhằm thuận tiện cho việc triển khai, và nhiều khả năng chúng tôi sẽ khắc phục điều này về sau. Bản triển khai Paxos của chúng tôi sử dụng đường ống để cải thiện thông lượng của Spanner khi có độ trễ WAN; tuy nhiên, Paxos áp dụng các thao tác ghi theo thứ tự (một đặc điểm mà chúng tôi sẽ dựa vào trong Phần 4).
The Paxos state machines are used to implement a consistently replicated bag of mappings. The key-value mapping state of each replica is stored in its corresponding tablet. Writes must initiate the Paxos protocol at the leader; reads access state directly from the underlying tablet at any replica that is sufficiently up-to-date. The set of replicas is collectively a Paxos group.
Các máy trạng thái Paxos được dùng để triển khai một đa tập các ánh xạ được sao chép với tính nhất quán. Trạng thái ánh xạ khóa-giá trị của mỗi bản sao được lưu trong tablet tương ứng. Các thao tác ghi phải khởi tạo giao thức Paxos tại nút lãnh đạo; các thao tác đọc truy cập trạng thái trực tiếp từ tablet bên dưới tại bất kỳ bản sao nào đã được cập nhật đủ mới. Tập hợp các bản sao được gọi chung là một nhóm Paxos.
At every replica that is a leader, each spanserver implements a lock table to implement concurrency control. The lock table contains the state for two-phase locking: it maps ranges of keys to lock states. (Note that having a long-lived Paxos leader is critical to efficiently managing the lock table.) In both Bigtable and Spanner, we designed for long-lived transactions (for example, for report generation, which might take on the order of minutes), which perform poorly under optimistic concurrency control in the presence of conflicts. Operations that require synchronization, such as transactional reads, acquire locks in the lock table; other operations bypass the lock table.
Tại mỗi bản sao đóng vai trò lãnh đạo, mỗi spanserver triển khai một bảng khóa để thực hiện điều khiển đồng thời. Bảng khóa chứa trạng thái phục vụ khóa hai pha: nó ánh xạ các khoảng khóa tới các trạng thái khóa. (Lưu ý rằng việc có một nút lãnh đạo Paxos tồn tại lâu dài là thiết yếu để quản lý bảng khóa hiệu quả.) Trong cả Bigtable lẫn Spanner, chúng tôi thiết kế để hỗ trợ các giao dịch kéo dài (ví dụ, để tạo báo cáo, có thể mất khoảng vài phút), vốn có hiệu năng kém khi sử dụng điều khiển đồng thời lạc quan trong trường hợp có xung đột. Các thao tác cần đồng bộ hóa, chẳng hạn như đọc trong giao dịch, lấy khóa trong bảng khóa; các thao tác khác bỏ qua bảng khóa.
At every replica that is a leader, each spanserver also implements a transaction manager to support distributed transactions. The transaction manager is used to implement a participant leader; the other replicas in the group will be referred to as participant slaves. If a transaction involves only one Paxos group (as is the case for most transactions), it can bypass the transaction manager, since the lock table and Paxos together provide transactionality. If a transaction involves more than one Paxos group, those groups’ leaders coordinate to perform two-phase commit. One of the participant groups is chosen as the coordinator: the participant leader of that group will be referred to as the coordinator leader, and the slaves of that group as coordinator slaves. The state of each transaction manager is stored in the underlying Paxos group (and therefore is replicated).
Tại mỗi bản sao đóng vai trò lãnh đạo, mỗi spanserver còn triển khai một bộ quản lý giao dịch để hỗ trợ giao dịch phân tán. Bộ quản lý giao dịch được dùng để triển khai một nút lãnh đạo tham gia; các bản sao khác trong nhóm sẽ được gọi là các nút phụ tham gia. Nếu một giao dịch chỉ liên quan đến một nhóm Paxos (như trường hợp của phần lớn giao dịch), nó có thể bỏ qua bộ quản lý giao dịch, vì bảng khóa kết hợp với Paxos cung cấp các tính chất giao dịch. Nếu một giao dịch liên quan đến nhiều nhóm Paxos, các nút lãnh đạo của những nhóm đó phối hợp để thực hiện xác nhận hai pha. Một trong các nhóm tham gia được chọn làm bộ điều phối: nút lãnh đạo tham gia của nhóm đó sẽ được gọi là nút lãnh đạo điều phối, và các nút phụ của nhóm đó là các nút phụ điều phối. Trạng thái của mỗi bộ quản lý giao dịch được lưu trong nhóm Paxos bên dưới (và do đó được sao chép).
2.2 Directories and Placement
2.2 Thư mục và bố trí
On top of the bag of key-value mappings, the Spanner implementation supports a bucketing abstraction called a directory, which is a set of contiguous keys that share a common prefix. (The choice of the term directory is a historical accident; a better term might be bucket.) We will explain the source of that prefix in Section 2.3. Supporting directories allows applications to control the locality of their data by choosing keys carefully.
Trên tập hợp các ánh xạ khóa-giá trị, bản triển khai Spanner hỗ trợ một trừu tượng hóa gom nhóm gọi là thư mục (directory), tức một tập hợp các khóa liên tiếp có chung tiền tố. (Việc chọn thuật ngữ thư mục là một sự tình cờ trong lịch sử; thuật ngữ phù hợp hơn có thể là nhóm.) Chúng tôi sẽ giải thích nguồn gốc của tiền tố đó trong Mục 2.3. Việc hỗ trợ thư mục cho phép các ứng dụng kiểm soát tính cục bộ của dữ liệu bằng cách lựa chọn khóa cẩn thận.
A directory is the unit of data placement. All data in a directory has the same replication configuration. When data is moved between Paxos groups, it is moved directory by directory, as shown in Figure 3. Spanner might move a directory to shed load from a Paxos group; to put directories that are frequently accessed together into the same group; or to move a directory into a group that is closer to its accessors. Directories can be moved while client operations are ongoing. One could expect that a 50MB directory can be moved in a few seconds.
Thư mục là đơn vị bố trí dữ liệu. Toàn bộ dữ liệu trong một thư mục có cùng cấu hình sao chép. Khi dữ liệu được di chuyển giữa các nhóm Paxos, dữ liệu được di chuyển theo từng thư mục, như minh họa trong Hình 3. Spanner có thể di chuyển một thư mục để giảm tải cho một nhóm Paxos; để đặt các thư mục thường được truy cập cùng nhau vào cùng một nhóm; hoặc để chuyển một thư mục vào nhóm gần các bên truy cập thư mục đó hơn. Các thư mục có thể được di chuyển trong khi các thao tác của máy khách vẫn đang diễn ra. Có thể kỳ vọng rằng một thư mục 50MB được di chuyển trong vài giây.
The fact that a Paxos group may contain multiple directories implies that a Spanner tablet is different from a Bigtable tablet: the former is not necessarily a single lexicographically contiguous partition of the row space. Instead, a Spanner tablet is a container that may encapsulate multiple partitions of the row space. We made this decision so that it would be possible to colocate multiple directories that are frequently accessed together.
Việc một nhóm Paxos có thể chứa nhiều thư mục có nghĩa là tablet của Spanner khác với tablet của Bigtable: tablet của Spanner không nhất thiết là một phân vùng liên tiếp duy nhất theo thứ tự từ điển của không gian hàng. Thay vào đó, tablet của Spanner là một vùng chứa có thể bao gồm nhiều phân vùng của không gian hàng. Chúng tôi đưa ra quyết định này để có thể đặt nhiều thư mục thường được truy cập cùng nhau tại cùng một nơi.
Movedir is the background task used to move directories between Paxos groups [14]. Movedir is also used to add or remove replicas to Paxos groups [25], because Spanner does not yet support in-Paxos configuration changes. Movedir is not implemented as a single transaction, so as to avoid blocking ongoing reads and writes on a bulky data move. Instead, movedir registers the fact that it is starting to move data and moves the data in the background. When it has moved all but a nominal amount of the data, it uses a transaction to atomically move that nominal amount and update the metadata for the two Paxos groups.
Movedir là tác vụ nền được dùng để di chuyển các thư mục giữa các nhóm Paxos [14]. Movedir cũng được dùng để thêm bản sao vào hoặc loại bỏ bản sao khỏi các nhóm Paxos [25], vì Spanner chưa hỗ trợ thay đổi cấu hình ngay trong Paxos. Movedir không được triển khai dưới dạng một giao dịch duy nhất, nhằm tránh chặn các thao tác đọc và ghi đang diễn ra khi di chuyển một lượng lớn dữ liệu. Thay vào đó, movedir ghi nhận việc bắt đầu di chuyển dữ liệu và di chuyển dữ liệu trong nền. Khi đã di chuyển gần hết dữ liệu, chỉ còn lại một lượng nhỏ, nó sử dụng một giao dịch để di chuyển lượng nhỏ đó và cập nhật siêu dữ liệu cho hai nhóm Paxos một cách nguyên tử.
A directory is also the smallest unit whose geographic-replication properties (or placement, for short) can be specified by an application. The design of our placement-specification language separates responsibilities for managing replication configurations. Administrators control two dimensions: the number and types of replicas, and the geographic placement of those replicas. They create a menu of named options in these two dimensions (e.g., North America, replicated 5 ways with 1 witness). An application controls how data is replicated, by tagging each database and/or individual directories with a combination of those options. For example, an application might store each end-user’s data in its own directory, which would enable user ’s data to have three replicas in Europe, and user ’s data to have five replicas in North America.
Thư mục cũng là đơn vị nhỏ nhất mà ứng dụng có thể đặc tả các thuộc tính sao chép theo địa lý (hay gọi ngắn gọn là bố trí). Thiết kế ngôn ngữ đặc tả bố trí của chúng tôi phân tách các trách nhiệm quản lý cấu hình sao chép. Quản trị viên kiểm soát hai chiều: số lượng và kiểu bản sao, cùng với vị trí địa lý của các bản sao đó. Họ tạo một danh mục các tùy chọn có tên theo hai chiều này (ví dụ: Bắc Mỹ, sao chép thành 5 bản với 1 bản sao làm chứng). Ứng dụng kiểm soát cách sao chép dữ liệu bằng cách gắn thẻ cho từng cơ sở dữ liệu và/hoặc từng thư mục bằng một tổ hợp các tùy chọn đó. Ví dụ, một ứng dụng có thể lưu dữ liệu của mỗi người dùng cuối trong một thư mục riêng, nhờ đó dữ liệu của người dùng có thể có ba bản sao ở châu Âu, còn dữ liệu của người dùng có thể có năm bản sao ở Bắc Mỹ.
For expository clarity we have over-simplified. In fact, Spanner will shard a directory into multiple fragments if it grows too large. Fragments may be served from different Paxos groups (and therefore different servers). Movedir actually moves fragments, and not whole directories, between groups.
Để trình bày rõ ràng, chúng tôi đã đơn giản hóa quá mức. Trên thực tế, Spanner sẽ phân mảnh một thư mục thành nhiều mảnh nếu thư mục đó trở nên quá lớn. Các mảnh có thể được phục vụ từ những nhóm Paxos khác nhau (và do đó từ những server khác nhau). Movedir thực ra di chuyển các mảnh giữa các nhóm, chứ không phải toàn bộ thư mục.
2.3 Data Model
2.3 Mô hình dữ liệu
Spanner exposes the following set of data features to applications: a data model based on schematized semi-relational tables, a query language, and general-purpose transactions. The move towards supporting these features was driven by many factors. The need to support schematized semi-relational tables and synchronous replication is supported by the popularity of Megastore [5]. At least 300 applications within Google use Megastore (despite its relatively low performance) because its data model is simpler to manage than Bigtable’s, and because of its support for synchronous replication across datacenters. (Bigtable only supports eventually-consistent replication across datacenters.) Examples of well-known Google applications that use Megastore are Gmail, Picasa, Calendar, Android Market, and AppEngine. The need to support a SQL-like query language in Spanner was also clear, given the popularity of Dremel [28] as an interactive data-analysis tool. Finally, the lack of cross-row transactions in Bigtable led to frequent complaints; Percolator [32] was in part built to address this failing. Some authors have claimed that general two-phase commit is too expensive to support, because of the performance or availability problems that it brings [9, 10, 19]. We believe it is better to have application programmers deal with performance problems due to overuse of transactions as bottlenecks arise, rather than always coding around the lack of transactions. Running two-phase commit over Paxos mitigates the availability problems.
Spanner cung cấp cho các ứng dụng tập hợp tính năng dữ liệu sau: một mô hình dữ liệu dựa trên các bảng bán quan hệ có lược đồ, một ngôn ngữ truy vấn và các giao dịch đa dụng. Việc chuyển sang hỗ trợ các tính năng này được thúc đẩy bởi nhiều yếu tố. Sự phổ biến của Megastore [5] cho thấy nhu cầu hỗ trợ các bảng bán quan hệ có lược đồ và sao chép đồng bộ. Ít nhất 300 ứng dụng trong Google sử dụng Megastore (mặc dù hiệu năng của nó tương đối thấp) vì mô hình dữ liệu của nó dễ quản lý hơn mô hình của Bigtable, và vì nó hỗ trợ sao chép đồng bộ giữa các trung tâm dữ liệu. (Bigtable chỉ hỗ trợ sao chép với tính nhất quán cuối cùng giữa các trung tâm dữ liệu.) Các ứng dụng nổi tiếng của Google sử dụng Megastore bao gồm Gmail, Picasa, Calendar, Android Market và AppEngine. Nhu cầu hỗ trợ một ngôn ngữ truy vấn tương tự SQL trong Spanner cũng rất rõ ràng, xét đến sự phổ biến của Dremel [28] với vai trò công cụ phân tích dữ liệu tương tác. Cuối cùng, việc thiếu các giao dịch xuyên hàng trong Bigtable dẫn đến những phàn nàn thường xuyên; Percolator [32] được xây dựng một phần để khắc phục thiếu sót này. Một số tác giả cho rằng chi phí hỗ trợ xác nhận hai pha (two-phase commit) trong trường hợp tổng quát là quá cao, do những vấn đề về hiệu năng hoặc tính sẵn sàng mà nó gây ra [9, 10, 19]. Chúng tôi cho rằng tốt hơn là để các lập trình viên ứng dụng xử lý những vấn đề hiệu năng do lạm dụng giao dịch khi các nút thắt xuất hiện, thay vì luôn phải viết mã để khắc phục việc thiếu giao dịch. Thực thi xác nhận hai pha trên Paxos làm giảm các vấn đề về tính sẵn sàng.
The application data model is layered on top of the directory-bucketed key-value mappings supported by the implementation. An application creates one or more databases in a universe. Each database can contain an unlimited number of schematized tables. Tables look like relational-database tables, with rows, columns, and versioned values. We will not go into detail about the query language for Spanner. It looks like SQL with some extensions to support protocol-buffer-valued fields.
Mô hình dữ liệu ứng dụng được xây dựng thành một lớp bên trên các ánh xạ khóa-giá trị được gom nhóm theo thư mục mà bản triển khai hỗ trợ. Một ứng dụng tạo một hoặc nhiều cơ sở dữ liệu trong một vũ trụ. Mỗi cơ sở dữ liệu có thể chứa số lượng không giới hạn các bảng có lược đồ. Các bảng trông giống bảng trong cơ sở dữ liệu quan hệ, với các hàng, cột và giá trị có phiên bản. Chúng tôi sẽ không đi sâu vào ngôn ngữ truy vấn của Spanner. Nó giống SQL với một số phần mở rộng để hỗ trợ các trường có giá trị kiểu protocol buffer.
Spanner’s data model is not purely relational, in that rows must have names. More precisely, every table is required to have an ordered set of one or more primary-key columns. This requirement is where Spanner still looks like a key-value store: the primary keys form the name for a row, and each table defines a mapping from the primary-key columns to the non-primary-key columns. A row has existence only if some value (even if it is NULL) is defined for the row’s keys. Imposing this structure is useful because it lets applications control data locality through their choices of keys.
Mô hình dữ liệu của Spanner không thuần quan hệ, ở chỗ các hàng phải có tên. Chính xác hơn, mỗi bảng bắt buộc phải có một tập hợp có thứ tự gồm một hoặc nhiều cột khóa chính. Yêu cầu này là điểm mà Spanner vẫn giống một kho khóa-giá trị: các khóa chính tạo thành tên của một hàng, và mỗi bảng định nghĩa một ánh xạ từ các cột khóa chính sang các cột không thuộc khóa chính. Một hàng chỉ tồn tại nếu có một giá trị nào đó (kể cả NULL) được định nghĩa cho các khóa của hàng đó. Việc áp đặt cấu trúc này là hữu ích vì nó cho phép các ứng dụng kiểm soát tính cục bộ của dữ liệu thông qua việc lựa chọn khóa.
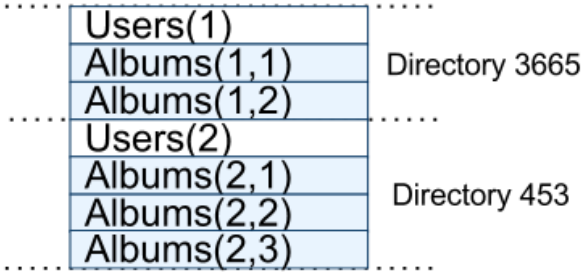
Figure 4 contains an example Spanner schema for storing photo metadata on a per-user, per-album basis. The schema language is similar to Megastore’s, with the additional requirement that every Spanner database must be partitioned by clients into one or more hierarchies of tables. Client applications declare the hierarchies in database schemas via the INTERLEAVE IN declarations. The table at the top of a hierarchy is a directory table. Each row in a directory table with key , together with all of the rows in descendant tables that start with in lexicographic order, forms a directory. ON DELETE CASCADE says that deleting a row in the directory table deletes any associated child rows. The figure also illustrates the interleaved layout for the example database: for
Hình 4 trình bày một ví dụ về lược đồ Spanner để lưu trữ siêu dữ liệu ảnh theo từng người dùng, từng album. Ngôn ngữ lược đồ tương tự ngôn ngữ của Megastore, với yêu cầu bổ sung rằng mỗi cơ sở dữ liệu Spanner phải được các máy khách phân vùng thành một hoặc nhiều hệ phân cấp bảng. Các ứng dụng máy khách khai báo các hệ phân cấp trong lược đồ cơ sở dữ liệu thông qua các khai báo INTERLEAVE IN. Bảng ở đỉnh của một hệ phân cấp là bảng thư mục (directory table). Mỗi hàng trong một bảng thư mục có khóa , cùng với tất cả các hàng trong các bảng hậu duệ bắt đầu bằng theo thứ tự từ điển, tạo thành một thư mục. ON DELETE CASCADE quy định rằng việc xóa một hàng trong bảng thư mục sẽ xóa mọi hàng con liên quan. Hình này cũng minh họa cách bố trí xen kẽ (interleaving) cho cơ sở dữ liệu ví dụ: chẳng
              CREATE TABLE Users {
    uid INT64 NOT NULL, email STRING
} PRIMARY KEY (uid), DIRECTORY;

CREATE TABLE Albums {
    uid INT64 NOT NULL, aid INT64 NOT NULL,
    name STRING
} PRIMARY KEY (uid, aid),
INTERLEAVE IN PARENT Users ON DELETE CASCADE;
              CREATE TABLE Users {
    uid INT64 NOT NULL, email STRING
} PRIMARY KEY (uid), DIRECTORY;

CREATE TABLE Albums {
    uid INT64 NOT NULL, aid INT64 NOT NULL,
    name STRING
} PRIMARY KEY (uid, aid),
INTERLEAVE IN PARENT Users ON DELETE CASCADE;
| Users(1) | Albums(1,1) | Albums(1,2) | Users(2) | Albums(2,1) | Albums(2,2) | Albums(2,3) |
|---|
| Users(1) | Albums(1,1) | Albums(1,2) | Users(2) | Albums(2,1) | Albums(2,2) | Albums(2,3) |
|---|
Directory 3665
Thư mục 3665
Directory 453 example, Albums represents the row from the Albums table for user_id 2, album_id 1. This interleaving of tables to form directories is significant because it allows clients to describe the locality relationships that exist between multiple tables, which is necessary for good performance in a sharded, distributed database. Without it, Spanner would not know the most important locality relationships.
Thư mục 453 hạn, Albums biểu diễn hàng trong bảng Albums ứng với user_id 2, album_id 1. Việc xen kẽ các bảng để tạo thành các thư mục có ý nghĩa quan trọng vì nó cho phép các máy khách mô tả các mối quan hệ về tính cục bộ (locality) tồn tại giữa nhiều bảng, điều cần thiết để đạt hiệu năng tốt trong một cơ sở dữ liệu phân tán có phân mảnh. Nếu không có cách bố trí này, Spanner sẽ không biết được các mối quan hệ quan trọng nhất về tính cục bộ.
3 TrueTime
3 TrueTime
| Method | Returns |
|---|---|
| TT.now() | TTinterval: [earliest, latest] |
| TT.after(t) | true if has definitely passed |
| TT.before(t) | true if has definitely not arrived |
| Phương thức | Trả về |
|---|---|
| TT.now() | TTinterval: [earliest, latest] |
| TT.after(t) | true nếu chắc chắn đã trôi qua |
| TT.before(t) | true nếu chắc chắn chưa đến |
Table 1: TrueTime API. The argument is of type .
Bảng 1: API TrueTime. Đối số có kiểu .
This section describes the TrueTime API and sketches its implementation. We leave most of the details for another paper: our goal is to demonstrate the power of having such an API. Table 1 lists the methods of the API. TrueTime explicitly represents time as a , which is an interval with bounded time uncertainty (unlike standard time interfaces that give clients no notion of uncertainty). The endpoints of a are of type . The method returns a that is guaranteed to contain the absolute time during which was invoked. The time epoch is analogous to UNIX time with leap-second smearing. Define the instantaneous error bound as , which is half of the interval’s width, and the average error bound as . The and methods are convenience wrappers around .
Phần này mô tả API TrueTime và phác thảo việc triển khai của nó. Chúng tôi để lại hầu hết các chi tiết cho một bài báo khác: mục tiêu của chúng tôi là minh họa sức mạnh của việc có một API như vậy. Bảng 1 liệt kê các phương thức của API. TrueTime biểu diễn thời gian một cách tường minh dưới dạng , là một khoảng với độ bất định thời gian bị chặn (khác với các giao diện thời gian tiêu chuẩn không cung cấp cho máy khách khái niệm nào về sự bất định). Các điểm đầu mút của một có kiểu . Phương thức trả về một được đảm bảo chứa thời gian tuyệt đối trong khoảng thời gian mà được gọi. Kỷ nguyên thời gian tương tự như thời gian UNIX với việc làm mờ giây nhuận. Định nghĩa cận lỗi tức thời là , bằng một nửa độ rộng của khoảng, và cận lỗi trung bình là . Các phương thức và là các lớp bao tiện ích xung quanh .
Denote the absolute time of an event by the function . In more formal terms, TrueTime guarantees that for an invocation , where is the invocation event.
Ký hiệu thời gian tuyệt đối của một sự kiện bằng hàm . Theo cách hình thức hơn, TrueTime đảm bảo rằng với một lần gọi , trong đó là sự kiện gọi.
The underlying time references used by TrueTime are GPS and atomic clocks. TrueTime uses two forms of time reference because they have different failure modes. GPS reference-source vulnerabilities include antenna and receiver failures, local radio interference, correlated failures (e.g., design faults such as incorrect leap-second handling and spoofing), and GPS system outages. Atomic clocks can fail in ways uncorrelated to GPS and each other, and over long periods of time can drift significantly due to frequency error.
Các tham chiếu thời gian nền tảng được TrueTime sử dụng là GPS và đồng hồ nguyên tử. TrueTime sử dụng hai dạng tham chiếu thời gian vì chúng có các chế độ sự cố khác nhau. Các lỗ hổng của nguồn tham chiếu GPS bao gồm sự cố ăng-ten và bộ thu, nhiễu vô tuyến cục bộ, các sự cố tương quan (ví dụ, các lỗi thiết kế như xử lý giây nhuận không đúng và giả mạo), và các sự cố ngừng hoạt động của hệ thống GPS. Đồng hồ nguyên tử có thể gặp sự cố theo các cách không tương quan với GPS và với nhau, và trong các khoảng thời gian dài có thể bị trôi đáng kể do lỗi tần số.
TrueTime is implemented by a set of time master machines per datacenter and a timeslave daemon per machine. The majority of masters have GPS receivers with dedicated antennas; these masters are separated physically to reduce the effects of antenna failures, radio interference, and spoofing. The remaining masters (which we refer to as Armageddon masters) are equipped with atomic clocks. An atomic clock is not that expensive: the cost of an Armageddon master is of the same order as that of a GPS master. All masters’ time references are regularly compared against each other. Each master also cross-checks the rate at which its reference advances time against its own local clock, and evicts itself if there is substantial divergence. Between synchronizations, Armageddon masters advertise a slowly increasing time uncertainty that is derived from conservatively applied worst-case clock drift. GPS masters advertise uncertainty that is typically close to zero.
TrueTime được triển khai bởi một tập hợp các máy time master trên mỗi trung tâm dữ liệu và một timeslave daemon trên mỗi máy. Phần lớn các master có bộ thu GPS với ăng-ten chuyên dụng; các master này được tách biệt về mặt vật lý để giảm ảnh hưởng của sự cố ăng-ten, nhiễu vô tuyến và giả mạo. Các master còn lại (mà chúng tôi gọi là Armageddon masters) được trang bị đồng hồ nguyên tử. Một đồng hồ nguyên tử không quá đắt: chi phí của một Armageddon master cùng bậc với chi phí của một GPS master. Các tham chiếu thời gian của tất cả master thường xuyên được so sánh với nhau. Mỗi master cũng kiểm tra chéo tốc độ mà tham chiếu của nó tiến triển thời gian so với đồng hồ cục bộ của chính nó, và tự loại bỏ nếu có sai khác đáng kể. Giữa các lần đồng bộ hóa, các Armageddon master công bố độ bất định thời gian tăng chậm được suy ra từ độ trôi đồng hồ trong trường hợp xấu nhất được áp dụng một cách thận trọng. Các GPS master công bố độ bất định thường gần bằng không.
Every daemon polls a variety of masters [29] to reduce vulnerability to errors from any one master. Some are GPS masters chosen from nearby datacenters; the rest are GPS masters from farther datacenters, as well as some Armageddon masters. Daemons apply a variant of Marzullo’s algorithm [27] to detect and reject liars, and synchronize the local machine clocks to the non-liars. To protect against broken local clocks, machines that exhibit frequency excursions larger than the worst-case bound derived from component specifications and operating environment are evicted.
Mỗi daemon thăm dò nhiều master khác nhau [29] để giảm khả năng bị tổn thương trước lỗi từ bất kỳ master đơn lẻ nào. Một số là các GPS master được chọn từ các trung tâm dữ liệu lân cận; phần còn lại là các GPS master từ các trung tâm dữ liệu xa hơn, cũng như một số Armageddon master. Các daemon áp dụng một biến thể của thuật toán Marzullo [27] để phát hiện và loại bỏ các bên nói dối, đồng thời đồng bộ hóa đồng hồ máy cục bộ với các bên không nói dối. Để bảo vệ trước các đồng hồ cục bộ bị hỏng, các máy thể hiện sai lệch tần số lớn hơn cận trường hợp xấu nhất được suy ra từ đặc tả thành phần và môi trường vận hành sẽ bị loại bỏ.
Between synchronizations, a daemon advertises a slowly increasing time uncertainty. is derived from conservatively applied worst-case local clock drift. also depends on time-master uncertainty and communication delay to the time masters. In our production environment, is typically a sawtooth function of time, varying from about 1 to 7 ms over each poll interval. is therefore 4 ms most of the time. The daemon’s poll interval is currently 30 seconds, and the current applied drift rate is set at 200 microseconds/second, which together account
Giữa các lần đồng bộ hóa, một daemon công bố độ bất định thời gian tăng chậm. được suy ra từ độ trôi đồng hồ cục bộ trong trường hợp xấu nhất được áp dụng một cách thận trọng. cũng phụ thuộc vào độ bất định của time-master và độ trễ giao tiếp tới các time master. Trong môi trường sản xuất của chúng tôi, thường là một hàm răng cưa theo thời gian, thay đổi từ khoảng 1 đến 7 ms trong mỗi khoảng thăm dò. Do đó là 4 ms trong phần lớn thời gian. Khoảng thăm dò của daemon hiện là 30 giây, và tốc độ trôi được áp dụng hiện tại được đặt ở mức 200 microseconds/second, cùng nhau chiếm
| Operation | Timestamp Discussion | Concurrency Control | Replica Required |
|---|---|---|---|
| Read-Write Transaction | § 4.1.2 | pessimistic | leader |
| Read-Only Transaction | § 4.1.4 | lock-free | leader for timestamp; any for read, subject to § 4.1.3 |
| Snapshot Read, client-provided timestamp | — | lock-free | any, subject to § 4.1.3 |
| Snapshot Read, client-provided bound | § 4.1.3 | lock-free | any, subject to § 4.1.3 |
| Thao tác | Thảo luận về dấu thời gian | Điều khiển đồng thời | Bản sao bắt buộc |
|---|---|---|---|
| Read-Write Transaction | § 4.1.2 | bi quan | leader |
| Read-Only Transaction | § 4.1.4 | không khóa | leader cho dấu thời gian; bất kỳ cho đọc, tuân theo § 4.1.3 |
| Snapshot Read, client-provided timestamp | — | không khóa | bất kỳ, tuân theo § 4.1.3 |
| Snapshot Read, client-provided bound | § 4.1.3 | không khóa | bất kỳ, tuân theo § 4.1.3 |
Table 2: Types of reads and writes in Spanner, and how they compare.
Bảng 2: Các kiểu đọc và ghi trong Spanner, và cách chúng được so sánh.
for the sawtooth bounds from 0 to 6 ms. The remaining 1 ms comes from the communication delay to the time masters. Excursions from this sawtooth are possible in the presence of failures. For example, occasional time-master unavailability can cause datacenter-wide increases in . Similarly, overloaded machines and network links can result in occasional localized spikes.
cho các cận răng cưa từ 0 đến 6 ms. 1 ms còn lại đến từ độ trễ giao tiếp tới các time master. Các sai lệch khỏi dạng răng cưa này có thể xảy ra khi có sự cố. Ví dụ, tình trạng không khả dụng thỉnh thoảng của time-master có thể gây ra sự gia tăng trên toàn trung tâm dữ liệu. Tương tự, các máy và liên kết mạng bị quá tải có thể dẫn đến các đỉnh cục bộ xảy ra không thường xuyên.
4 Concurrency Control
4 Kiểm soát đồng thời
This section describes how TrueTime is used to guarantee the correctness properties around concurrency control, and how those properties are used to implement features such as externally consistent transactions, lock-free read-only transactions, and non-blocking reads in the past. These features enable, for example, the guarantee that a whole-database audit read at a timestamp will see exactly the effects of every transaction that has committed as of .
Phần này mô tả cách TrueTime được sử dụng để đảm bảo các thuộc tính đúng đắn xung quanh kiểm soát đồng thời, và cách các thuộc tính đó được sử dụng để triển khai các tính năng như giao dịch nhất quán bên ngoài, giao dịch chỉ đọc không khóa, và đọc không chặn trong quá khứ. Các tính năng này cho phép, ví dụ, đảm bảo rằng một thao tác đọc kiểm tra toàn bộ cơ sở dữ liệu tại dấu thời gian sẽ thấy chính xác ảnh hưởng của mọi giao dịch đã xác nhận tính đến .
Going forward, it will be important to distinguish writes as seen by Paxos (which we will refer to as Paxos writes unless the context is clear) from Spanner client writes. For example, two-phase commit generates a Paxos write for the prepare phase that has no corresponding Spanner client write.
Trong phần tiếp theo, sẽ rất quan trọng khi phân biệt các ghi nhận được Paxos quan sát (mà chúng tôi sẽ gọi là các ghi Paxos trừ khi ngữ cảnh đã rõ) với các ghi của máy khách Spanner. Ví dụ, xác nhận hai pha tạo ra một ghi Paxos cho giai đoạn chuẩn bị mà không có ghi máy khách Spanner tương ứng.
4.1 Timestamp Management
4.1 Quản lý dấu thời gian
Table 2 lists the types of operations that Spanner supports. The Spanner implementation supports read-write transactions, read-only transactions (predeclared snapshot-isolation transactions), and snapshot reads. Standalone writes are implemented as read-write transactions; non-snapshot standalone reads are implemented as read-only transactions. Both are internally retried (clients need not write their own retry loops).
Bảng 2 liệt kê các kiểu thao tác mà Spanner hỗ trợ. Cài đặt Spanner hỗ trợ giao dịch đọc-ghi, giao dịch chỉ đọc (các giao dịch cô lập ảnh chụp được khai báo trước), và đọc ảnh chụp. Các ghi độc lập được triển khai dưới dạng giao dịch đọc-ghi; các đọc độc lập không phải ảnh chụp được triển khai dưới dạng giao dịch chỉ đọc. Cả hai đều được thử lại nội bộ (máy khách không cần tự viết các vòng lặp thử lại).
A read-only transaction is a kind of transaction that has the performance benefits of snapshot isolation [6]. A read-only transaction must be predeclared as not having any writes; it is not simply a read-write transaction without any writes. Reads in a read-only transaction execute at a system-chosen timestamp without locking, so that incoming writes are not blocked. The execution of the reads in a read-only transaction can proceed on any replica that is sufficiently up-to-date (Section 4.1.3).
Một giao dịch chỉ đọc là một kiểu giao dịch có các lợi ích về hiệu năng của cô lập ảnh chụp [6]. Một giao dịch chỉ đọc phải được khai báo trước là không có bất kỳ ghi nào; nó không đơn giản chỉ là một giao dịch đọc-ghi không có ghi nào. Các đọc trong một giao dịch chỉ đọc được thực thi tại một dấu thời gian do hệ thống chọn mà không khóa, để các ghi đến không bị chặn. Việc thực thi các đọc trong một giao dịch chỉ đọc có thể tiến hành trên bất kỳ bản sao nào đủ cập nhật (Mục 4.1.3).
A snapshot read is a read in the past that executes without locking. A client can either specify a timestamp for a snapshot read, or provide an upper bound on the desired timestamp’s staleness and let Spanner choose a timestamp. In either case, the execution of a snapshot read proceeds at any replica that is sufficiently up-to-date.
Một đọc ảnh chụp là một đọc trong quá khứ được thực thi mà không khóa. Một máy khách có thể chỉ định một dấu thời gian cho một đọc ảnh chụp, hoặc cung cấp một cận trên về độ cũ mong muốn của dấu thời gian và để Spanner chọn một dấu thời gian. Trong cả hai trường hợp, việc thực thi một đọc ảnh chụp tiến hành trên bất kỳ bản sao nào đủ cập nhật.
For both read-only transactions and snapshot reads, commit is inevitable once a timestamp has been chosen, unless the data at that timestamp has been garbage-collected. As a result, clients can avoid buffering results inside a retry loop. When a server fails, clients can internally continue the query on a different server by repeating the timestamp and the current read position.
Đối với cả giao dịch chỉ đọc và đọc ảnh chụp, xác nhận là tất yếu một khi một dấu thời gian đã được chọn, trừ khi dữ liệu tại dấu thời gian đó đã được thu gom rác. Kết quả là, máy khách có thể tránh đệm các kết quả bên trong một vòng lặp thử lại. Khi một server gặp sự cố, máy khách có thể tiếp tục truy vấn nội bộ trên một server khác bằng cách lặp lại dấu thời gian và vị trí đọc hiện tại.
4.1.1 Paxos Leader Leases
4.1.1 Các hợp đồng thuê lãnh đạo Paxos
Spanner’s Paxos implementation uses timed leases to make leadership long-lived (10 seconds by default). A potential leader sends requests for timed lease votes; upon receiving a quorum of lease votes the leader knows it has a lease. A replica extends its lease vote implicitly on a successful write, and the leader requests lease-vote extensions if they are near expiration. Define a leader’s lease interval as starting when it discovers it has a quorum of lease votes, and as ending when it no longer has a quorum of lease votes (because some have expired). Spanner depends on the following disjointness invariant: for each Paxos group, each Paxos leader’s lease interval is disjoint from every other leader’s. Appendix A describes how this invariant is enforced.
Cài đặt Paxos của Spanner sử dụng các hợp đồng thuê có định thời để làm cho vai trò lãnh đạo tồn tại lâu dài (mặc định 10 giây). Một lãnh đạo tiềm năng gửi các yêu cầu cho các phiếu thuê có định thời; khi nhận được một số đại diện phiếu thuê, lãnh đạo biết rằng nó có một hợp đồng thuê. Một bản sao mở rộng phiếu thuê của nó một cách ngầm định khi có một ghi thành công, và lãnh đạo yêu cầu các mở rộng phiếu thuê nếu chúng gần hết hạn. Định nghĩa khoảng thuê của một lãnh đạo là bắt đầu khi nó phát hiện có một số đại diện phiếu thuê, và kết thúc khi nó không còn có một số đại diện phiếu thuê (vì một số đã hết hạn). Spanner phụ thuộc vào bất biến rời rạc sau: đối với mỗi nhóm Paxos, khoảng thuê của mỗi lãnh đạo Paxos là rời rạc với mọi khoảng thuê của các lãnh đạo khác. Phụ lục A mô tả cách bất biến này được đảm bảo.
The Spanner implementation permits a Paxos leader to abdicate by releasing its slaves from their lease votes. To preserve the disjointness invariant, Spanner constrains when abdication is permissible. Define to be the maximum timestamp used by a leader. Subsequent sections will describe when is advanced. Before abdicating, a leader must wait until TT.after() is true.
Cài đặt Spanner cho phép một lãnh đạo Paxos thoái vị bằng cách giải phóng các bản sao phụ của nó khỏi các phiếu thuê. Để duy trì bất biến rời rạc, Spanner giới hạn thời điểm việc thoái vị được phép. Định nghĩa là dấu thời gian lớn nhất được sử dụng bởi một lãnh đạo. Các phần tiếp theo sẽ mô tả khi nào được tăng lên. Trước khi thoái vị, một lãnh đạo phải đợi cho đến khi TT.after() is true.
4.1.2 Assigning Timestamps to RW Transactions
4.1.2 Gán dấu thời gian cho các giao dịch RW
Transactional reads and writes use two-phase locking. As a result, they can be assigned timestamps at any time when all locks have been acquired, but before any locks have been released. For a given transaction, Spanner assigns it the timestamp that Paxos assigns to the Paxos write that represents the transaction commit.
Các đọc và ghi giao dịch sử dụng khóa hai pha. Do đó, chúng có thể được gán dấu thời gian tại bất kỳ thời điểm nào khi tất cả các khóa đã được thu nhận, nhưng trước khi bất kỳ khóa nào được giải phóng. Với một giao dịch cụ thể, Spanner gán cho nó dấu thời gian mà Paxos gán cho ghi Paxos biểu diễn việc xác nhận giao dịch.
Spanner depends on the following monotonicity invariant: within each Paxos group, Spanner assigns timestamps to Paxos writes in monotonically increasing order, even across leaders. A single leader replica can trivially assign timestamps in monotonically increasing order. This invariant is enforced across leaders by making use of the disjointness invariant: a leader must only assign timestamps within the interval of its leader lease. Note that whenever a timestamp is assigned, is advanced to to preserve disjointness.
Spanner phụ thuộc vào bất biến đơn điệu sau: trong mỗi nhóm Paxos, Spanner gán dấu thời gian cho các ghi Paxos theo thứ tự tăng đơn điệu, ngay cả giữa các lãnh đạo. Một bản sao lãnh đạo đơn lẻ có thể dễ dàng gán dấu thời gian theo thứ tự tăng đơn điệu. Bất biến này được đảm bảo giữa các lãnh đạo bằng cách sử dụng bất biến rời rạc: một lãnh đạo chỉ được gán dấu thời gian trong khoảng của hợp đồng thuê lãnh đạo của nó. Lưu ý rằng bất cứ khi nào một dấu thời gian được gán, được tăng lên thành để duy trì tính rời rạc.
Spanner also enforces the following external-consistency invariant: if the start of a transaction occurs after the commit of a transaction , then the commit timestamp of must be greater than the commit timestamp of . Define the start and commit events for a transaction by and ; and the commit timestamp of a transaction by . The invariant becomes . The protocol for executing transactions and assigning timestamps obeys two rules, which together guarantee this invariant, as shown below. Define the arrival event of the commit request at the coordinator leader for a write to be .
Spanner cũng thực thi bất biến nhất quán bên ngoài sau: nếu thời điểm bắt đầu của một giao dịch xảy ra sau thời điểm xác nhận của một giao dịch , thì dấu thời gian xác nhận của phải lớn hơn dấu thời gian xác nhận của . Định nghĩa các sự kiện bắt đầu và xác nhận cho một giao dịch lần lượt bởi và ; và dấu thời gian xác nhận của một giao dịch bởi . Bất biến trở thành . Giao thức để thực thi các giao dịch và gán dấu thời gian tuân theo hai quy tắc, cùng nhau đảm bảo bất biến này, như được trình bày bên dưới. Định nghĩa sự kiện đến của yêu cầu xác nhận tại lãnh đạo điều phối cho một ghi là .
Start The coordinator leader for a write assigns a commit timestamp no less than the value of , computed after . Note that the participant leaders do not matter here; Section 4.2.1 describes how they are involved in the implementation of the next rule.
Bắt đầu Lãnh đạo điều phối cho một ghi gán một dấu thời gian xác nhận không nhỏ hơn giá trị của , được tính sau . Lưu ý rằng các lãnh đạo tham gia không quan trọng ở đây; Mục 4.2.1 mô tả cách chúng tham gia vào việc triển khai quy tắc tiếp theo.
Commit Wait The coordinator leader ensures that clients cannot see any data committed by until is true. Commit wait ensures that is less than the absolute commit time of , or . The implementation of commit wait is described in Section 4.2.1. Proof:
Chờ xác nhận Điều phối viên leader đảm bảo rằng các máy khách không thể thấy bất kỳ dữ liệu nào được xác nhận bởi cho đến khi là đúng. Chờ xác nhận đảm bảo rằng nhỏ hơn thời điểm xác nhận tuyệt đối của , hoặc . Việc triển khai chờ xác nhận được mô tả trong Section 4.2.1. Chứng minh:
4.1.3 Serving Reads at a Timestamp
4.1.3 Phục vụ các lần đọc tại một dấu thời gian
The monotonicity invariant described in Section 4.1.2 allows Spanner to correctly determine whether a replica’s state is sufficiently up-to-date to satisfy a read. Every replica tracks a value called safe time which is the maximum timestamp at which a replica is up-to-date. A replica can satisfy a read at a timestamp if .
Bất biến đơn điệu được mô tả trong Section 4.1.2 cho phép Spanner xác định chính xác liệu trạng thái của một bản sao có đủ được cập nhật để đáp ứng một lần đọc hay không. Mỗi bản sao theo dõi một giá trị được gọi là safe time , là dấu thời gian lớn nhất tại đó một bản sao được cập nhật đầy đủ. Một bản sao có thể đáp ứng một lần đọc tại dấu thời gian nếu .
Define , where each Paxos state machine has a safe time and each transaction manager has a safe time . is simpler: it is the timestamp of the highest-applied Paxos write. Because timestamps increase monotonically and writes are applied in order, writes will no longer occur at or below with respect to Paxos.
Định nghĩa , trong đó mỗi máy trạng thái Paxos có một thời gian an toàn và mỗi trình quản lý giao dịch có một thời gian an toàn . đơn giản hơn: nó là dấu thời gian của lần ghi Paxos được áp dụng cao nhất. Vì các dấu thời gian tăng đơn điệu và các lần ghi được áp dụng theo thứ tự, các lần ghi sẽ không còn xảy ra tại hoặc thấp hơn theo Paxos.
is at a replica if there are zero prepared (but not committed) transactions—that is, transactions in between the two phases of two-phase commit. (For a participant slave, actually refers to the replica’s leader’s transaction manager, whose state the slave can infer through metadata passed on Paxos writes.) If there are any such transactions, then the state affected by those transactions is indeterminate: a participant replica does not know yet whether such transactions will commit. As we discuss in Section 4.2.1, the commit protocol ensures that every participant knows a lower bound on a prepared transaction’s timestamp. Every participant leader (for a group ) for a transaction assigns a prepare timestamp to its prepare record. The coordinator leader ensures that the transaction’s commit timestamp over all participant groups . Therefore, for every replica in a group , over all transactions prepared at , over all transactions prepared at .
là tại một bản sao nếu có không có giao dịch nào đã chuẩn bị (nhưng chưa được xác nhận), tức là các giao dịch nằm giữa hai pha của xác nhận hai pha. (Đối với một slave tham gia, thực sự đề cập đến trình quản lý giao dịch của leader của bản sao, mà trạng thái của slave có thể suy ra thông qua metadata được truyền trong các lần ghi Paxos.) Nếu có bất kỳ giao dịch nào như vậy, thì trạng thái bị ảnh hưởng bởi các giao dịch đó là không xác định: một bản sao tham gia chưa biết liệu các giao dịch như vậy có được xác nhận hay không. Như chúng tôi thảo luận trong Section 4.2.1, giao thức xác nhận đảm bảo rằng mọi bên tham gia biết một cận dưới về dấu thời gian của một giao dịch đã chuẩn bị. Mọi leader tham gia (đối với một nhóm ) cho một giao dịch gán một dấu thời gian chuẩn bị cho bản ghi chuẩn bị của nó. Leader điều phối đảm bảo rằng dấu thời gian xác nhận của giao dịch trên tất cả các nhóm tham gia . Do đó, đối với mọi bản sao trong một nhóm , trên tất cả các giao dịch được chuẩn bị tại , trên tất cả các giao dịch được chuẩn bị tại .
4.1.4 Assigning Timestamps to RO Transactions
4.1.4 Gán dấu thời gian cho các giao dịch RO
A read-only transaction executes in two phases: assign a timestamp [8], and then execute the transaction’s reads as snapshot reads at . The snapshot reads can execute at any replicas that are sufficiently up-to-date.
Một giao dịch chỉ đọc thực thi trong hai pha: gán một dấu thời gian [8], rồi thực thi các lần đọc của giao dịch dưới dạng các lần đọc snapshot tại . Các lần đọc snapshot có thể thực thi tại bất kỳ bản sao nào được cập nhật đầy đủ.
The simple assignment of , at any time after a transaction starts, preserves external consistency by an argument analogous to that presented for writes in Section 4.1.2. However, such a timestamp may require the execution of the data reads at to block if has not advanced sufficiently. (In addition, note that choosing a value of may also advance to preserve disjointness.) To reduce the chances of blocking, Spanner should assign the oldest timestamp that preserves external consistency. Section 4.2.2 explains how such a timestamp can be chosen.
Việc gán đơn giản , tại bất kỳ thời điểm nào sau khi một giao dịch bắt đầu, duy trì tính nhất quán bên ngoài bằng một lập luận tương tự như lập luận được trình bày cho các lần ghi trong Section 4.1.2. Tuy nhiên, một dấu thời gian như vậy có thể yêu cầu việc thực thi các lần đọc dữ liệu tại phải chặn nếu chưa tiến triển đủ. (Ngoài ra, lưu ý rằng việc chọn một giá trị của cũng có thể làm tăng để duy trì tính rời rạc.) Để giảm khả năng bị chặn, Spanner nên gán dấu thời gian cũ nhất vẫn duy trì tính nhất quán bên ngoài. Section 4.2.2 giải thích cách có thể chọn một dấu thời gian như vậy.
4.2 Details
4.2 Chi tiết
This section explains some of the practical details of read-write transactions and read-only transactions elided earlier, as well as the implementation of a special transaction type used to implement atomic schema changes.
Phần này giải thích một số chi tiết thực tế của các giao dịch đọc-ghi và các giao dịch chỉ đọc đã được lược bỏ trước đó, cũng như việc triển khai một kiểu giao dịch đặc biệt được sử dụng để thực hiện các thay đổi lược đồ nguyên tử.
It then describes some refinements of the basic schemes as described.
Sau đó mô tả một số tinh chỉnh của các lược đồ cơ bản như đã trình bày.
4.2.1 Read-Write Transactions
4.2.1 Các giao dịch đọc-ghi
Like Bigtable, writes that occur in a transaction are buffered at the client until commit. As a result, reads in a transaction do not see the effects of the transaction’s writes. This design works well in Spanner because a read returns the timestamps of any data read, and uncommitted writes have not yet been assigned timestamps.
Giống như Bigtable, các lần ghi xảy ra trong một giao dịch được lưu vào bộ đệm tại máy khách cho đến khi xác nhận. Do đó, các lần đọc trong một giao dịch không thấy tác động của các lần ghi của giao dịch. Thiết kế này hoạt động tốt trong Spanner vì một lần đọc trả về các dấu thời gian của mọi dữ liệu được đọc, và các lần ghi chưa được xác nhận vẫn chưa được gán dấu thời gian.
Reads within read-write transactions use wound-wait [33] to avoid deadlocks. The client issues reads to the leader replica of the appropriate group, which acquires read locks and then reads the most recent data. While a client transaction remains open, it sends keepalive messages to prevent participant leaders from timing out its transaction. When a client has completed all reads and buffered all writes, it begins two-phase commit. The client chooses a coordinator group and sends a commit message to each participant’s leader with the identity of the coordinator and any buffered writes. Having the client drive two-phase commit avoids sending data twice across wide-area links.
Các lần đọc trong các giao dịch đọc-ghi sử dụng wound-wait [33] để tránh bế tắc. Máy khách gửi các lần đọc đến bản sao leader của nhóm thích hợp, bản sao này thu nhận các khóa đọc rồi đọc dữ liệu mới nhất. Trong khi một giao dịch của máy khách vẫn mở, nó gửi các thông điệp keepalive để ngăn các leader tham gia hết thời gian chờ giao dịch của nó. Khi một máy khách đã hoàn thành tất cả các lần đọc và lưu vào bộ đệm tất cả các lần ghi, nó bắt đầu xác nhận hai pha. Máy khách chọn một nhóm điều phối và gửi một thông điệp xác nhận đến leader của mỗi bên tham gia cùng với danh tính của điều phối viên và mọi lần ghi đã được lưu vào bộ đệm. Việc để máy khách điều khiển xác nhận hai pha tránh gửi dữ liệu hai lần qua các liên kết diện rộng.
A non-coordinator-participant leader first acquires write locks. It then chooses a prepare timestamp that must be larger than any timestamps it has assigned to previous transactions (to preserve monotonicity), and logs a prepare record through Paxos. Each participant then notifies the coordinator of its prepare timestamp.
Một leader không phải điều phối viên-tham gia trước tiên thu nhận các khóa ghi. Sau đó nó chọn một dấu thời gian chuẩn bị phải lớn hơn mọi dấu thời gian mà nó đã gán cho các giao dịch trước đó (để duy trì tính đơn điệu), và ghi một bản ghi chuẩn bị thông qua Paxos. Mỗi bên tham gia sau đó thông báo cho điều phối viên về dấu thời gian chuẩn bị của nó.
The coordinator leader also first acquires write locks, but skips the prepare phase. It chooses a timestamp for the entire transaction after hearing from all other participant leaders. The commit timestamp s must be greater or equal to all prepare timestamps (to satisfy the constraints discussed in Section 4.1.3), greater than TT.now().latest at the time the coordinator received its commit message, and greater than any timestamps the leader has assigned to previous transactions (again, to preserve monotonicity). The coordinator leader then logs a commit record through Paxos (or an abort if it timed out while waiting on the other participants).
Trưởng nhóm điều phối cũng trước tiên thu được các khóa ghi, nhưng bỏ qua pha chuẩn bị. Nó chọn một dấu thời gian cho toàn bộ giao dịch sau khi nhận thông tin từ tất cả các trưởng nhóm tham gia khác. Dấu thời gian xác nhận s phải lớn hơn hoặc bằng tất cả các dấu thời gian chuẩn bị (để thỏa mãn các ràng buộc được thảo luận trong Section 4.1.3), lớn hơn TT.now().latest tại thời điểm trưởng nhóm điều phối nhận được thông điệp xác nhận của nó, và lớn hơn bất kỳ dấu thời gian nào mà trưởng nhóm đã gán cho các giao dịch trước đó (một lần nữa, để duy trì tính đơn điệu). Sau đó trưởng nhóm điều phối ghi một bản ghi xác nhận thông qua Paxos (hoặc hủy bỏ nếu nó hết thời gian chờ trong khi đợi các bên tham gia khác).
Before allowing any coordinator replica to apply the commit record, the coordinator leader waits until TT.after(s), so as to obey the commit-wait rule described in Section 4.1.2. Because the coordinator leader chose s based on TT.now().latest, and now waits until that timestamp is guaranteed to be in the past, the expected wait is at least . This wait is typically overlapped with Paxos communication. After commit wait, the coordinator sends the commit timestamp to the client and all other participant leaders. Each participant leader logs the transaction’s outcome through Paxos. All participants apply at the same timestamp and then release locks.
Trước khi cho phép bất kỳ bản sao điều phối nào áp dụng bản ghi xác nhận, trưởng nhóm điều phối đợi cho đến TT.after(s), để tuân theo quy tắc chờ xác nhận được mô tả trong Section 4.1.2. Vì trưởng nhóm điều phối đã chọn s dựa trên TT.now().latest, và bây giờ đợi cho đến khi dấu thời gian đó được đảm bảo đã nằm trong quá khứ, thời gian chờ kỳ vọng ít nhất là . Thời gian chờ này thường được chồng lấp với việc giao tiếp Paxos. Sau thời gian chờ xác nhận, trưởng nhóm điều phối gửi dấu thời gian xác nhận đến máy khách và tất cả các trưởng nhóm tham gia khác. Mỗi trưởng nhóm tham gia ghi kết quả của giao dịch thông qua Paxos. Tất cả các bên tham gia áp dụng cùng một dấu thời gian và sau đó giải phóng các khóa.
4.2.2 Read-Only Transactions
4.2.2 Giao dịch chỉ đọc
Assigning a timestamp requires a negotiation phase between all of the Paxos groups that are involved in the reads. As a result, Spanner requires a scope expression for every read-only transaction, which is an expression that summarizes the keys that will be read by the entire transaction. Spanner automatically infers the scope for standalone queries.
Việc gán một dấu thời gian yêu cầu một pha thương lượng giữa tất cả các nhóm Paxos có liên quan đến các thao tác đọc. Do đó, Spanner yêu cầu một biểu thức phạm vi cho mọi giao dịch chỉ đọc, là một biểu thức tóm tắt các khóa sẽ được đọc bởi toàn bộ giao dịch. Spanner tự động suy ra phạm vi cho các truy vấn độc lập.
If the scope’s values are served by a single Paxos group, then the client issues the read-only transaction to that group’s leader. (The current Spanner implementation only chooses a timestamp for a read-only transaction at a Paxos leader.) That leader assigns and executes the read. For a single-site read, Spanner generally does better than TT.now().latest. Define LastTS() to be the timestamp of the last committed write at a Paxos group. If there are no prepared transactions, the assignment trivially satisfies external consistency: the transaction will see the result of the last write, and therefore be ordered after it.
Nếu các giá trị của phạm vi được phục vụ bởi một nhóm Paxos duy nhất, thì máy khách gửi giao dịch chỉ đọc đến trưởng nhóm của nhóm đó. (Triển khai Spanner hiện tại chỉ chọn một dấu thời gian cho giao dịch chỉ đọc tại một trưởng nhóm Paxos.) Trưởng nhóm đó gán và thực thi thao tác đọc. Đối với một thao tác đọc tại một site duy nhất, Spanner nhìn chung hoạt động tốt hơn TT.now().latest. Định nghĩa LastTS() là dấu thời gian của lần ghi đã xác nhận cuối cùng tại một nhóm Paxos. Nếu không có các giao dịch đã chuẩn bị, phép gán hiển nhiên thỏa mãn tính nhất quán bên ngoài: giao dịch sẽ thấy kết quả của lần ghi cuối cùng, và do đó được sắp xếp sau nó.
If the scope’s values are served by multiple Paxos groups, there are several options. The most complicated option is to do a round of communication with all of the groups’s leaders to negotiate based on LastTS(). Spanner currently implements a simpler choice. The client avoids a negotiation round, and just has its reads execute at (which may wait for safe time to advance). All reads in the transaction can be sent to replicas that are sufficiently up-to-date.
Nếu các giá trị của phạm vi được phục vụ bởi nhiều nhóm Paxos, có một số lựa chọn. Lựa chọn phức tạp nhất là thực hiện một vòng giao tiếp với tất cả các trưởng nhóm của các nhóm đó để thương lượng dựa trên LastTS(). Spanner hiện thực hiện một lựa chọn đơn giản hơn. Máy khách tránh một vòng thương lượng, và chỉ cho các thao tác đọc của nó thực thi tại (điều này có thể phải chờ thời gian an toàn tiến triển). Tất cả các thao tác đọc trong giao dịch có thể được gửi đến các bản sao đủ cập nhật.
4.2.3 Schema-Change Transactions
4.2.3 Giao dịch thay đổi lược đồ
TrueTime enables Spanner to support atomic schema changes. It would be infeasible to use a standard transaction, because the number of participants (the number of groups in a database) could be in the millions. Bigtable supports atomic schema changes in one datacenter, but its schema changes block all operations.
TrueTime cho phép Spanner hỗ trợ các thay đổi lược đồ nguyên tử. Việc sử dụng một giao dịch tiêu chuẩn sẽ không khả thi, bởi vì số lượng bên tham gia (số lượng nhóm trong một cơ sở dữ liệu) có thể lên đến hàng triệu. Bigtable hỗ trợ các thay đổi lược đồ nguyên tử trong một datacenter, nhưng các thay đổi lược đồ của nó chặn mọi thao tác.
A Spanner schema-change transaction is a generally non-blocking variant of a standard transaction. First, it is explicitly assigned a timestamp in the future, which is registered in the prepare phase. As a result, schema changes across thousands of servers can complete with minimal disruption to other concurrent activity. Second, reads and writes, which implicitly depend on the schema, synchronize with any registered schema-change timestamp at time t: they may proceed if their timestamps precede t, but they must block behind the schema-change transaction if their timestamps are after t. Without TrueTime, defining the schema change to happen at t would be meaningless.
Một giao dịch thay đổi lược đồ của Spanner là một biến thể nhìn chung không chặn của một giao dịch tiêu chuẩn. Thứ nhất, nó được gán rõ ràng một dấu thời gian trong tương lai, dấu này được đăng ký trong pha chuẩn bị. Do đó, các thay đổi lược đồ trên hàng nghìn server có thể hoàn tất với sự gián đoạn tối thiểu đối với các hoạt động đồng thời khác. Thứ hai, các thao tác đọc và ghi, vốn phụ thuộc ngầm vào lược đồ, đồng bộ với bất kỳ dấu thời gian thay đổi lược đồ nào đã đăng ký tại thời điểm t: chúng có thể tiếp tục nếu các dấu thời gian của chúng đứng trước t, nhưng chúng phải chặn phía sau giao dịch thay đổi lược đồ nếu các dấu thời gian của chúng đứng sau t. Nếu không có TrueTime, việc định nghĩa thay đổi lược đồ xảy ra tại t sẽ không có ý nghĩa.
| replicas | latency (ms) | throughput (Kops/sec) | ||||
|---|---|---|---|---|---|---|
| write | read-only transaction | snapshot read | write | read-only transaction | snapshot read | |
| 1D | 9.4±.6 | — | — | 4.0±.3 | — | — |
| 1 | 14.4±1.0 | 1.4±.1 | 1.3±.1 | 4.1±.05 | 10.9±.4 | 13.5±.1 |
| 3 | 13.9±.6 | 1.3±.1 | 1.2±.1 | 2.2±.5 | 13.8±3.2 | 38.5±.3 |
| 5 | 14.4±.4 | 1.4±.05 | 1.3±.04 | 2.8±.3 | 25.3±5.2 | 50.0±1.1 |
| bản sao | độ trễ (ms) | thông lượng (Kops/sec) | ||||
|---|---|---|---|---|---|---|
| ghi | giao dịch chỉ đọc | đọc snapshot | ghi | giao dịch chỉ đọc | đọc snapshot | |
| 1D | 9.4±.6 | — | — | 4.0±.3 | — | — |
| 1 | 14.4±1.0 | 1.4±.1 | 1.3±.1 | 4.1±.05 | 10.9±.4 | 13.5±.1 |
| 3 | 13.9±.6 | 1.3±.1 | 1.2±.1 | 2.2±.5 | 13.8±3.2 | 38.5±.3 |
| 5 | 14.4±.4 | 1.4±.05 | 1.3±.04 | 2.8±.3 | 25.3±5.2 | 50.0±1.1 |
Table 3: Operation microbenchmarks. Mean and standard deviation over 10 runs. 1D means one replica with commit wait disabled.
Bảng 3: Các phép đo chuẩn vi mô cho thao tác. Trung bình và độ lệch chuẩn trên 10 lần chạy. 1D nghĩa là một bản sao với thời gian chờ xác nhận bị vô hiệu hóa.
4.2.4 Refinements
4.2.4 Tinh chỉnh
as defined above has a weakness, in that a single prepared transaction prevents from advancing. As a result, no reads can occur at later timestamps, even if the reads do not conflict with the transaction. Such false conflicts can be removed by augmenting with a fine-grained mapping from key ranges to prepared-transaction timestamps. This information can be stored in the lock table, which already maps key ranges to lock metadata. When a read arrives, it only needs to be checked against the fine-grained safe time for key ranges with which the read conflicts.
như được định nghĩa ở trên có một điểm yếu, đó là một giao dịch đã chuẩn bị duy nhất ngăn tiến triển. Do đó, không có thao tác đọc nào có thể xảy ra tại các dấu thời gian muộn hơn, ngay cả khi các thao tác đọc không xung đột với giao dịch. Các xung đột giả như vậy có thể được loại bỏ bằng cách bổ sung cho một ánh xạ chi tiết từ các phạm vi khóa đến các dấu thời gian của giao dịch đã chuẩn bị. Thông tin này có thể được lưu trữ trong bảng khóa, vốn đã ánh xạ các phạm vi khóa tới siêu dữ liệu khóa. Khi một thao tác đọc đến, nó chỉ cần được kiểm tra với thời gian an toàn chi tiết cho các phạm vi khóa mà thao tác đọc đó xung đột.
as defined above has a similar weakness: if a transaction has just committed, a non-conflicting read-only transaction must still be assigned so as to follow that transaction. As a result, the execution of the read could be delayed. This weakness can be remedied similarly by augmenting with a fine-grained mapping from key ranges to commit timestamps in the lock table. (We have not yet implemented this optimization.) When a read-only transaction arrives, its timestamp can be assigned by taking the maximum value of for the key ranges with which the transaction conflicts, unless there is a conflicting prepared transaction (which can be determined from fine-grained safe time).
như được định nghĩa ở trên có một điểm yếu tương tự: nếu một giao dịch vừa được commit, một giao dịch chỉ đọc không xung đột vẫn phải được gán để theo sau giao dịch đó. Do đó, việc thực thi của lần đọc có thể bị trì hoãn. Điểm yếu này có thể được khắc phục tương tự bằng cách bổ sung cho một ánh xạ chi tiết từ các khoảng khóa đến các dấu thời gian commit trong bảng khóa. (Chúng tôi vẫn chưa triển khai tối ưu hóa này.) Khi một giao dịch chỉ đọc đến, dấu thời gian của nó có thể được gán bằng cách lấy giá trị lớn nhất của đối với các khoảng khóa mà giao dịch xung đột, trừ khi có một giao dịch đã chuẩn bị xung đột (có thể được xác định từ thời gian an toàn chi tiết).
as defined above has a weakness in that it cannot advance in the absence of Paxos writes. That is, a snapshot read at cannot execute at Paxos groups whose last write happened before . Spanner addresses this problem by taking advantage of the disjointness of leader-lease intervals. Each Paxos leader advances by keeping a threshold above which future writes’ timestamps will occur: it maintains a mapping from Paxos sequence number to the minimum timestamp that may be assigned to Paxos sequence number . A replica can advance to when it has applied through .
như được định nghĩa ở trên có một điểm yếu là nó không thể tiến triển khi không có các lần ghi Paxos. Nghĩa là, một lần đọc snapshot tại không thể thực thi ở các nhóm Paxos mà lần ghi cuối cùng xảy ra trước . Spanner giải quyết vấn đề này bằng cách tận dụng tính rời nhau của các khoảng thời gian thuê của leader. Mỗi leader Paxos tiến triển bằng cách duy trì một ngưỡng mà phía trên đó các dấu thời gian của các lần ghi trong tương lai sẽ xuất hiện: nó duy trì một ánh xạ từ số thứ tự Paxos đến dấu thời gian tối thiểu có thể được gán cho số thứ tự Paxos . Một replica có thể tiến triển đến khi nó đã áp dụng qua .
A single leader can enforce its promises easily. Because the timestamps promised by lie within a leader’s lease, the disjointness invariant enforces promises across leaders. If a leader wishes to advance beyond the end of its leader lease, it must first extend its lease. Note that is always advanced to the highest value in to preserve disjointness.
Một leader duy nhất có thể dễ dàng thực thi các cam kết của nó. Vì các dấu thời gian được cam kết nằm trong thời gian thuê của một leader, bất biến về tính rời nhau thực thi các cam kết giữa các leader. Nếu một leader muốn tiến triển vượt quá thời điểm kết thúc thời gian thuê của nó, trước tiên nó phải gia hạn thời gian thuê. Lưu ý rằng luôn được tiến triển đến giá trị cao nhất trong để duy trì tính rời nhau.
A leader by default advances values every 8 seconds. Thus, in the absence of prepared transactions, healthy slaves in an idle Paxos group can serve reads at timestamps greater than 8 seconds old in the worst case. A leader may also advance values on demand from slaves.
Một leader mặc định tiến triển các giá trị mỗi 8 giây. Do đó, khi không có các giao dịch đã chuẩn bị, các slave khỏe mạnh trong một nhóm Paxos không hoạt động có thể phục vụ các lần đọc tại các dấu thời gian cũ hơn 8 giây trong trường hợp xấu nhất. Một leader cũng có thể tiến triển các giá trị theo yêu cầu từ các slave.
5 Evaluation
5 Đánh giá
We first measure Spanner’s performance with respect to replication, transactions, and availability. We then provide some data on TrueTime behavior, and a case study of our first client, F1.
Trước tiên, chúng tôi đo hiệu năng của Spanner đối với sao chép, giao dịch và tính sẵn sàng. Sau đó, chúng tôi cung cấp một số dữ liệu về hành vi của TrueTime và một nghiên cứu tình huống về máy khách đầu tiên của chúng tôi, F1.
5.1 Microbenchmarks
5.1 Các phép đo chuẩn vi mô
Table 3 presents some microbenchmarks for Spanner. These measurements were taken on timeshared machines: each spanserver ran on scheduling units of 4GB RAM and 4 cores (AMD Barcelona 2200MHz). Clients were run on separate machines. Each zone contained one spanserver. Clients and zones were placed in a set of datacenters with network distance of less than 1ms. (Such a layout should be commonplace: most applications do not need to distribute all of their data worldwide.) The test database was created with 50 Paxos groups with 2500 directories. Operations were standalone reads and writes of 4KB. All reads were served out of memory after a compaction, so that we are only measuring the overhead of Spanner’s call stack. In addition, one unmeasured round of reads was done first to warm any location caches.
Bảng 3 trình bày một số phép đo chuẩn vi mô cho Spanner. Các phép đo này được thực hiện trên các máy chia sẻ thời gian: mỗi spanserver chạy trên các đơn vị lập lịch gồm 4GB RAM và 4 lõi (AMD Barcelona 2200MHz). Các máy khách được chạy trên các máy riêng biệt. Mỗi zone chứa một spanserver. Các máy khách và zone được đặt trong một tập hợp các trung tâm dữ liệu có khoảng cách mạng nhỏ hơn 1ms. (Một bố cục như vậy nên là phổ biến: hầu hết ứng dụng không cần phân phối toàn bộ dữ liệu của chúng trên toàn thế giới.) Cơ sở dữ liệu kiểm thử được tạo với 50 nhóm Paxos cùng với 2500 thư mục. Các thao tác là các lần đọc và ghi độc lập với kích thước 4KB. Tất cả các lần đọc được phục vụ từ bộ nhớ sau một lần compaction, do đó chúng tôi chỉ đo chi phí phụ trội của call stack của Spanner. Ngoài ra, một vòng đọc không được đo lường được thực hiện trước tiên để làm nóng mọi cache vị trí.
For the latency experiments, clients issued sufficiently few operations so as to avoid queuing at the servers. From the 1-replica experiments, commit wait is about 5ms, and Paxos latency is about 9ms. As the number of replicas increases, the latency stays roughly constant with less standard deviation because Paxos executes in parallel at a group’s replicas. As the number of replicas increases, the latency to achieve a quorum becomes less sensitive to slowness at one slave replica.
Đối với các thí nghiệm về độ trễ, các máy khách phát hành đủ ít thao tác để tránh xếp hàng tại các server. Từ các thí nghiệm 1-replica, thời gian chờ xác nhận là khoảng 5ms, và độ trễ Paxos là khoảng 9ms. Khi số lượng replica tăng lên, độ trễ giữ gần như không đổi với độ lệch chuẩn nhỏ hơn vì Paxos thực thi song song tại các replica của một nhóm. Khi số lượng replica tăng lên, độ trễ để đạt được quorum trở nên ít nhạy cảm hơn với sự chậm chạp tại một replica slave.
For the throughput experiments, clients issued sufficiently many operations so as to saturate the servers’
Đối với các thí nghiệm về thông lượng, các máy khách phát hành đủ nhiều thao tác để bão hòa các CPU của server.
| participants | latency (ms) | |
|---|---|---|
| mean | 99th percentile | |
| 1 | 17.0 ±1.4 | 75.0 ±34.9 |
| 2 | 24.5 ±2.5 | 87.6 ±35.9 |
| 5 | 31.5 ±6.2 | 104.5 ±52.2 |
| 10 | 30.0 ±3.7 | 95.6 ±25.4 |
| 25 | 35.5 ±5.6 | 100.4 ±42.7 |
| 50 | 42.7 ±4.1 | 93.7 ±22.9 |
| 100 | 71.4 ±7.6 | 131.2 ±17.6 |
| 200 | 150.5 ±11.0 | 320.3 ±35.1 |
| participants | latency (ms) | |
|---|---|---|
| mean | 99th percentile | |
| 1 | 17.0 ±1.4 | 75.0 ±34.9 |
| 2 | 24.5 ±2.5 | 87.6 ±35.9 |
| 5 | 31.5 ±6.2 | 104.5 ±52.2 |
| 10 | 30.0 ±3.7 | 95.6 ±25.4 |
| 25 | 35.5 ±5.6 | 100.4 ±42.7 |
| 50 | 42.7 ±4.1 | 93.7 ±22.9 |
| 100 | 71.4 ±7.6 | 131.2 ±17.6 |
| 200 | 150.5 ±11.0 | 320.3 ±35.1 |
Table 4: Two-phase commit scalability. Mean and standard deviations over 10 runs.
Bảng 4: Khả năng mở rộng của xác nhận hai pha. Trung bình và độ lệch chuẩn trên 10 lần chạy.
CPUs. Snapshot reads can execute at any up-to-date replicas, so their throughput increases almost linearly with the number of replicas. Single-read read-only transactions only execute at leaders because timestamp assignment must happen at leaders. Read-only-transaction throughput increases with the number of replicas because the number of effective spanservers increases: in the experimental setup, the number of spanservers equaled the number of replicas, and leaders were randomly distributed among the zones. Write throughput benefits from the same experimental artifact (which explains the increase in throughput from 3 to 5 replicas), but that benefit is outweighed by the linear increase in the amount of work performed per write, as the number of replicas increases.
Các lần đọc snapshot có thể thực thi tại bất kỳ replica nào được cập nhật mới nhất, vì vậy thông lượng của chúng tăng gần tuyến tính với số lượng replica. Các giao dịch chỉ đọc một lần đọc chỉ thực thi tại các leader vì việc gán dấu thời gian phải xảy ra tại các leader. Thông lượng của giao dịch chỉ đọc tăng theo số lượng replica vì số lượng spanserver hiệu dụng tăng lên: trong thiết lập thí nghiệm, số lượng spanserver bằng số lượng replica, và các leader được phân phối ngẫu nhiên giữa các zone. Thông lượng ghi được hưởng lợi từ cùng một hiện tượng thực nghiệm (điều này giải thích sự tăng thông lượng từ 3 đến 5 replica), nhưng lợi ích đó bị lấn át bởi sự gia tăng tuyến tính về lượng công việc được thực hiện cho mỗi lần ghi khi số lượng replica tăng lên.
Table 4 demonstrates that two-phase commit can scale to a reasonable number of participants: it summarizes a set of experiments run across 3 zones, each with 25 spanservers. Scaling up to 50 participants is reasonable in both mean and 99th-percentile, and latencies start to rise noticeably at 100 participants.
Bảng 4 cho thấy xác nhận hai pha có thể mở rộng đến một số lượng participant hợp lý: nó tóm tắt một tập hợp thí nghiệm được thực hiện trên 3 zone, mỗi zone có 25 spanserver. Việc mở rộng lên đến 50 participant là hợp lý cả về giá trị trung bình và phân vị 99, và độ trễ bắt đầu tăng đáng kể tại 100 participant.
Figure 5 illustrates the availability benefits of running Spanner in multiple datacenters. It shows the results of three experiments on throughput in the presence of datacenter failure, all of which are overlaid onto the same time scale. The test universe consisted of 5 zones , each of which had 25 spanservers. The test database was sharded into 1250 Paxos groups, and 100 test clients constantly issued non-snapshot reads at an aggregate rate of 50K reads/second. All of the leaders were explicitly placed in . Five seconds into each test, all of the servers in one zone were killed: non-leader kills ; leader-hard kills ; leader-soft kills , but it gives notifications to all of the servers that they should handoff leadership first.
Hình 5 minh họa các lợi ích về tính sẵn sàng của việc chạy Spanner trong nhiều trung tâm dữ liệu. Hình này cho thấy kết quả của ba thí nghiệm về thông lượng khi có sự cố trung tâm dữ liệu, tất cả được chồng lên cùng một thang thời gian. Không gian kiểm thử bao gồm 5 zone , mỗi zone có 25 spanserver. Cơ sở dữ liệu kiểm thử được phân mảnh thành 1250 nhóm Paxos, và 100 máy khách kiểm thử liên tục phát hành các lần đọc không snapshot với tốc độ tổng hợp 50K reads/second. Tất cả leader được đặt rõ ràng trong . Năm giây sau khi bắt đầu mỗi kiểm thử, tất cả server trong một zone bị tắt: non-leader tắt ; leader-hard tắt ; leader-soft tắt , nhưng nó gửi thông báo đến tất cả server rằng chúng nên chuyển giao quyền lãnh đạo trước tiên.
Killing has no effect on read throughput. Killing while giving the leaders time to handoff leadership to a different zone has a minor effect: the throughput drop is not visible in the graph, but is around 3-4%. On the other hand, killing with no warning has a severe effect: the rate of completion drops almost to 0. As leaders get re-elected, though, the throughput of the system rises to approximately 100K reads/second because of two artifacts of our experiment: there is extra capacity in the system, and operations are queued while the leader is unavailable. As a result, the throughput of the system rises before leveling off again at its steady-state rate.
Việc tắt không có ảnh hưởng đến thông lượng đọc. Việc tắt trong khi cho các leader thời gian để chuyển giao quyền lãnh đạo sang một zone khác có ảnh hưởng nhỏ: sự sụt giảm thông lượng không nhìn thấy trong đồ thị, nhưng vào khoảng 3-4%. Mặt khác, việc tắt mà không có cảnh báo gây ảnh hưởng nghiêm trọng: tốc độ hoàn thành giảm gần về 0. Tuy nhiên, khi các leader được bầu lại, thông lượng của hệ thống tăng lên xấp xỉ 100K reads/second do hai hiện tượng thực nghiệm: hệ thống có thêm công suất và các thao tác được xếp hàng trong khi leader không khả dụng. Do đó, thông lượng của hệ thống tăng lên trước khi lại ổn định ở tốc độ ổn định của nó.
We can also see the effect of the fact that Paxos leader leases are set to 10 seconds. When we kill the zone, the leader-lease expiration times for the groups should be evenly distributed over the next 10 seconds. Soon after each lease from a dead leader expires, a new leader is elected. Approximately 10 seconds after the kill time, all of the groups have leaders and throughput has recovered. Shorter lease times would reduce the effect of server deaths on availability, but would require greater amounts of lease-renewal network traffic. We are in the process of designing and implementing a mechanism that will cause slaves to release Paxos leader leases upon leader failure.
Chúng tôi cũng có thể thấy ảnh hưởng của thực tế rằng các lease leader Paxos được đặt thành 10 giây. Khi chúng tôi tắt zone, thời điểm hết hạn lease leader cho các nhóm phải được phân phối đều trong 10 giây tiếp theo. Ngay sau khi mỗi lease từ một leader đã chết hết hạn, một leader mới được bầu. Khoảng 10 giây sau thời điểm tắt, tất cả các nhóm đều có leader và thông lượng đã được khôi phục. Thời gian lease ngắn hơn sẽ làm giảm ảnh hưởng của việc server chết đối với tính sẵn sàng, nhưng sẽ yêu cầu lượng lưu lượng mạng gia hạn lease lớn hơn. Chúng tôi đang trong quá trình thiết kế và triển khai một cơ chế sẽ khiến các slave giải phóng lease leader Paxos khi leader gặp sự cố.
5.2 Availability
5.2 Tính khả dụng
5.3 TrueTime
5.3 TrueTime
Two questions must be answered with respect to TrueTime: is truly a bound on clock uncertainty, and how bad does get? For the former, the most serious problem would be if a local clock’s drift were greater than 200us/sec: that would break assumptions made by TrueTime. Our machine statistics show that bad CPUs are 6 times more likely than bad clocks. That is, clock issues are extremely infrequent, relative to much more serious hardware problems. As a result, we believe that TrueTime’s implementation is as trustworthy as any other piece of software upon which Spanner depends.
Có hai câu hỏi cần được trả lời liên quan đến TrueTime: liệu có thực sự là một cận của độ bất định đồng hồ hay không, và có thể trở nên tệ đến mức nào? Đối với câu hỏi đầu tiên, vấn đề nghiêm trọng nhất sẽ xảy ra nếu độ trôi của đồng hồ cục bộ lớn hơn 200us/sec: điều đó sẽ phá vỡ các giả định mà TrueTime đưa ra. Thống kê máy của chúng tôi cho thấy các CPU lỗi có khả năng xảy ra cao hơn 6 lần so với các đồng hồ lỗi. Nghĩa là, các vấn đề về đồng hồ cực kỳ hiếm gặp so với những vấn đề phần cứng nghiêm trọng hơn nhiều. Do đó, chúng tôi tin rằng triển khai của TrueTime đáng tin cậy như bất kỳ phần mềm nào khác mà Spanner phụ thuộc vào.
Figure 6 presents TrueTime data taken at several thousand spanserver machines across datacenters up to 2200 km apart. It plots the 90th, 99th, and 99.9th percentiles of , sampled at timeslave daemons immediately after polling the time masters. This sampling elides the sawtooth in due to local-clock uncertainty, and therefore measures time-master uncertainty (which is generally 0) plus communication delay to the time masters.
Hình 6 trình bày dữ liệu TrueTime được lấy từ vài nghìn máy spanserver trên các datacenter cách nhau tới 2200 km. Hình này biểu diễn các phân vị thứ 90, 99 và 99.9 của , được lấy mẫu tại các timeslave daemon ngay sau khi thăm dò các time master. Việc lấy mẫu này loại bỏ dạng răng cưa trong do độ bất định của đồng hồ cục bộ, và vì vậy đo độ bất định của time-master (thường là 0) cộng với độ trễ truyền thông tới các time master.
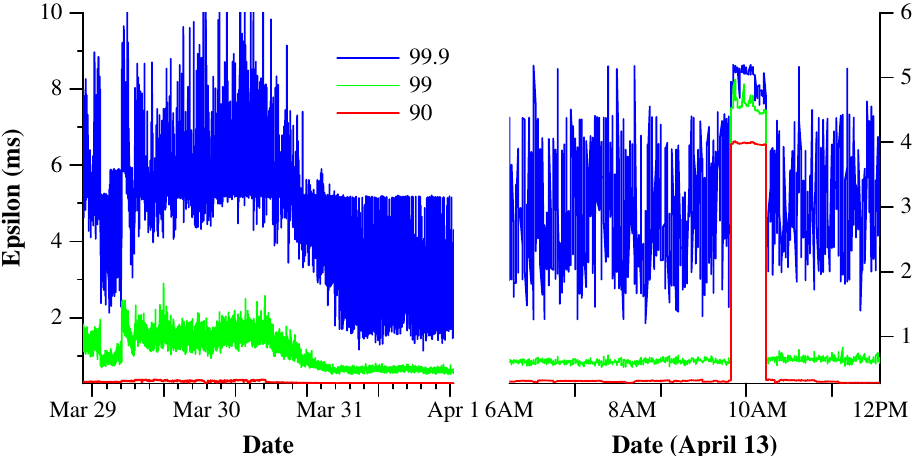
The data shows that these two factors in determining the base value of are generally not a problem. However, there can be significant tail-latency issues that cause higher values of . The reduction in tail latencies beginning on March 30 were due to networking improvements that reduced transient network-link congestion. The increase in on April 13, approximately one hour in duration, resulted from the shutdown of 2 time masters at a datacenter for routine maintenance. We continue to investigate and remove causes of TrueTime spikes.
Dữ liệu cho thấy hai yếu tố này trong việc xác định giá trị cơ sở của nhìn chung không phải là vấn đề. Tuy nhiên, có thể có các vấn đề độ trễ đuôi đáng kể gây ra các giá trị cao hơn. Việc giảm độ trễ đuôi bắt đầu từ ngày 30 tháng 3 là do các cải tiến về mạng làm giảm tắc nghẽn tạm thời trên liên kết mạng. Sự gia tăng vào ngày 13 tháng 4, kéo dài khoảng một giờ, là do việc tắt 2 time master tại một datacenter để bảo trì định kỳ. Chúng tôi tiếp tục điều tra và loại bỏ các nguyên nhân gây ra các đột biến của TrueTime.
5.4 F1
5.4 F1
Spanner started being experimentally evaluated under production workloads in early 2011, as part of a rewrite of Google’s advertising backend called F1 [35]. This backend was originally based on a MySQL database that was manually sharded many ways. The uncompressed dataset is tens of terabytes, which is small compared to many NoSQL instances, but was large enough to cause difficulties with sharded MySQL. The MySQL sharding scheme assigned each customer and all related data to a fixed shard. This layout enabled the use of indexes and complex query processing on a per-customer basis, but required some knowledge of the sharding in application business logic. Resharding this revenue-critical database as it grew in the number of customers and their data was extremely costly. The last resharding took over two years of intense effort, and involved coordination and testing across dozens of teams to minimize risk. This operation was too complex to do regularly: as a result, the team had to limit growth on the MySQL database by storing some data in external Bigtables, which compromised transactional behavior and the ability to query across all data.
Spanner bắt đầu được đánh giá thử nghiệm dưới các tải công việc sản xuất vào đầu năm 2011, như một phần của việc viết lại backend quảng cáo của Google có tên F1 [35]. Backend này ban đầu dựa trên một cơ sở dữ liệu MySQL được phân mảnh thủ công theo nhiều cách. Tập dữ liệu chưa nén có kích thước hàng chục terabyte, nhỏ so với nhiều phiên bản NoSQL, nhưng đủ lớn để gây khó khăn với MySQL đã phân mảnh. Cơ chế sharding của MySQL gán mỗi khách hàng và toàn bộ dữ liệu liên quan vào một shard cố định. Bố cục này cho phép sử dụng các chỉ mục và xử lý truy vấn phức tạp theo từng khách hàng, nhưng yêu cầu một số kiến thức về sharding trong logic nghiệp vụ của ứng dụng. Việc phân mảnh lại cơ sở dữ liệu quan trọng về doanh thu này khi số lượng khách hàng và dữ liệu của họ tăng lên có chi phí cực kỳ lớn. Lần phân mảnh lại cuối cùng mất hơn hai năm nỗ lực cao độ, và liên quan đến việc phối hợp và kiểm thử giữa hàng chục nhóm để giảm thiểu rủi ro. Thao tác này quá phức tạp để thực hiện thường xuyên: do đó, nhóm phải hạn chế sự tăng trưởng trên cơ sở dữ liệu MySQL bằng cách lưu trữ một số dữ liệu trong các Bigtables bên ngoài, điều này làm ảnh hưởng đến hành vi giao dịch và khả năng truy vấn trên toàn bộ dữ liệu.
The F1 team chose to use Spanner for several reasons. First, Spanner removes the need to manually re-shard. Second, Spanner provides synchronous replication and automatic failover. With MySQL master-slave replication, failover was difficult, and risked data loss and downtime. Third, F1 requires strong transactional semantics, which made using other NoSQL systems impractical. Application semantics requires transactions across arbitrary data, and consistent reads. The F1 team also needed secondary indexes on their data (since Spanner does not yet provide automatic support for secondary indexes), and was able to implement their own consistent global indexes using Spanner transactions.
Nhóm F1 chọn sử dụng Spanner vì một số lý do. Thứ nhất, Spanner loại bỏ nhu cầu phân mảnh lại thủ công. Thứ hai, Spanner cung cấp sao chép đồng bộ và chuyển đổi dự phòng tự động. Với sao chép master-slave của MySQL, chuyển đổi dự phòng rất khó khăn và có nguy cơ mất dữ liệu cũng như thời gian ngừng hoạt động. Thứ ba, F1 yêu cầu ngữ nghĩa giao dịch mạnh, khiến việc sử dụng các hệ thống NoSQL khác trở nên không thực tế. Ngữ nghĩa ứng dụng yêu cầu các giao dịch trên dữ liệu tùy ý và các lần đọc nhất quán. Nhóm F1 cũng cần các chỉ mục thứ cấp trên dữ liệu của họ (vì Spanner chưa cung cấp hỗ trợ tự động cho các chỉ mục thứ cấp), và có thể tự triển khai các chỉ mục toàn cục nhất quán bằng cách sử dụng các giao dịch Spanner.
All application writes are now by default sent through F1 to Spanner, instead of the MySQL-based application stack. F1 has 2 replicas on the west coast of the US, and 3 on the east coast. This choice of replica sites was made to cope with outages due to potential major natural disasters, and also the choice of their frontend sites. Anecdotally, Spanner’s automatic failover has been nearly invisible to them. Although there have been unplanned cluster failures in the last few months, the most that the F1 team has had to do is update their database’s schema to tell Spanner where to preferentially place Paxos leaders, so as to keep them close to where their frontends moved.
Tất cả các ghi ứng dụng hiện được mặc định gửi qua F1 tới Spanner, thay vì ngăn xếp ứng dụng dựa trên MySQL. F1 có 2 bản sao ở bờ tây của Mỹ, và 3 bản sao ở bờ đông. Lựa chọn các site bản sao này được thực hiện để đối phó với các sự cố ngừng hoạt động do các thảm họa tự nhiên lớn có thể xảy ra, đồng thời cũng dựa trên lựa chọn các site frontend của họ. Theo quan sát không chính thức, chuyển đổi dự phòng tự động của Spanner gần như không thể nhận thấy đối với họ. Mặc dù đã có các sự cố cụm không được lên kế hoạch trong vài tháng gần đây, điều duy nhất mà nhóm F1 phải làm nhiều nhất là cập nhật lược đồ cơ sở dữ liệu của họ để cho Spanner biết nơi ưu tiên đặt các leader Paxos, nhằm giữ chúng gần nơi các frontend của họ đã di chuyển đến.
Spanner’s timestamp semantics made it efficient for F1 to maintain in-memory data structures computed from the database state. F1 maintains a logical history log of all changes, which is written into Spanner itself as part of every transaction. F1 takes full snapshots of data at a timestamp to initialize its data structures, and then reads incremental changes to update them.
Ngữ nghĩa dấu thời gian của Spanner giúp F1 duy trì hiệu quả các cấu trúc dữ liệu trong bộ nhớ được tính toán từ trạng thái cơ sở dữ liệu. F1 duy trì một nhật ký lịch sử logic của tất cả thay đổi, được ghi vào chính Spanner như một phần của mỗi giao dịch. F1 lấy các snapshot đầy đủ của dữ liệu tại một dấu thời gian để khởi tạo các cấu trúc dữ liệu của mình, sau đó đọc các thay đổi gia tăng để cập nhật chúng.
Table 5 illustrates the distribution of the number of fragments per directory in F1. Each directory typically corresponds to a customer in the application stack above F1. The vast majority of directories (and therefore customers) consist of only 1 fragment, which means that reads and writes to those customers’ data are guaranteed to occur on only a single server. The directories with more than 100 fragments are all tables that contain F1 secondary indexes: writes to more than a few fragments
Bảng 5 minh họa phân phối số lượng mảnh trên mỗi thư mục trong F1. Mỗi thư mục thường tương ứng với một khách hàng trong ngăn xếp ứng dụng phía trên F1. Phần lớn áp đảo các thư mục (và do đó là khách hàng) chỉ bao gồm 1 mảnh, điều này có nghĩa là các lần đọc và ghi dữ liệu của những khách hàng đó được đảm bảo chỉ xảy ra trên một server duy nhất. Các thư mục có hơn 100 mảnh đều là các bảng chứa các chỉ mục thứ cấp của F1: các lần ghi tới nhiều hơn một vài mảnh
| operation | latency (ms) | count | |
|---|---|---|---|
| mean | std dev | ||
| all reads | 8.7 | 376.4 | 21.5B |
| single-site commit | 72.3 | 112.8 | 31.2M |
| multi-site commit | 103.0 | 52.2 | 32.1M |
| operation | latency (ms) | count | |
|---|---|---|---|
| mean | std dev | ||
| all reads | 8.7 | 376.4 | 21.5B |
| single-site commit | 72.3 | 112.8 | 31.2M |
| multi-site commit | 103.0 | 52.2 | 32.1M |
Table 6: F1-perceived operation latencies measured over the course of 24 hours.
Bảng 6: Độ trễ thao tác được F1 cảm nhận được đo trong khoảng thời gian 24 giờ.
of such tables are extremely uncommon. The F1 team has only seen such behavior when they do untuned bulk data loads as transactions.
của các bảng như vậy cực kỳ hiếm gặp. Nhóm F1 chỉ quan sát thấy hành vi như vậy khi họ thực hiện các lần nạp dữ liệu hàng loạt chưa được tinh chỉnh dưới dạng các giao dịch.
Table 6 presents Spanner operation latencies as measured from F1 servers. Replicas in the east-coast data centers are given higher priority in choosing Paxos leaders. The data in the table is measured from F1 servers in those data centers. The large standard deviation in write latencies is caused by a pretty fat tail due to lock conflicts. The even larger standard deviation in read latencies is partially due to the fact that Paxos leaders are spread across two data centers, only one of which has machines with SSDs. In addition, the measurement includes every read in the system from two datacenters: the mean and standard deviation of the bytes read were roughly 1.6KB and 119KB, respectively.
Bảng 6 trình bày độ trễ của các thao tác Spanner được đo từ các server F1. Các bản sao trong các trung tâm dữ liệu ở bờ đông được ưu tiên cao hơn trong việc chọn các leader Paxos. Dữ liệu trong bảng được đo từ các server F1 trong các trung tâm dữ liệu đó. Độ lệch chuẩn lớn của độ trễ ghi là do phần đuôi khá lớn gây ra bởi các xung đột khóa. Độ lệch chuẩn thậm chí còn lớn hơn của độ trễ đọc một phần là do thực tế rằng các leader Paxos được phân bố trên hai trung tâm dữ liệu, chỉ một trong số đó có các máy với SSD. Ngoài ra, phép đo bao gồm mọi lần đọc trong hệ thống từ hai trung tâm dữ liệu: giá trị trung bình và độ lệch chuẩn của số byte được đọc lần lượt xấp xỉ là 1.6KB và 119KB.
6 Related Work
6 Công trình liên quan
Consistent replication across datacenters as a storage service has been provided by Megastore [5] and DynamoDB [3]. DynamoDB presents a key-value interface, and only replicates within a region. Spanner follows Megastore in providing a semi-relational data model, and even a similar schema language. Megastore does not achieve high performance. It is layered on top of Bigtable, which imposes high communication costs. It also does not support long-lived leaders: multiple replicas may initiate writes. All writes from different replicas necessarily conflict in the Paxos protocol, even if they do not logically conflict: throughput collapses on a Paxos group at several writes per second. Spanner provides higher performance, general-purpose transactions, and external consistency.
Sao chép nhất quán trên các datacenter như một dịch vụ lưu trữ đã được cung cấp bởi Megastore [5] và DynamoDB [3]. DynamoDB cung cấp một giao diện khóa-giá trị, và chỉ sao chép trong phạm vi một vùng. Spanner tiếp nối Megastore trong việc cung cấp một mô hình dữ liệu bán quan hệ, và thậm chí cả một ngôn ngữ lược đồ tương tự. Megastore không đạt được hiệu năng cao. Nó được xây dựng trên Bigtable, vốn áp đặt chi phí giao tiếp cao. Nó cũng không hỗ trợ các leader tồn tại lâu dài: nhiều bản sao có thể khởi tạo việc ghi. Tất cả các thao tác ghi từ các bản sao khác nhau tất yếu xung đột trong giao thức Paxos, ngay cả khi chúng không xung đột về mặt logic: thông lượng sụp đổ trên một nhóm Paxos ở mức vài thao tác ghi mỗi giây. Spanner cung cấp hiệu năng cao hơn, các giao dịch đa dụng, và tính nhất quán bên ngoài.
Pavlo et al. [31] have compared the performance of databases and MapReduce [12]. They point to several other efforts that have been made to explore database functionality layered on distributed key-value stores [1, 4, 7, 41] as evidence that the two worlds are converging. We agree with the conclusion, but demonstrate that integrating multiple layers has its advantages: integrating concurrency control with replication reduces the cost of commit wait in Spanner, for example.
Pavlo et al. [31] đã so sánh hiệu năng của các cơ sở dữ liệu và MapReduce [12]. Họ chỉ ra một số nỗ lực khác đã được thực hiện để khám phá chức năng cơ sở dữ liệu được xây dựng trên các kho khóa-giá trị phân tán [1, 4, 7, 41] như bằng chứng rằng hai thế giới đang hội tụ. Chúng tôi đồng ý với kết luận này, nhưng chứng minh rằng việc tích hợp nhiều tầng có những ưu điểm: ví dụ, tích hợp kiểm soát đồng thời với sao chép làm giảm chi phí chờ xác nhận trong Spanner.
The notion of layering transactions on top of a replicated store dates at least as far back as Gifford’s dissertation [16]. Scatter [17] is a recent DHT-based key-value store that layers transactions on top of consistent replication. Spanner focuses on providing a higher-level interface than Scatter does. Gray and Lamport [18] describe a non-blocking commit protocol based on Paxos. Their protocol incurs more messaging costs than two-phase commit, which would aggravate the cost of commit over widely distributed groups. Walter [36] provides a variant of snapshot isolation that works within, but not across datacenters. In contrast, our read-only transactions provide a more natural semantics, because we support external consistency over all operations.
Khái niệm xây dựng các giao dịch trên một kho được sao chép có lịch sử ít nhất từ luận án của Gifford [16]. Scatter [17] là một kho khóa-giá trị dựa trên DHT gần đây, xây dựng các giao dịch trên lớp sao chép nhất quán. Spanner tập trung vào việc cung cấp một giao diện cấp cao hơn so với Scatter. Gray và Lamport [18] mô tả một giao thức xác nhận không chặn dựa trên Paxos. Giao thức của họ phát sinh nhiều chi phí thông điệp hơn so với xác nhận hai pha, điều này sẽ làm trầm trọng thêm chi phí xác nhận trên các nhóm được phân tán rộng rãi. Walter [36] cung cấp một biến thể của cô lập ảnh chụp nhanh hoạt động trong phạm vi một datacenter, nhưng không hoạt động xuyên qua các datacenter. Ngược lại, các giao dịch chỉ đọc của chúng tôi cung cấp một ngữ nghĩa tự nhiên hơn, bởi vì chúng tôi hỗ trợ tính nhất quán bên ngoài trên tất cả các thao tác.
There has been a spate of recent work on reducing or eliminating locking overheads. Calvin [40] eliminates concurrency control: it pre-assigns timestamps and then executes the transactions in timestamp order. H-Store [39] and Granola [11] each supported their own classification of transaction types, some of which could avoid locking. None of these systems provides external consistency. Spanner addresses the contention issue by providing support for snapshot isolation.
Đã có một loạt công trình gần đây về việc giảm hoặc loại bỏ chi phí phụ trội của khóa. Calvin [40] loại bỏ kiểm soát đồng thời: nó gán trước các dấu thời gian và sau đó thực thi các giao dịch theo thứ tự dấu thời gian. H-Store [39] và Granola [11] mỗi hệ thống đều hỗ trợ cách phân loại riêng của chúng về các kiểu giao dịch, một số trong đó có thể tránh khóa. Không hệ thống nào trong số này cung cấp tính nhất quán bên ngoài. Spanner giải quyết vấn đề tranh chấp bằng cách cung cấp hỗ trợ cho cô lập ảnh chụp nhanh.
VoltDB [42] is a sharded in-memory database that supports master-slave replication over the wide area for disaster recovery, but not more general replication configurations. It is an example of what has been called NewSQL, which is a marketplace push to support scalable SQL [38]. A number of commercial databases implement reads in the past, such as MarkLogic [26] and Oracle’s Total Recall [30]. Lomet and Li [24] describe an implementation strategy for such a temporal database.
VoltDB [42] là một cơ sở dữ liệu trong bộ nhớ được phân mảnh hỗ trợ sao chép chủ-tớ trên diện rộng để khôi phục sau thảm họa, nhưng không hỗ trợ các cấu hình sao chép tổng quát hơn. Nó là một ví dụ về thứ được gọi là NewSQL, vốn là một sự thúc đẩy của thị trường nhằm hỗ trợ SQL có khả năng mở rộng [38]. Một số cơ sở dữ liệu thương mại triển khai việc đọc trong quá khứ, chẳng hạn như MarkLogic [26] và Oracle’s Total Recall [30]. Lomet và Li [24] mô tả một chiến lược triển khai cho một cơ sở dữ liệu thời gian như vậy.
Farsite derived bounds on clock uncertainty (much looser than TrueTime’s) relative to a trusted clock reference [13]: server leases in Farsite were maintained in the same way that Spanner maintains Paxos leases. Loosely synchronized clocks have been used for concurrency-control purposes in prior work [2, 23]. We have shown that TrueTime lets one reason about global time across sets of Paxos state machines.
Farsite suy ra các cận về độ không chắc chắn của đồng hồ (lớn hơn nhiều so với của TrueTime) so với một tham chiếu đồng hồ đáng tin cậy [13]: các hợp đồng thuê server trong Farsite được duy trì theo cùng cách mà Spanner duy trì các hợp đồng thuê Paxos. Các đồng hồ được đồng bộ lỏng đã được sử dụng cho các mục đích kiểm soát đồng thời trong các công trình trước đây [2, 23]. Chúng tôi đã chỉ ra rằng TrueTime cho phép suy luận về thời gian toàn cục trên các tập hợp máy trạng thái Paxos.
7 Future Work
7 Công việc tương lai
We have spent most of the last year working with the F1 team to transition Google’s advertising backend from MySQL to Spanner. We are actively improving its monitoring and support tools, as well as tuning its performance. In addition, we have been working on improving the functionality and performance of our backup/restore system. We are currently implementing the Spanner schema language, automatic maintenance of secondary indices, and automatic load-based resharding. Longer term, there are a couple of features that we plan to investigate. Optimistically doing reads in parallel may be a valuable strategy to pursue, but initial experiments have indicated that the right implementation is non-trivial. In addition, we plan to eventually support direct changes of Paxos configurations [22, 34].
Chúng tôi đã dành phần lớn năm vừa qua làm việc với đội F1 để chuyển backend quảng cáo của Google từ MySQL sang Spanner. Chúng tôi đang tích cực cải thiện các công cụ giám sát và hỗ trợ của nó, cũng như tinh chỉnh hiệu năng của nó. Ngoài ra, chúng tôi đã làm việc để cải thiện chức năng và hiệu năng của hệ thống sao lưu/khôi phục của mình. Hiện tại chúng tôi đang triển khai ngôn ngữ lược đồ Spanner, việc bảo trì tự động các chỉ mục phụ, và việc tái phân mảnh tự động dựa trên tải. Về lâu dài, có một vài tính năng mà chúng tôi dự định nghiên cứu. Việc thực hiện các đọc song song một cách lạc quan có thể là một chiến lược đáng theo đuổi, nhưng các thử nghiệm ban đầu đã chỉ ra rằng việc triển khai đúng là không tầm thường. Ngoài ra, chúng tôi dự định cuối cùng sẽ hỗ trợ các thay đổi trực tiếp của các cấu hình Paxos [22, 34].
Given that we expect many applications to replicate their data across datacenters that are relatively close to each other, TrueTime may noticeably affect performance. We see no insurmountable obstacle to reducing below 1ms. Time-master-query intervals can be reduced, and better clock crystals are relatively cheap. Time-master query latency could be reduced with improved networking technology, or possibly even avoided through alternate time-distribution technology.
Do chúng tôi kỳ vọng nhiều ứng dụng sẽ sao chép dữ liệu của chúng trên các trung tâm dữ liệu tương đối gần nhau, TrueTime có thể ảnh hưởng đáng kể đến hiệu năng. Chúng tôi không thấy trở ngại không thể vượt qua nào trong việc giảm xuống dưới 1ms. Các khoảng thời gian truy vấn time-master có thể được giảm xuống, và các tinh thể đồng hồ tốt hơn tương đối rẻ. Độ trễ truy vấn time-master có thể được giảm bằng công nghệ mạng được cải thiện, hoặc thậm chí có thể được tránh thông qua công nghệ phân phối thời gian thay thế.
Finally, there are obvious areas for improvement. Although Spanner is scalable in the number of nodes, the node-local data structures have relatively poor performance on complex SQL queries, because they were designed for simple key-value accesses. Algorithms and data structures from DB literature could improve single-node performance a great deal. Second, moving data automatically between datacenters in response to changes in client load has long been a goal of ours, but to make that goal effective, we would also need the ability to move client-application processes between datacenters in an automated, coordinated fashion. Moving processes raises the even more difficult problem of managing resource acquisition and allocation between datacenters.
Cuối cùng, có những lĩnh vực rõ ràng cần cải thiện. Mặc dù Spanner có khả năng mở rộng theo số lượng nút, các cấu trúc dữ liệu cục bộ của nút có hiệu năng tương đối kém đối với các truy vấn SQL phức tạp, bởi vì chúng được thiết kế cho các truy cập key-value đơn giản. Các thuật toán và cấu trúc dữ liệu từ tài liệu DB có thể cải thiện đáng kể hiệu năng của một nút đơn. Thứ hai, việc di chuyển dữ liệu tự động giữa các trung tâm dữ liệu để phản hồi các thay đổi trong tải của máy khách từ lâu đã là mục tiêu của chúng tôi, nhưng để mục tiêu đó có hiệu quả, chúng tôi cũng cần khả năng di chuyển các tiến trình ứng dụng máy khách giữa các trung tâm dữ liệu theo cách tự động, phối hợp. Việc di chuyển các tiến trình đặt ra vấn đề còn khó khăn hơn nữa về quản lý việc thu nhận và phân bổ tài nguyên giữa các trung tâm dữ liệu.
8 Conclusions
8 Kết luận
To summarize, Spanner combines and extends on ideas from two research communities: from the database community, a familiar, easy-to-use, semi-relational interface, transactions, and an SQL-based query language; from the systems community, scalability, automatic sharding, fault tolerance, consistent replication, external consistency, and wide-area distribution. Since Spanner’s inception, we have taken more than 5 years to iterate to the current design and implementation. Part of this long iteration phase was due to a slow realization that Spanner should do more than tackle the problem of a globally-replicated namespace, and should also focus on database features that Bigtable was missing.
Tóm lại, Spanner kết hợp và mở rộng các ý tưởng từ hai cộng đồng nghiên cứu: từ cộng đồng cơ sở dữ liệu, một giao diện bán quan hệ quen thuộc, dễ sử dụng, các giao dịch, và một ngôn ngữ truy vấn dựa trên SQL; từ cộng đồng hệ thống, khả năng mở rộng, phân mảnh tự động, khả năng chịu lỗi, sao chép nhất quán, tính nhất quán bên ngoài, và phân phối diện rộng. Kể từ khi Spanner ra đời, chúng tôi đã mất hơn 5 năm để lặp lại qua các phiên bản nhằm đạt đến thiết kế và triển khai hiện tại. Một phần của giai đoạn lặp lại dài này là do việc nhận ra chậm rằng Spanner nên làm nhiều hơn việc giải quyết vấn đề về một không gian tên được sao chép toàn cầu, và cũng nên tập trung vào các tính năng cơ sở dữ liệu mà Bigtable còn thiếu.
One aspect of our design stands out: the linchpin of Spanner’s feature set is TrueTime. We have shown that reifying clock uncertainty in the time API makes it possible to build distributed systems with much stronger time semantics. In addition, as the underlying system enforces tighter bounds on clock uncertainty, the overhead of the stronger semantics decreases. As a community, we should no longer depend on loosely synchronized clocks and weak time APIs in designing distributed algorithms.
Một khía cạnh trong thiết kế của chúng tôi nổi bật: yếu tố then chốt trong tập tính năng của Spanner là TrueTime. Chúng tôi đã chỉ ra rằng việc hiện thực hóa sự không chắc chắn của đồng hồ trong API thời gian giúp có thể xây dựng các hệ thống phân tán với ngữ nghĩa thời gian mạnh hơn nhiều. Ngoài ra, khi hệ thống nền tảng áp đặt các cận chặt chẽ hơn về sự không chắc chắn của đồng hồ, chi phí phụ trội của ngữ nghĩa mạnh hơn sẽ giảm xuống. Là một cộng đồng, chúng ta không nên còn phụ thuộc vào các đồng hồ được đồng bộ lỏng lẻo và các API thời gian yếu trong việc thiết kế các thuật toán phân tán.
Acknowledgments
Lời cảm ơn
Many people have helped to improve this paper: our shepherd Jon Howell, who went above and beyond his responsibilities; the anonymous referees; and many Googlers: Atul Adya, Fay Chang, Frank Dabek, Sean Dorward, Bob Gruber, David Held, Nick Kline, Alex Thomson, and Joel Wein. Our management has been very supportive of both our work and of publishing this paper: Aristotle Balogh, Bill Coughran, Urs Hölzle, Doron Meyer, Cos Nicolaou, Kathy Polizzi, Sridhar Ramaswamy, and Shivakumar Venkataraman.
Nhiều người đã giúp cải thiện bài báo này: người hỗ trợ của chúng tôi Jon Howell, người đã vượt xa trách nhiệm của mình; các phản biện ẩn danh; và nhiều Googler: Atul Adya, Fay Chang, Frank Dabek, Sean Dorward, Bob Gruber, David Held, Nick Kline, Alex Thomson, và Joel Wein. Ban quản lý của chúng tôi đã rất ủng hộ cả công việc của chúng tôi lẫn việc xuất bản bài báo này: Aristotle Balogh, Bill Coughran, Urs Hölzle, Doron Meyer, Cos Nicolaou, Kathy Polizzi, Sridhar Ramaswamy, và Shivakumar Venkataraman.
We have built upon the work of the Bigtable and Megastore teams. The F1 team, and Jeff Shute in particular, worked closely with us in developing our data model and helped immensely in tracking down performance and correctness bugs. The Platforms team, and Luiz Barroso and Bob Felderman in particular, helped to make True-Time happen. Finally, a lot of Googlers used to be on our team: Ken Ashcraft, Paul Cychosz, Krzysztof Ostrowski, Amir Voskoboynik, Matthew Weaver, Theo Vassilakis, and Eric Veach; or have joined our team recently: Nathan Bales, Adam Beberg, Vadim Borisov, Ken Chen, Brian Cooper, Cian Cullinan, Robert-Jan Huijsman, Milind Joshi, Andrey Khorlin, Dawid Kuroczko, Laramie Leavitt, Eric Li, Mike Mammarella, Sunil Mushran, Simon Nielsen, Ovidiu Platon, Ananth Shrinivas, Vadim Susvorov, and Marcel van der Holst.
Chúng tôi đã xây dựng dựa trên công việc của các nhóm Bigtable và Megastore. Nhóm F1, đặc biệt là Jeff Shute, đã làm việc chặt chẽ với chúng tôi trong việc phát triển mô hình dữ liệu của chúng tôi và đã giúp rất nhiều trong việc truy tìm các lỗi về hiệu năng và tính đúng đắn. Nhóm Platforms, đặc biệt là Luiz Barroso và Bob Felderman, đã giúp biến True-Time thành hiện thực. Cuối cùng, nhiều Googler từng thuộc nhóm của chúng tôi: Ken Ashcraft, Paul Cychosz, Krzysztof Ostrowski, Amir Voskoboynik, Matthew Weaver, Theo Vassilakis, và Eric Veach; hoặc đã gia nhập nhóm của chúng tôi gần đây: Nathan Bales, Adam Beberg, Vadim Borisov, Ken Chen, Brian Cooper, Cian Cullinan, Robert-Jan Huijsman, Milind Joshi, Andrey Khorlin, Dawid Kuroczko, Laramie Leavitt, Eric Li, Mike Mammarella, Sunil Mushran, Simon Nielsen, Ovidiu Platon, Ananth Shrinivas, Vadim Susvorov, và Marcel van der Holst.
References
- Azza Abouzeid et al. “HadoopDB: an architectural hybrid of MapReduce and DBMS technologies for analytical workloads”. Proc. of VLDB. 2009, pp. 922–933.
- A. Adya et al. “Efficient optimistic concurrency control using loosely synchronized clocks”. Proc. of SIGMOD. 1995, pp. 23–34.
- Amazon. Amazon DynamoDB. 2012.
- Michael Armbrust et al. “PIQL: Success-Tolerant Query Processing in the Cloud”. Proc. of VLDB. 2011, pp. 181–192.
- Jason Baker et al. “Megastore: Providing Scalable, Highly Available Storage for Interactive Services”. Proc. of CIDR. 2011, pp. 223–234.
- Hal Berenson et al. “A critique of ANSI SQL isolation levels”. Proc. of SIGMOD. 1995, pp. 1–10.
- Matthias Brantner et al. “Building a database on S3”. Proc. of SIGMOD. 2008, pp. 251–264.
- A. Chan and R. Gray. “Implementing Distributed Read-Only Transactions”. IEEE TOSE SE-11.2 (Feb. 1985), pp. 205–212.
- Fay Chang et al. “Bigtable: A Distributed Storage System for Structured Data”. ACM TOCS 26.2 (June 2008), 4:1–4:26.
- Brian F. Cooper et al. “PNUTS: Yahoo!’s hosted data serving platform”. Proc. of VLDB. 2008, pp. 1277–1288.
- James Cowling and Barbara Liskov. “Granola: Low-Overhead Distributed Transaction Coordination”. Proc. of USENIX ATC. 2012, pp. 223–236.
- Jeffrey Dean and Sanjay Ghemawat. “MapReduce: a flexible data processing tool”. CACM 53.1 (Jan. 2010), pp. 72–77.
- John Douceur and Jon Howell. Scalable Byzantine-Fault-Quantifying Clock Synchronization. Tech. rep. MSR-TR-2003-67. MS Research, 2003.
- John R. Douceur and Jon Howell. “Distributed directory service in the Farsite file system”. Proc. of OSDI. 2006, pp. 321–334.
- Sanjay Ghemawat, Howard Gobioff, and Shun-Tak Leung. “The Google file system”. Proc. of SOSP. Dec. 2003, pp. 29–43. Read it here
- David K. Gifford. Information Storage in a Decentralized Computer System. Tech. rep. CSL-81-8. PhD dissertation. Xerox PARC, July 1982.
- Lisa Glendenning et al. “Scalable consistency in Scatter”. Proc. of SOSP. 2011.
- Jim Gray and Leslie Lamport. “Consensus on transaction commit”. ACM TODS 31.1 (Mar. 2006), pp. 133–160.
- Pat Helland. “Life beyond Distributed Transactions: an Apostate’s Opinion”. Proc. of CIDR. 2007, pp. 132–141.
- Maurice P. Herlihy and Jeannette M. Wing. “Linearizability: a correctness condition for concurrent objects”. ACM TOPLAS 12.3 (July 1990), pp. 463–492.
- Leslie Lamport. “The part-time parliament”. ACM TOCS 16.2 (May 1998), pp. 133–169. Read it here
- Leslie Lamport, Dahlia Malkhi, and Lidong Zhou. “Reconfiguring a state machine”. SIGACT News 41.1 (Mar. 2010), pp. 63–73.
- Barbara Liskov. “Practical uses of synchronized clocks in distributed systems”. Distrib. Comput. 6.4 (July 1993), pp. 211–219.
- David B. Lomet and Feifei Li. “Improving Transaction-Time DBMS Performance and Functionality”. Proc. of ICDE (2009), pp. 581–591.
- Jacob R. Lorch et al. “The SMART way to migrate replicated stateful services”. Proc. of EuroSys. 2006, pp. 103–115.
- MarkLogic. MarkLogic 5 Product Documentation. 2012.
- Keith Marzullo and Susan Owicci. “Maintaining the time in a distributed system”. Proc. of PODC. 1983, pp. 295–305.
- Sergey Melnik et al. “Dremel: Interactive Analysis of Web-Scale Datasets”. Proc. of VLDB. 2010, pp. 330–339.
- D.L. Mills. Time synchronization in DCNET hosts. Internet Project Report IEN–173. COMSAT Laboratories, Feb. 1981.
- Oracle. Oracle Total Recall. 2012.
- Andrew Pavlo et al. “A comparison of approaches to large-scale data analysis”. Proc. of SIGMOD. 2009, pp. 165–178.
- Daniel Peng and Frank Dabek. “Large-scale incremental processing using distributed transactions and notifications”. Proc. of OSDI. 2010, pp. 1–15.
- Daniel J. Rosenkrantz, Richard E. Stearns, and Philip M. Lewis II. “System level concurrency control for distributed database systems”. ACM TODS 3.2 (June 1978), pp. 178–198.
- Alexander Shraer et al. “Dynamic Reconfiguration of Primary/Backup Clusters”. Proc. of USENIX ATC. 2012, pp. 425–438.
- Jeff Shute et al. “F1 — The Fault-Tolerant Distributed RDBMS Supporting Google’s Ad Business”. Proc. of SIGMOD. May 2012, pp. 777–778.
- Yair Sovran et al. “Transactional storage for geo-replicated systems”. Proc. of SOSP. 2011, pp. 385–400.
- Michael Stonebraker. Why Enterprises Are Uninterested in NoSQL. 2010.
- Michael Stonebraker. Six SQL Urban Myths. 2010.
- Michael Stonebraker et al. “The end of an architectural era: (it’s time for a complete rewrite)”. Proc. of VLDB. 2007, pp. 1150–1160.
- Alexander Thomson et al. “Calvin: Fast Distributed Transactions for Partitioned Database Systems”. Proc. of SIGMOD. 2012, pp. 1–12.
- Ashish Thusoo et al. “Hive — A Petabyte Scale Data Warehouse Using Hadoop”. Proc. of ICDE. 2010, pp. 996–1005.
- VoltDB. VoltDB Resources. 2012. A Paxos Leader-Lease Management The simplest means to ensure the disjointness of Paxos-leader-lease intervals would be for a leader to issue a synchronous Paxos write of the lease interval, whenever it would be extended. A subsequent leader would read the interval and wait until that interval has passed. TrueTime can be used to ensure disjointness without these extra log writes. The potential ith leader keeps a lower bound on the start of a lease vote from replica r as $v_{i,r}^{leader} = TT.now().earliest$, computed before $e_{i,r}^{send}$ (defined as when the lease request is sent by the leader). Each replica r grants a lease at lease $e_{i,r}^{grant}$, which happens after $e_{i,r}^{receive}$ (when the replica receives a lease request); the lease ends at $t_{i,r}^{end} = TT.now().latest + 10$, computed after $e_{i,r}^{receive}$. A replica r obeys the single-vote rule: it will not grant another lease vote until $TT.after(t_{i,r}^{end})$ is true. To enforce this rule across different incarnations of r, Spanner logs a lease vote at the granting replica before granting the lease; this log write can be piggybacked upon existing Paxos-protocol log writes. When the ith leader receives a quorum of votes (event $e_i^{quorum}$), it computes its lease interval as $lease_i = [TT.now().latest, min_r(v_{i,r}^{leader}) + 10]$. The lease is deemed to have expired at the leader when $TT.before(min_r(v_{i,r}^{leader}) + 10)$ is false. To prove disjointness, we make use of the fact that the ith and $(i+1)$th leaders must have one replica in common in their quorums. Call that replica r0. Proof: $$ \begin{align*} lease_i.end &= min_r(v_{i,r}^{leader}) + 10 & \text{(by definition)} \\ min_r(v_{i,r}^{leader}) + 10 &\leq v_{i,r0}^{leader} + 10 & \text{(min)} \\ v_{i,r0}^{leader} + 10 &\leq t_{abs}(e_{i,r0}^{send}) + 10 & \text{(by definition)} \\ t_{abs}(e_{i,r0}^{send}) + 10 &\leq t_{abs}(e_{i,r0}^{receive}) + 10 & \text{(causality)} \\ t_{abs}(e_{i,r0}^{receive}) + 10 &\leq t_{i,r0}^{end} & \text{(by definition)} \\ t_{i,r0}^{end} &< t_{abs}(e_{i+1,r0}^{grant}) & \text{(single-vote)} \\ t_{abs}(e_{i+1,r0}^{grant}) &\leq t_{abs}(e_{i+1}^{quorum}) & \text{(causality)} \\ t_{abs}(e_{i+1}^{quorum}) &\leq lease_{i+1}.start & \text{(by definition)} \end{align*} $$
Read off the page by a vision model reading the page images using olmOCR-2-7B-1025-FP8.
Read off the page by a vision model reading the page images using olmOCR-2-7B-1025-FP8. Translated from the English.