Spanner: Cơ sở dữ liệu phân tán toàn cầu của Google
James C. Corbett, Jeffrey Dean, Michael Epstein, Andrew Fikes, Christopher Frost, JJ Furman, Sanjay Ghemawat, Andrey Gubarev, Christopher Heiser, Peter Hochschild, Wilson Hsieh, Sebastian Kanthak, Eugene Kogan, Hongyi Li, Alexander Lloyd, Sergey Melnik, David Mwaura, David Nagle, Sean Quinlan, Rajesh Rao, Lindsay Rolig, Yasushi Saito, Michal Szymaniak, Christopher Taylor, Ruth Wang, Dale Woodford
Google, Inc.
Tóm tắt
Spanner là cơ sở dữ liệu có khả năng mở rộng, đa phiên bản, phân tán toàn cầu và được sao chép đồng bộ của Google. Đây là hệ thống đầu tiên phân phối dữ liệu ở quy mô toàn cầu và hỗ trợ các giao dịch phân tán có tính nhất quán bên ngoài. Bài báo này mô tả cách Spanner được cấu trúc, tập tính năng của nó, cơ sở lý luận đằng sau các quyết định thiết kế khác nhau, và một API thời gian mới cung cấp khả năng hiển thị độ không chắc chắn của đồng hồ. API này cùng với việc triển khai của nó là yếu tố then chốt để hỗ trợ tính nhất quán bên ngoài và một loạt tính năng mạnh mẽ: đọc không chặn trong quá khứ, các giao dịch chỉ đọc không khóa, và các thay đổi lược đồ nguyên tử, trên toàn bộ Spanner.
1 Giới thiệu
Spanner là một cơ sở dữ liệu có khả năng mở rộng, phân tán toàn cầu, được thiết kế, xây dựng và triển khai tại Google. Ở mức trừu tượng cao nhất, nó là một cơ sở dữ liệu phân mảnh dữ liệu trên nhiều tập hợp máy trạng thái Paxos [21] tại các datacenter trải rộng khắp thế giới. Sao chép được sử dụng để cung cấp tính sẵn sàng toàn cầu và tính cục bộ theo địa lý; các máy khách tự động chuyển đổi dự phòng giữa các bản sao. Spanner tự động phân mảnh lại dữ liệu trên các máy khi lượng dữ liệu hoặc số lượng server thay đổi, và nó tự động di chuyển dữ liệu giữa các máy (kể cả giữa các datacenter) để cân bằng tải và phản ứng với các sự cố. Spanner được thiết kế để mở rộng tới hàng triệu máy trên hàng trăm datacenter và hàng nghìn tỷ hàng cơ sở dữ liệu.
Các ứng dụng có thể sử dụng Spanner để đạt tính sẵn sàng cao, ngay cả khi xảy ra các thảm họa tự nhiên trên diện rộng, bằng cách sao chép dữ liệu của chúng trong phạm vi hoặc thậm chí giữa các lục địa. Khách hàng ban đầu của chúng tôi là F1 [35], một bản viết lại của backend quảng cáo của Google. F1 sử dụng năm bản sao trải rộng trên Hoa Kỳ. Hầu hết các ứng dụng khác có lẽ sẽ sao chép dữ liệu của chúng trên 3 đến 5 datacenter trong một vùng địa lý, nhưng với các chế độ sự cố tương đối độc lập. Nghĩa là, hầu hết các ứng dụng sẽ chọn độ trễ thấp hơn thay vì tính sẵn sàng cao hơn, miễn là chúng có thể chịu được 1 hoặc 2 sự cố datacenter.
Trọng tâm chính của Spanner là quản lý dữ liệu được sao chép xuyên datacenter, nhưng chúng tôi cũng đã dành rất nhiều thời gian để thiết kế và triển khai các tính năng cơ sở dữ liệu quan trọng trên nền tảng hạ tầng hệ thống phân tán của mình. Mặc dù nhiều dự án sử dụng Bigtable [9] một cách hiệu quả, chúng tôi cũng liên tục nhận được các phàn nàn từ người dùng rằng Bigtable có thể khó sử dụng đối với một số loại ứng dụng: những ứng dụng có lược đồ phức tạp, thay đổi theo thời gian, hoặc những ứng dụng muốn có tính nhất quán mạnh trong sự hiện diện của sao chép trên diện rộng. (Các nhận định tương tự đã được các tác giả khác đưa ra [37].) Nhiều ứng dụng tại Google đã chọn sử dụng Megastore [5] vì mô hình dữ liệu bán quan hệ và hỗ trợ sao chép đồng bộ của nó, mặc dù thông lượng ghi tương đối kém. Do đó, Spanner đã phát triển từ một kho lưu trữ khóa-giá trị có phiên bản giống Bigtable thành một cơ sở dữ liệu đa phiên bản theo thời gian. Dữ liệu được lưu trữ trong các bảng bán quan hệ có lược đồ; dữ liệu được tạo phiên bản, và mỗi phiên bản được tự động gán dấu thời gian với thời điểm xác nhận của nó; các phiên bản dữ liệu cũ chịu sự điều chỉnh của các chính sách thu gom rác có thể cấu hình; và các ứng dụng có thể đọc dữ liệu tại các dấu thời gian cũ. Spanner hỗ trợ các giao dịch mục đích chung, và cung cấp một ngôn ngữ truy vấn dựa trên SQL.
Là một cơ sở dữ liệu phân tán toàn cầu, Spanner cung cấp một số tính năng thú vị. Thứ nhất, các cấu hình sao chép cho dữ liệu có thể được các ứng dụng điều khiển động với mức độ chi tiết cao. Các ứng dụng có thể chỉ định các ràng buộc để kiểm soát datacenter nào chứa dữ liệu nào, dữ liệu cách người dùng bao xa (để kiểm soát độ trễ đọc), các bản sao cách nhau bao xa (để kiểm soát độ trễ ghi), và có bao nhiêu bản sao được duy trì (để kiểm soát độ bền, tính sẵn sàng và hiệu năng đọc). Dữ liệu cũng có thể được hệ thống di chuyển động và minh bạch giữa các datacenter để cân bằng việc sử dụng tài nguyên trên các datacenter. Thứ hai, Spanner có hai tính năng khó triển khai trong một cơ sở dữ liệu phân tán: nó cung cấp các thao tác đọc và ghi nhất quán bên ngoài [16], và các thao tác đọc nhất quán toàn cục trên cơ sở dữ liệu tại một dấu thời gian. Các tính năng này cho phép Spanner hỗ trợ sao lưu nhất quán, các lần thực thi MapReduce nhất quán [12], và các cập nhật lược đồ nguyên tử, tất cả ở quy mô toàn cầu, ngay cả khi có các giao dịch đang diễn ra.
Các tính năng này được hỗ trợ bởi thực tế rằng Spanner gán các dấu thời gian xác nhận có ý nghĩa toàn cầu cho các giao dịch, mặc dù các giao dịch có thể được phân tán. Các dấu thời gian phản ánh thứ tự tuần tự hóa. Ngoài ra, thứ tự tuần tự hóa thỏa mãn tính nhất quán bên ngoài (hoặc tương đương, tính tuyến tính hóa [20]): nếu một giao dịch xác nhận trước khi một giao dịch khác bắt đầu, thì dấu thời gian xác nhận của nhỏ hơn của . Spanner là hệ thống đầu tiên cung cấp các đảm bảo như vậy ở quy mô toàn cầu.
Yếu tố then chốt cho các tính chất này là một API TrueTime mới và phần triển khai của nó. API này trực tiếp phơi bày sự không chắc chắn của đồng hồ, và các đảm bảo trên các dấu thời gian của Spanner phụ thuộc vào các cận mà phần triển khai cung cấp. Nếu độ không chắc chắn lớn, Spanner sẽ giảm tốc độ để chờ hết khoảng không chắc chắn đó. Phần mềm quản lý cụm của Google cung cấp một triển khai của API TrueTime. Triển khai này giữ cho độ không chắc chắn nhỏ (thường nhỏ hơn 10ms) bằng cách sử dụng nhiều tham chiếu đồng hồ hiện đại (GPS và đồng hồ nguyên tử).
Section 2 mô tả cấu trúc triển khai của Spanner, tập tính năng của nó, và các quyết định kỹ thuật đã đưa vào thiết kế của chúng. Section 3 mô tả API TrueTime mới của chúng tôi và phác thảo phần triển khai của nó. Section 4 mô tả cách Spanner sử dụng TrueTime để triển khai các giao dịch phân tán nhất quán bên ngoài, các giao dịch chỉ đọc không khóa, và các cập nhật lược đồ nguyên tử. Section 5 cung cấp một số phép đo chuẩn về hiệu năng của Spanner và hành vi của TrueTime, đồng thời thảo luận về các kinh nghiệm của F1. Sections 6, 7, and 8 mô tả công việc liên quan và trong tương lai, đồng thời tóm tắt các kết luận của chúng tôi.
2 Triển khai
Phần này mô tả cấu trúc và cơ sở lý giải cho cách triển khai Spanner. Tiếp đó, phần này mô tả trừu tượng hóa thư mục (directory), được dùng để quản lý sao chép và tính cục bộ của dữ liệu, đồng thời là đơn vị di chuyển dữ liệu. Cuối cùng, phần này mô tả mô hình dữ liệu của chúng tôi, lý do Spanner có dạng một cơ sở dữ liệu quan hệ thay vì một kho khóa-giá trị, và cách các ứng dụng có thể kiểm soát tính cục bộ của dữ liệu.
Một bản triển khai Spanner được gọi là một vũ trụ (universe). Do Spanner quản lý dữ liệu trên toàn cầu, sẽ chỉ có một số ít vũ trụ đang hoạt động. Hiện chúng tôi vận hành một vũ trụ dành cho kiểm thử/thử nghiệm, một vũ trụ dành cho phát triển/vận hành thực tế, và một vũ trụ chỉ dành cho vận hành thực tế.
Spanner được tổ chức thành một tập hợp các vùng, trong đó mỗi vùng gần tương đương với một bản triển khai các server Bigtable [9]. Vùng là đơn vị triển khai về mặt quản trị. Tập hợp các vùng cũng là tập hợp các vị trí mà dữ liệu có thể được sao chép giữa chúng. Có thể thêm vùng vào hoặc loại bỏ vùng khỏi một hệ thống đang hoạt động khi các trung tâm dữ liệu mới được đưa vào sử dụng hoặc các trung tâm dữ liệu cũ ngừng hoạt động. Vùng cũng là đơn vị cách ly vật lý: một trung tâm dữ liệu có thể có một hoặc nhiều vùng, chẳng hạn khi dữ liệu của các ứng dụng khác nhau phải được phân vùng trên các tập hợp server khác nhau trong cùng trung tâm dữ liệu.
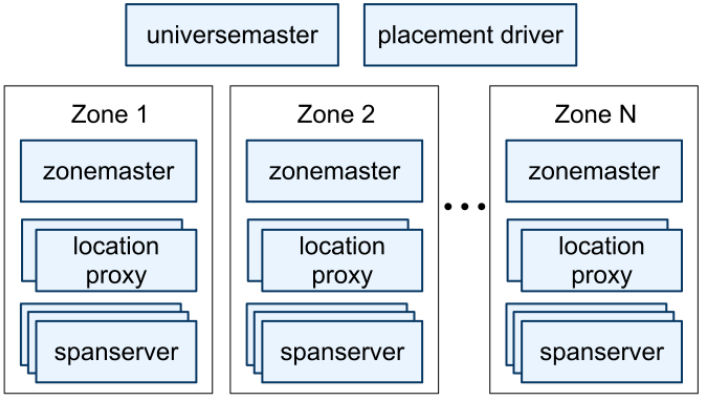
Hình 1 minh họa các server trong một vũ trụ Spanner. Một vùng có một zonemaster và từ một trăm đến vài nghìn spanserver. Zonemaster phân công dữ liệu cho các spanserver; các spanserver phục vụ dữ liệu cho máy khách. Máy khách sử dụng các proxy định vị của từng vùng để tìm các spanserver được phân công phục vụ dữ liệu của mình. Hiện tại, bộ chủ quản vũ trụ và bộ điều khiển bố trí đều chỉ có một thực thể duy nhất. Bộ chủ quản vũ trụ chủ yếu là một bảng điều khiển hiển thị thông tin trạng thái về tất cả các vùng để gỡ lỗi tương tác. Bộ điều khiển bố trí xử lý việc tự động di chuyển dữ liệu giữa các vùng trên thang thời gian tính bằng phút. Bộ điều khiển bố trí định kỳ trao đổi với các spanserver để tìm dữ liệu cần di chuyển, nhằm đáp ứng các ràng buộc sao chép đã cập nhật hoặc để cân bằng tải. Do giới hạn dung lượng bài viết, chúng tôi chỉ mô tả chi tiết spanserver.
Hình.
2.1 Ngăn xếp phần mềm Spanserver
Phần này tập trung vào cách triển khai spanserver để minh họa cách sao chép và giao dịch phân tán được xây dựng thành các lớp trên bản triển khai dựa trên Bigtable của chúng tôi. Ngăn xếp phần mềm được trình bày trong Hình 2. Ở lớp dưới cùng, mỗi spanserver chịu trách nhiệm quản lý từ 100 đến 1000 thực thể của một cấu trúc dữ liệu gọi là tablet. Tablet tương tự trừu tượng hóa tablet của Bigtable ở chỗ nó triển khai một đa tập các ánh xạ sau:
(key:string, timestamp:int64) → string
Khác với Bigtable, Spanner gán dấu thời gian cho dữ liệu; đây là một điểm quan trọng khiến Spanner giống cơ sở dữ liệu đa phiên bản hơn là kho khóa-giá trị. Trạng thái của một tablet được lưu trong một tập hợp các file có dạng cây B và một nhật ký ghi trước (write-ahead log), tất cả đều nằm trên một hệ thống file phân tán có tên Colossus (hệ thống kế nhiệm Google File System [15]).
Để hỗ trợ sao chép, mỗi spanserver triển khai một máy trạng thái Paxos duy nhất trên mỗi tablet. (Một phiên bản ban đầu của Spanner hỗ trợ nhiều máy trạng thái Paxos trên mỗi tablet, cho phép các cấu hình sao chép linh hoạt hơn. Độ phức tạp của thiết kế đó khiến chúng tôi từ bỏ nó.) Mỗi máy trạng thái lưu siêu dữ liệu và nhật ký trong tablet tương ứng. Bản triển khai Paxos của chúng tôi hỗ trợ các nút lãnh đạo tồn tại lâu dài với quyền lãnh đạo có thời hạn dựa trên thời gian, mặc định là 10 giây. Bản triển khai Spanner hiện tại ghi nhật ký mỗi thao tác ghi Paxos hai lần: một lần trong nhật ký của tablet và một lần trong nhật ký Paxos. Lựa chọn này nhằm thuận tiện cho việc triển khai, và nhiều khả năng chúng tôi sẽ khắc phục điều này về sau. Bản triển khai Paxos của chúng tôi sử dụng đường ống để cải thiện thông lượng của Spanner khi có độ trễ WAN; tuy nhiên, Paxos áp dụng các thao tác ghi theo thứ tự (một đặc điểm mà chúng tôi sẽ dựa vào trong Phần 4).
Các máy trạng thái Paxos được dùng để triển khai một đa tập các ánh xạ được sao chép với tính nhất quán. Trạng thái ánh xạ khóa-giá trị của mỗi bản sao được lưu trong tablet tương ứng. Các thao tác ghi phải khởi tạo giao thức Paxos tại nút lãnh đạo; các thao tác đọc truy cập trạng thái trực tiếp từ tablet bên dưới tại bất kỳ bản sao nào đã được cập nhật đủ mới. Tập hợp các bản sao được gọi chung là một nhóm Paxos.
Tại mỗi bản sao đóng vai trò lãnh đạo, mỗi spanserver triển khai một bảng khóa để thực hiện điều khiển đồng thời. Bảng khóa chứa trạng thái phục vụ khóa hai pha: nó ánh xạ các khoảng khóa tới các trạng thái khóa. (Lưu ý rằng việc có một nút lãnh đạo Paxos tồn tại lâu dài là thiết yếu để quản lý bảng khóa hiệu quả.) Trong cả Bigtable lẫn Spanner, chúng tôi thiết kế để hỗ trợ các giao dịch kéo dài (ví dụ, để tạo báo cáo, có thể mất khoảng vài phút), vốn có hiệu năng kém khi sử dụng điều khiển đồng thời lạc quan trong trường hợp có xung đột. Các thao tác cần đồng bộ hóa, chẳng hạn như đọc trong giao dịch, lấy khóa trong bảng khóa; các thao tác khác bỏ qua bảng khóa.
Tại mỗi bản sao đóng vai trò lãnh đạo, mỗi spanserver còn triển khai một bộ quản lý giao dịch để hỗ trợ giao dịch phân tán. Bộ quản lý giao dịch được dùng để triển khai một nút lãnh đạo tham gia; các bản sao khác trong nhóm sẽ được gọi là các nút phụ tham gia. Nếu một giao dịch chỉ liên quan đến một nhóm Paxos (như trường hợp của phần lớn giao dịch), nó có thể bỏ qua bộ quản lý giao dịch, vì bảng khóa kết hợp với Paxos cung cấp các tính chất giao dịch. Nếu một giao dịch liên quan đến nhiều nhóm Paxos, các nút lãnh đạo của những nhóm đó phối hợp để thực hiện xác nhận hai pha. Một trong các nhóm tham gia được chọn làm bộ điều phối: nút lãnh đạo tham gia của nhóm đó sẽ được gọi là nút lãnh đạo điều phối, và các nút phụ của nhóm đó là các nút phụ điều phối. Trạng thái của mỗi bộ quản lý giao dịch được lưu trong nhóm Paxos bên dưới (và do đó được sao chép).
2.2 Thư mục và bố trí
Trên tập hợp các ánh xạ khóa-giá trị, bản triển khai Spanner hỗ trợ một trừu tượng hóa gom nhóm gọi là thư mục (directory), tức một tập hợp các khóa liên tiếp có chung tiền tố. (Việc chọn thuật ngữ thư mục là một sự tình cờ trong lịch sử; thuật ngữ phù hợp hơn có thể là nhóm.) Chúng tôi sẽ giải thích nguồn gốc của tiền tố đó trong Mục 2.3. Việc hỗ trợ thư mục cho phép các ứng dụng kiểm soát tính cục bộ của dữ liệu bằng cách lựa chọn khóa cẩn thận.
Thư mục là đơn vị bố trí dữ liệu. Toàn bộ dữ liệu trong một thư mục có cùng cấu hình sao chép. Khi dữ liệu được di chuyển giữa các nhóm Paxos, dữ liệu được di chuyển theo từng thư mục, như minh họa trong Hình 3. Spanner có thể di chuyển một thư mục để giảm tải cho một nhóm Paxos; để đặt các thư mục thường được truy cập cùng nhau vào cùng một nhóm; hoặc để chuyển một thư mục vào nhóm gần các bên truy cập thư mục đó hơn. Các thư mục có thể được di chuyển trong khi các thao tác của máy khách vẫn đang diễn ra. Có thể kỳ vọng rằng một thư mục 50MB được di chuyển trong vài giây.
Việc một nhóm Paxos có thể chứa nhiều thư mục có nghĩa là tablet của Spanner khác với tablet của Bigtable: tablet của Spanner không nhất thiết là một phân vùng liên tiếp duy nhất theo thứ tự từ điển của không gian hàng. Thay vào đó, tablet của Spanner là một vùng chứa có thể bao gồm nhiều phân vùng của không gian hàng. Chúng tôi đưa ra quyết định này để có thể đặt nhiều thư mục thường được truy cập cùng nhau tại cùng một nơi.
Movedir là tác vụ nền được dùng để di chuyển các thư mục giữa các nhóm Paxos [14]. Movedir cũng được dùng để thêm bản sao vào hoặc loại bỏ bản sao khỏi các nhóm Paxos [25], vì Spanner chưa hỗ trợ thay đổi cấu hình ngay trong Paxos. Movedir không được triển khai dưới dạng một giao dịch duy nhất, nhằm tránh chặn các thao tác đọc và ghi đang diễn ra khi di chuyển một lượng lớn dữ liệu. Thay vào đó, movedir ghi nhận việc bắt đầu di chuyển dữ liệu và di chuyển dữ liệu trong nền. Khi đã di chuyển gần hết dữ liệu, chỉ còn lại một lượng nhỏ, nó sử dụng một giao dịch để di chuyển lượng nhỏ đó và cập nhật siêu dữ liệu cho hai nhóm Paxos một cách nguyên tử.
Thư mục cũng là đơn vị nhỏ nhất mà ứng dụng có thể đặc tả các thuộc tính sao chép theo địa lý (hay gọi ngắn gọn là bố trí). Thiết kế ngôn ngữ đặc tả bố trí của chúng tôi phân tách các trách nhiệm quản lý cấu hình sao chép. Quản trị viên kiểm soát hai chiều: số lượng và kiểu bản sao, cùng với vị trí địa lý của các bản sao đó. Họ tạo một danh mục các tùy chọn có tên theo hai chiều này (ví dụ: Bắc Mỹ, sao chép thành 5 bản với 1 bản sao làm chứng). Ứng dụng kiểm soát cách sao chép dữ liệu bằng cách gắn thẻ cho từng cơ sở dữ liệu và/hoặc từng thư mục bằng một tổ hợp các tùy chọn đó. Ví dụ, một ứng dụng có thể lưu dữ liệu của mỗi người dùng cuối trong một thư mục riêng, nhờ đó dữ liệu của người dùng có thể có ba bản sao ở châu Âu, còn dữ liệu của người dùng có thể có năm bản sao ở Bắc Mỹ.
Để trình bày rõ ràng, chúng tôi đã đơn giản hóa quá mức. Trên thực tế, Spanner sẽ phân mảnh một thư mục thành nhiều mảnh nếu thư mục đó trở nên quá lớn. Các mảnh có thể được phục vụ từ những nhóm Paxos khác nhau (và do đó từ những server khác nhau). Movedir thực ra di chuyển các mảnh giữa các nhóm, chứ không phải toàn bộ thư mục.
2.3 Mô hình dữ liệu
Spanner cung cấp cho các ứng dụng tập hợp tính năng dữ liệu sau: một mô hình dữ liệu dựa trên các bảng bán quan hệ có lược đồ, một ngôn ngữ truy vấn và các giao dịch đa dụng. Việc chuyển sang hỗ trợ các tính năng này được thúc đẩy bởi nhiều yếu tố. Sự phổ biến của Megastore [5] cho thấy nhu cầu hỗ trợ các bảng bán quan hệ có lược đồ và sao chép đồng bộ. Ít nhất 300 ứng dụng trong Google sử dụng Megastore (mặc dù hiệu năng của nó tương đối thấp) vì mô hình dữ liệu của nó dễ quản lý hơn mô hình của Bigtable, và vì nó hỗ trợ sao chép đồng bộ giữa các trung tâm dữ liệu. (Bigtable chỉ hỗ trợ sao chép với tính nhất quán cuối cùng giữa các trung tâm dữ liệu.) Các ứng dụng nổi tiếng của Google sử dụng Megastore bao gồm Gmail, Picasa, Calendar, Android Market và AppEngine. Nhu cầu hỗ trợ một ngôn ngữ truy vấn tương tự SQL trong Spanner cũng rất rõ ràng, xét đến sự phổ biến của Dremel [28] với vai trò công cụ phân tích dữ liệu tương tác. Cuối cùng, việc thiếu các giao dịch xuyên hàng trong Bigtable dẫn đến những phàn nàn thường xuyên; Percolator [32] được xây dựng một phần để khắc phục thiếu sót này. Một số tác giả cho rằng chi phí hỗ trợ xác nhận hai pha (two-phase commit) trong trường hợp tổng quát là quá cao, do những vấn đề về hiệu năng hoặc tính sẵn sàng mà nó gây ra [9, 10, 19]. Chúng tôi cho rằng tốt hơn là để các lập trình viên ứng dụng xử lý những vấn đề hiệu năng do lạm dụng giao dịch khi các nút thắt xuất hiện, thay vì luôn phải viết mã để khắc phục việc thiếu giao dịch. Thực thi xác nhận hai pha trên Paxos làm giảm các vấn đề về tính sẵn sàng.
Mô hình dữ liệu ứng dụng được xây dựng thành một lớp bên trên các ánh xạ khóa-giá trị được gom nhóm theo thư mục mà bản triển khai hỗ trợ. Một ứng dụng tạo một hoặc nhiều cơ sở dữ liệu trong một vũ trụ. Mỗi cơ sở dữ liệu có thể chứa số lượng không giới hạn các bảng có lược đồ. Các bảng trông giống bảng trong cơ sở dữ liệu quan hệ, với các hàng, cột và giá trị có phiên bản. Chúng tôi sẽ không đi sâu vào ngôn ngữ truy vấn của Spanner. Nó giống SQL với một số phần mở rộng để hỗ trợ các trường có giá trị kiểu protocol buffer.
Mô hình dữ liệu của Spanner không thuần quan hệ, ở chỗ các hàng phải có tên. Chính xác hơn, mỗi bảng bắt buộc phải có một tập hợp có thứ tự gồm một hoặc nhiều cột khóa chính. Yêu cầu này là điểm mà Spanner vẫn giống một kho khóa-giá trị: các khóa chính tạo thành tên của một hàng, và mỗi bảng định nghĩa một ánh xạ từ các cột khóa chính sang các cột không thuộc khóa chính. Một hàng chỉ tồn tại nếu có một giá trị nào đó (kể cả NULL) được định nghĩa cho các khóa của hàng đó. Việc áp đặt cấu trúc này là hữu ích vì nó cho phép các ứng dụng kiểm soát tính cục bộ của dữ liệu thông qua việc lựa chọn khóa.
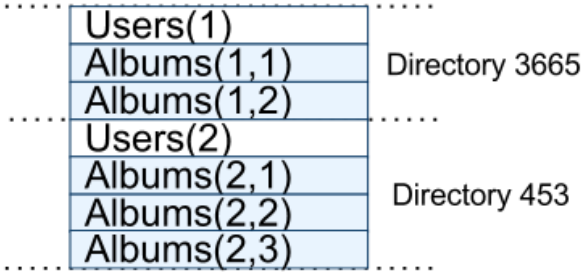
Hình 4 trình bày một ví dụ về lược đồ Spanner để lưu trữ siêu dữ liệu ảnh theo từng người dùng, từng album. Ngôn ngữ lược đồ tương tự ngôn ngữ của Megastore, với yêu cầu bổ sung rằng mỗi cơ sở dữ liệu Spanner phải được các máy khách phân vùng thành một hoặc nhiều hệ phân cấp bảng. Các ứng dụng máy khách khai báo các hệ phân cấp trong lược đồ cơ sở dữ liệu thông qua các khai báo INTERLEAVE IN. Bảng ở đỉnh của một hệ phân cấp là bảng thư mục (directory table). Mỗi hàng trong một bảng thư mục có khóa , cùng với tất cả các hàng trong các bảng hậu duệ bắt đầu bằng theo thứ tự từ điển, tạo thành một thư mục. ON DELETE CASCADE quy định rằng việc xóa một hàng trong bảng thư mục sẽ xóa mọi hàng con liên quan. Hình này cũng minh họa cách bố trí xen kẽ (interleaving) cho cơ sở dữ liệu ví dụ: chẳng
              CREATE TABLE Users {
    uid INT64 NOT NULL, email STRING
} PRIMARY KEY (uid), DIRECTORY;

CREATE TABLE Albums {
    uid INT64 NOT NULL, aid INT64 NOT NULL,
    name STRING
} PRIMARY KEY (uid, aid),
INTERLEAVE IN PARENT Users ON DELETE CASCADE;
| Users(1) | Albums(1,1) | Albums(1,2) | Users(2) | Albums(2,1) | Albums(2,2) | Albums(2,3) |
|---|
Thư mục 3665
Thư mục 453 hạn, Albums biểu diễn hàng trong bảng Albums ứng với user_id 2, album_id 1. Việc xen kẽ các bảng để tạo thành các thư mục có ý nghĩa quan trọng vì nó cho phép các máy khách mô tả các mối quan hệ về tính cục bộ (locality) tồn tại giữa nhiều bảng, điều cần thiết để đạt hiệu năng tốt trong một cơ sở dữ liệu phân tán có phân mảnh. Nếu không có cách bố trí này, Spanner sẽ không biết được các mối quan hệ quan trọng nhất về tính cục bộ.
3 TrueTime
| Phương thức | Trả về |
|---|---|
| TT.now() | TTinterval: [earliest, latest] |
| TT.after(t) | true nếu chắc chắn đã trôi qua |
| TT.before(t) | true nếu chắc chắn chưa đến |
Bảng 1: API TrueTime. Đối số có kiểu .
Phần này mô tả API TrueTime và phác thảo việc triển khai của nó. Chúng tôi để lại hầu hết các chi tiết cho một bài báo khác: mục tiêu của chúng tôi là minh họa sức mạnh của việc có một API như vậy. Bảng 1 liệt kê các phương thức của API. TrueTime biểu diễn thời gian một cách tường minh dưới dạng , là một khoảng với độ bất định thời gian bị chặn (khác với các giao diện thời gian tiêu chuẩn không cung cấp cho máy khách khái niệm nào về sự bất định). Các điểm đầu mút của một có kiểu . Phương thức trả về một được đảm bảo chứa thời gian tuyệt đối trong khoảng thời gian mà được gọi. Kỷ nguyên thời gian tương tự như thời gian UNIX với việc làm mờ giây nhuận. Định nghĩa cận lỗi tức thời là , bằng một nửa độ rộng của khoảng, và cận lỗi trung bình là . Các phương thức và là các lớp bao tiện ích xung quanh .
Ký hiệu thời gian tuyệt đối của một sự kiện bằng hàm . Theo cách hình thức hơn, TrueTime đảm bảo rằng với một lần gọi , trong đó là sự kiện gọi.
Các tham chiếu thời gian nền tảng được TrueTime sử dụng là GPS và đồng hồ nguyên tử. TrueTime sử dụng hai dạng tham chiếu thời gian vì chúng có các chế độ sự cố khác nhau. Các lỗ hổng của nguồn tham chiếu GPS bao gồm sự cố ăng-ten và bộ thu, nhiễu vô tuyến cục bộ, các sự cố tương quan (ví dụ, các lỗi thiết kế như xử lý giây nhuận không đúng và giả mạo), và các sự cố ngừng hoạt động của hệ thống GPS. Đồng hồ nguyên tử có thể gặp sự cố theo các cách không tương quan với GPS và với nhau, và trong các khoảng thời gian dài có thể bị trôi đáng kể do lỗi tần số.
TrueTime được triển khai bởi một tập hợp các máy time master trên mỗi trung tâm dữ liệu và một timeslave daemon trên mỗi máy. Phần lớn các master có bộ thu GPS với ăng-ten chuyên dụng; các master này được tách biệt về mặt vật lý để giảm ảnh hưởng của sự cố ăng-ten, nhiễu vô tuyến và giả mạo. Các master còn lại (mà chúng tôi gọi là Armageddon masters) được trang bị đồng hồ nguyên tử. Một đồng hồ nguyên tử không quá đắt: chi phí của một Armageddon master cùng bậc với chi phí của một GPS master. Các tham chiếu thời gian của tất cả master thường xuyên được so sánh với nhau. Mỗi master cũng kiểm tra chéo tốc độ mà tham chiếu của nó tiến triển thời gian so với đồng hồ cục bộ của chính nó, và tự loại bỏ nếu có sai khác đáng kể. Giữa các lần đồng bộ hóa, các Armageddon master công bố độ bất định thời gian tăng chậm được suy ra từ độ trôi đồng hồ trong trường hợp xấu nhất được áp dụng một cách thận trọng. Các GPS master công bố độ bất định thường gần bằng không.
Mỗi daemon thăm dò nhiều master khác nhau [29] để giảm khả năng bị tổn thương trước lỗi từ bất kỳ master đơn lẻ nào. Một số là các GPS master được chọn từ các trung tâm dữ liệu lân cận; phần còn lại là các GPS master từ các trung tâm dữ liệu xa hơn, cũng như một số Armageddon master. Các daemon áp dụng một biến thể của thuật toán Marzullo [27] để phát hiện và loại bỏ các bên nói dối, đồng thời đồng bộ hóa đồng hồ máy cục bộ với các bên không nói dối. Để bảo vệ trước các đồng hồ cục bộ bị hỏng, các máy thể hiện sai lệch tần số lớn hơn cận trường hợp xấu nhất được suy ra từ đặc tả thành phần và môi trường vận hành sẽ bị loại bỏ.
Giữa các lần đồng bộ hóa, một daemon công bố độ bất định thời gian tăng chậm. được suy ra từ độ trôi đồng hồ cục bộ trong trường hợp xấu nhất được áp dụng một cách thận trọng. cũng phụ thuộc vào độ bất định của time-master và độ trễ giao tiếp tới các time master. Trong môi trường sản xuất của chúng tôi, thường là một hàm răng cưa theo thời gian, thay đổi từ khoảng 1 đến 7 ms trong mỗi khoảng thăm dò. Do đó là 4 ms trong phần lớn thời gian. Khoảng thăm dò của daemon hiện là 30 giây, và tốc độ trôi được áp dụng hiện tại được đặt ở mức 200 microseconds/second, cùng nhau chiếm
| Thao tác | Thảo luận về dấu thời gian | Điều khiển đồng thời | Bản sao bắt buộc |
|---|---|---|---|
| Read-Write Transaction | § 4.1.2 | bi quan | leader |
| Read-Only Transaction | § 4.1.4 | không khóa | leader cho dấu thời gian; bất kỳ cho đọc, tuân theo § 4.1.3 |
| Snapshot Read, client-provided timestamp | — | không khóa | bất kỳ, tuân theo § 4.1.3 |
| Snapshot Read, client-provided bound | § 4.1.3 | không khóa | bất kỳ, tuân theo § 4.1.3 |
Bảng 2: Các kiểu đọc và ghi trong Spanner, và cách chúng được so sánh.
cho các cận răng cưa từ 0 đến 6 ms. 1 ms còn lại đến từ độ trễ giao tiếp tới các time master. Các sai lệch khỏi dạng răng cưa này có thể xảy ra khi có sự cố. Ví dụ, tình trạng không khả dụng thỉnh thoảng của time-master có thể gây ra sự gia tăng trên toàn trung tâm dữ liệu. Tương tự, các máy và liên kết mạng bị quá tải có thể dẫn đến các đỉnh cục bộ xảy ra không thường xuyên.
4 Kiểm soát đồng thời
Phần này mô tả cách TrueTime được sử dụng để đảm bảo các thuộc tính đúng đắn xung quanh kiểm soát đồng thời, và cách các thuộc tính đó được sử dụng để triển khai các tính năng như giao dịch nhất quán bên ngoài, giao dịch chỉ đọc không khóa, và đọc không chặn trong quá khứ. Các tính năng này cho phép, ví dụ, đảm bảo rằng một thao tác đọc kiểm tra toàn bộ cơ sở dữ liệu tại dấu thời gian sẽ thấy chính xác ảnh hưởng của mọi giao dịch đã xác nhận tính đến .
Trong phần tiếp theo, sẽ rất quan trọng khi phân biệt các ghi nhận được Paxos quan sát (mà chúng tôi sẽ gọi là các ghi Paxos trừ khi ngữ cảnh đã rõ) với các ghi của máy khách Spanner. Ví dụ, xác nhận hai pha tạo ra một ghi Paxos cho giai đoạn chuẩn bị mà không có ghi máy khách Spanner tương ứng.
4.1 Quản lý dấu thời gian
Bảng 2 liệt kê các kiểu thao tác mà Spanner hỗ trợ. Cài đặt Spanner hỗ trợ giao dịch đọc-ghi, giao dịch chỉ đọc (các giao dịch cô lập ảnh chụp được khai báo trước), và đọc ảnh chụp. Các ghi độc lập được triển khai dưới dạng giao dịch đọc-ghi; các đọc độc lập không phải ảnh chụp được triển khai dưới dạng giao dịch chỉ đọc. Cả hai đều được thử lại nội bộ (máy khách không cần tự viết các vòng lặp thử lại).
Một giao dịch chỉ đọc là một kiểu giao dịch có các lợi ích về hiệu năng của cô lập ảnh chụp [6]. Một giao dịch chỉ đọc phải được khai báo trước là không có bất kỳ ghi nào; nó không đơn giản chỉ là một giao dịch đọc-ghi không có ghi nào. Các đọc trong một giao dịch chỉ đọc được thực thi tại một dấu thời gian do hệ thống chọn mà không khóa, để các ghi đến không bị chặn. Việc thực thi các đọc trong một giao dịch chỉ đọc có thể tiến hành trên bất kỳ bản sao nào đủ cập nhật (Mục 4.1.3).
Một đọc ảnh chụp là một đọc trong quá khứ được thực thi mà không khóa. Một máy khách có thể chỉ định một dấu thời gian cho một đọc ảnh chụp, hoặc cung cấp một cận trên về độ cũ mong muốn của dấu thời gian và để Spanner chọn một dấu thời gian. Trong cả hai trường hợp, việc thực thi một đọc ảnh chụp tiến hành trên bất kỳ bản sao nào đủ cập nhật.
Đối với cả giao dịch chỉ đọc và đọc ảnh chụp, xác nhận là tất yếu một khi một dấu thời gian đã được chọn, trừ khi dữ liệu tại dấu thời gian đó đã được thu gom rác. Kết quả là, máy khách có thể tránh đệm các kết quả bên trong một vòng lặp thử lại. Khi một server gặp sự cố, máy khách có thể tiếp tục truy vấn nội bộ trên một server khác bằng cách lặp lại dấu thời gian và vị trí đọc hiện tại.
4.1.1 Các hợp đồng thuê lãnh đạo Paxos
Cài đặt Paxos của Spanner sử dụng các hợp đồng thuê có định thời để làm cho vai trò lãnh đạo tồn tại lâu dài (mặc định 10 giây). Một lãnh đạo tiềm năng gửi các yêu cầu cho các phiếu thuê có định thời; khi nhận được một số đại diện phiếu thuê, lãnh đạo biết rằng nó có một hợp đồng thuê. Một bản sao mở rộng phiếu thuê của nó một cách ngầm định khi có một ghi thành công, và lãnh đạo yêu cầu các mở rộng phiếu thuê nếu chúng gần hết hạn. Định nghĩa khoảng thuê của một lãnh đạo là bắt đầu khi nó phát hiện có một số đại diện phiếu thuê, và kết thúc khi nó không còn có một số đại diện phiếu thuê (vì một số đã hết hạn). Spanner phụ thuộc vào bất biến rời rạc sau: đối với mỗi nhóm Paxos, khoảng thuê của mỗi lãnh đạo Paxos là rời rạc với mọi khoảng thuê của các lãnh đạo khác. Phụ lục A mô tả cách bất biến này được đảm bảo.
Cài đặt Spanner cho phép một lãnh đạo Paxos thoái vị bằng cách giải phóng các bản sao phụ của nó khỏi các phiếu thuê. Để duy trì bất biến rời rạc, Spanner giới hạn thời điểm việc thoái vị được phép. Định nghĩa là dấu thời gian lớn nhất được sử dụng bởi một lãnh đạo. Các phần tiếp theo sẽ mô tả khi nào được tăng lên. Trước khi thoái vị, một lãnh đạo phải đợi cho đến khi TT.after() is true.
4.1.2 Gán dấu thời gian cho các giao dịch RW
Các đọc và ghi giao dịch sử dụng khóa hai pha. Do đó, chúng có thể được gán dấu thời gian tại bất kỳ thời điểm nào khi tất cả các khóa đã được thu nhận, nhưng trước khi bất kỳ khóa nào được giải phóng. Với một giao dịch cụ thể, Spanner gán cho nó dấu thời gian mà Paxos gán cho ghi Paxos biểu diễn việc xác nhận giao dịch.
Spanner phụ thuộc vào bất biến đơn điệu sau: trong mỗi nhóm Paxos, Spanner gán dấu thời gian cho các ghi Paxos theo thứ tự tăng đơn điệu, ngay cả giữa các lãnh đạo. Một bản sao lãnh đạo đơn lẻ có thể dễ dàng gán dấu thời gian theo thứ tự tăng đơn điệu. Bất biến này được đảm bảo giữa các lãnh đạo bằng cách sử dụng bất biến rời rạc: một lãnh đạo chỉ được gán dấu thời gian trong khoảng của hợp đồng thuê lãnh đạo của nó. Lưu ý rằng bất cứ khi nào một dấu thời gian được gán, được tăng lên thành để duy trì tính rời rạc.
Spanner cũng thực thi bất biến nhất quán bên ngoài sau: nếu thời điểm bắt đầu của một giao dịch xảy ra sau thời điểm xác nhận của một giao dịch , thì dấu thời gian xác nhận của phải lớn hơn dấu thời gian xác nhận của . Định nghĩa các sự kiện bắt đầu và xác nhận cho một giao dịch lần lượt bởi và ; và dấu thời gian xác nhận của một giao dịch bởi . Bất biến trở thành . Giao thức để thực thi các giao dịch và gán dấu thời gian tuân theo hai quy tắc, cùng nhau đảm bảo bất biến này, như được trình bày bên dưới. Định nghĩa sự kiện đến của yêu cầu xác nhận tại lãnh đạo điều phối cho một ghi là .
Bắt đầu Lãnh đạo điều phối cho một ghi gán một dấu thời gian xác nhận không nhỏ hơn giá trị của , được tính sau . Lưu ý rằng các lãnh đạo tham gia không quan trọng ở đây; Mục 4.2.1 mô tả cách chúng tham gia vào việc triển khai quy tắc tiếp theo.
Chờ xác nhận Điều phối viên leader đảm bảo rằng các máy khách không thể thấy bất kỳ dữ liệu nào được xác nhận bởi cho đến khi là đúng. Chờ xác nhận đảm bảo rằng nhỏ hơn thời điểm xác nhận tuyệt đối của , hoặc . Việc triển khai chờ xác nhận được mô tả trong Section 4.2.1. Chứng minh:
4.1.3 Phục vụ các lần đọc tại một dấu thời gian
Bất biến đơn điệu được mô tả trong Section 4.1.2 cho phép Spanner xác định chính xác liệu trạng thái của một bản sao có đủ được cập nhật để đáp ứng một lần đọc hay không. Mỗi bản sao theo dõi một giá trị được gọi là safe time , là dấu thời gian lớn nhất tại đó một bản sao được cập nhật đầy đủ. Một bản sao có thể đáp ứng một lần đọc tại dấu thời gian nếu .
Định nghĩa , trong đó mỗi máy trạng thái Paxos có một thời gian an toàn và mỗi trình quản lý giao dịch có một thời gian an toàn . đơn giản hơn: nó là dấu thời gian của lần ghi Paxos được áp dụng cao nhất. Vì các dấu thời gian tăng đơn điệu và các lần ghi được áp dụng theo thứ tự, các lần ghi sẽ không còn xảy ra tại hoặc thấp hơn theo Paxos.
là tại một bản sao nếu có không có giao dịch nào đã chuẩn bị (nhưng chưa được xác nhận), tức là các giao dịch nằm giữa hai pha của xác nhận hai pha. (Đối với một slave tham gia, thực sự đề cập đến trình quản lý giao dịch của leader của bản sao, mà trạng thái của slave có thể suy ra thông qua metadata được truyền trong các lần ghi Paxos.) Nếu có bất kỳ giao dịch nào như vậy, thì trạng thái bị ảnh hưởng bởi các giao dịch đó là không xác định: một bản sao tham gia chưa biết liệu các giao dịch như vậy có được xác nhận hay không. Như chúng tôi thảo luận trong Section 4.2.1, giao thức xác nhận đảm bảo rằng mọi bên tham gia biết một cận dưới về dấu thời gian của một giao dịch đã chuẩn bị. Mọi leader tham gia (đối với một nhóm ) cho một giao dịch gán một dấu thời gian chuẩn bị cho bản ghi chuẩn bị của nó. Leader điều phối đảm bảo rằng dấu thời gian xác nhận của giao dịch trên tất cả các nhóm tham gia . Do đó, đối với mọi bản sao trong một nhóm , trên tất cả các giao dịch được chuẩn bị tại , trên tất cả các giao dịch được chuẩn bị tại .
4.1.4 Gán dấu thời gian cho các giao dịch RO
Một giao dịch chỉ đọc thực thi trong hai pha: gán một dấu thời gian [8], rồi thực thi các lần đọc của giao dịch dưới dạng các lần đọc snapshot tại . Các lần đọc snapshot có thể thực thi tại bất kỳ bản sao nào được cập nhật đầy đủ.
Việc gán đơn giản , tại bất kỳ thời điểm nào sau khi một giao dịch bắt đầu, duy trì tính nhất quán bên ngoài bằng một lập luận tương tự như lập luận được trình bày cho các lần ghi trong Section 4.1.2. Tuy nhiên, một dấu thời gian như vậy có thể yêu cầu việc thực thi các lần đọc dữ liệu tại phải chặn nếu chưa tiến triển đủ. (Ngoài ra, lưu ý rằng việc chọn một giá trị của cũng có thể làm tăng để duy trì tính rời rạc.) Để giảm khả năng bị chặn, Spanner nên gán dấu thời gian cũ nhất vẫn duy trì tính nhất quán bên ngoài. Section 4.2.2 giải thích cách có thể chọn một dấu thời gian như vậy.
4.2 Chi tiết
Phần này giải thích một số chi tiết thực tế của các giao dịch đọc-ghi và các giao dịch chỉ đọc đã được lược bỏ trước đó, cũng như việc triển khai một kiểu giao dịch đặc biệt được sử dụng để thực hiện các thay đổi lược đồ nguyên tử.
Sau đó mô tả một số tinh chỉnh của các lược đồ cơ bản như đã trình bày.
4.2.1 Các giao dịch đọc-ghi
Giống như Bigtable, các lần ghi xảy ra trong một giao dịch được lưu vào bộ đệm tại máy khách cho đến khi xác nhận. Do đó, các lần đọc trong một giao dịch không thấy tác động của các lần ghi của giao dịch. Thiết kế này hoạt động tốt trong Spanner vì một lần đọc trả về các dấu thời gian của mọi dữ liệu được đọc, và các lần ghi chưa được xác nhận vẫn chưa được gán dấu thời gian.
Các lần đọc trong các giao dịch đọc-ghi sử dụng wound-wait [33] để tránh bế tắc. Máy khách gửi các lần đọc đến bản sao leader của nhóm thích hợp, bản sao này thu nhận các khóa đọc rồi đọc dữ liệu mới nhất. Trong khi một giao dịch của máy khách vẫn mở, nó gửi các thông điệp keepalive để ngăn các leader tham gia hết thời gian chờ giao dịch của nó. Khi một máy khách đã hoàn thành tất cả các lần đọc và lưu vào bộ đệm tất cả các lần ghi, nó bắt đầu xác nhận hai pha. Máy khách chọn một nhóm điều phối và gửi một thông điệp xác nhận đến leader của mỗi bên tham gia cùng với danh tính của điều phối viên và mọi lần ghi đã được lưu vào bộ đệm. Việc để máy khách điều khiển xác nhận hai pha tránh gửi dữ liệu hai lần qua các liên kết diện rộng.
Một leader không phải điều phối viên-tham gia trước tiên thu nhận các khóa ghi. Sau đó nó chọn một dấu thời gian chuẩn bị phải lớn hơn mọi dấu thời gian mà nó đã gán cho các giao dịch trước đó (để duy trì tính đơn điệu), và ghi một bản ghi chuẩn bị thông qua Paxos. Mỗi bên tham gia sau đó thông báo cho điều phối viên về dấu thời gian chuẩn bị của nó.
Trưởng nhóm điều phối cũng trước tiên thu được các khóa ghi, nhưng bỏ qua pha chuẩn bị. Nó chọn một dấu thời gian cho toàn bộ giao dịch sau khi nhận thông tin từ tất cả các trưởng nhóm tham gia khác. Dấu thời gian xác nhận s phải lớn hơn hoặc bằng tất cả các dấu thời gian chuẩn bị (để thỏa mãn các ràng buộc được thảo luận trong Section 4.1.3), lớn hơn TT.now().latest tại thời điểm trưởng nhóm điều phối nhận được thông điệp xác nhận của nó, và lớn hơn bất kỳ dấu thời gian nào mà trưởng nhóm đã gán cho các giao dịch trước đó (một lần nữa, để duy trì tính đơn điệu). Sau đó trưởng nhóm điều phối ghi một bản ghi xác nhận thông qua Paxos (hoặc hủy bỏ nếu nó hết thời gian chờ trong khi đợi các bên tham gia khác).
Trước khi cho phép bất kỳ bản sao điều phối nào áp dụng bản ghi xác nhận, trưởng nhóm điều phối đợi cho đến TT.after(s), để tuân theo quy tắc chờ xác nhận được mô tả trong Section 4.1.2. Vì trưởng nhóm điều phối đã chọn s dựa trên TT.now().latest, và bây giờ đợi cho đến khi dấu thời gian đó được đảm bảo đã nằm trong quá khứ, thời gian chờ kỳ vọng ít nhất là . Thời gian chờ này thường được chồng lấp với việc giao tiếp Paxos. Sau thời gian chờ xác nhận, trưởng nhóm điều phối gửi dấu thời gian xác nhận đến máy khách và tất cả các trưởng nhóm tham gia khác. Mỗi trưởng nhóm tham gia ghi kết quả của giao dịch thông qua Paxos. Tất cả các bên tham gia áp dụng cùng một dấu thời gian và sau đó giải phóng các khóa.
4.2.2 Giao dịch chỉ đọc
Việc gán một dấu thời gian yêu cầu một pha thương lượng giữa tất cả các nhóm Paxos có liên quan đến các thao tác đọc. Do đó, Spanner yêu cầu một biểu thức phạm vi cho mọi giao dịch chỉ đọc, là một biểu thức tóm tắt các khóa sẽ được đọc bởi toàn bộ giao dịch. Spanner tự động suy ra phạm vi cho các truy vấn độc lập.
Nếu các giá trị của phạm vi được phục vụ bởi một nhóm Paxos duy nhất, thì máy khách gửi giao dịch chỉ đọc đến trưởng nhóm của nhóm đó. (Triển khai Spanner hiện tại chỉ chọn một dấu thời gian cho giao dịch chỉ đọc tại một trưởng nhóm Paxos.) Trưởng nhóm đó gán và thực thi thao tác đọc. Đối với một thao tác đọc tại một site duy nhất, Spanner nhìn chung hoạt động tốt hơn TT.now().latest. Định nghĩa LastTS() là dấu thời gian của lần ghi đã xác nhận cuối cùng tại một nhóm Paxos. Nếu không có các giao dịch đã chuẩn bị, phép gán hiển nhiên thỏa mãn tính nhất quán bên ngoài: giao dịch sẽ thấy kết quả của lần ghi cuối cùng, và do đó được sắp xếp sau nó.
Nếu các giá trị của phạm vi được phục vụ bởi nhiều nhóm Paxos, có một số lựa chọn. Lựa chọn phức tạp nhất là thực hiện một vòng giao tiếp với tất cả các trưởng nhóm của các nhóm đó để thương lượng dựa trên LastTS(). Spanner hiện thực hiện một lựa chọn đơn giản hơn. Máy khách tránh một vòng thương lượng, và chỉ cho các thao tác đọc của nó thực thi tại (điều này có thể phải chờ thời gian an toàn tiến triển). Tất cả các thao tác đọc trong giao dịch có thể được gửi đến các bản sao đủ cập nhật.
4.2.3 Giao dịch thay đổi lược đồ
TrueTime cho phép Spanner hỗ trợ các thay đổi lược đồ nguyên tử. Việc sử dụng một giao dịch tiêu chuẩn sẽ không khả thi, bởi vì số lượng bên tham gia (số lượng nhóm trong một cơ sở dữ liệu) có thể lên đến hàng triệu. Bigtable hỗ trợ các thay đổi lược đồ nguyên tử trong một datacenter, nhưng các thay đổi lược đồ của nó chặn mọi thao tác.
Một giao dịch thay đổi lược đồ của Spanner là một biến thể nhìn chung không chặn của một giao dịch tiêu chuẩn. Thứ nhất, nó được gán rõ ràng một dấu thời gian trong tương lai, dấu này được đăng ký trong pha chuẩn bị. Do đó, các thay đổi lược đồ trên hàng nghìn server có thể hoàn tất với sự gián đoạn tối thiểu đối với các hoạt động đồng thời khác. Thứ hai, các thao tác đọc và ghi, vốn phụ thuộc ngầm vào lược đồ, đồng bộ với bất kỳ dấu thời gian thay đổi lược đồ nào đã đăng ký tại thời điểm t: chúng có thể tiếp tục nếu các dấu thời gian của chúng đứng trước t, nhưng chúng phải chặn phía sau giao dịch thay đổi lược đồ nếu các dấu thời gian của chúng đứng sau t. Nếu không có TrueTime, việc định nghĩa thay đổi lược đồ xảy ra tại t sẽ không có ý nghĩa.
| bản sao | độ trễ (ms) | thông lượng (Kops/sec) | ||||
|---|---|---|---|---|---|---|
| ghi | giao dịch chỉ đọc | đọc snapshot | ghi | giao dịch chỉ đọc | đọc snapshot | |
| 1D | 9.4±.6 | — | — | 4.0±.3 | — | — |
| 1 | 14.4±1.0 | 1.4±.1 | 1.3±.1 | 4.1±.05 | 10.9±.4 | 13.5±.1 |
| 3 | 13.9±.6 | 1.3±.1 | 1.2±.1 | 2.2±.5 | 13.8±3.2 | 38.5±.3 |
| 5 | 14.4±.4 | 1.4±.05 | 1.3±.04 | 2.8±.3 | 25.3±5.2 | 50.0±1.1 |
Bảng 3: Các phép đo chuẩn vi mô cho thao tác. Trung bình và độ lệch chuẩn trên 10 lần chạy. 1D nghĩa là một bản sao với thời gian chờ xác nhận bị vô hiệu hóa.
4.2.4 Tinh chỉnh
như được định nghĩa ở trên có một điểm yếu, đó là một giao dịch đã chuẩn bị duy nhất ngăn tiến triển. Do đó, không có thao tác đọc nào có thể xảy ra tại các dấu thời gian muộn hơn, ngay cả khi các thao tác đọc không xung đột với giao dịch. Các xung đột giả như vậy có thể được loại bỏ bằng cách bổ sung cho một ánh xạ chi tiết từ các phạm vi khóa đến các dấu thời gian của giao dịch đã chuẩn bị. Thông tin này có thể được lưu trữ trong bảng khóa, vốn đã ánh xạ các phạm vi khóa tới siêu dữ liệu khóa. Khi một thao tác đọc đến, nó chỉ cần được kiểm tra với thời gian an toàn chi tiết cho các phạm vi khóa mà thao tác đọc đó xung đột.
như được định nghĩa ở trên có một điểm yếu tương tự: nếu một giao dịch vừa được commit, một giao dịch chỉ đọc không xung đột vẫn phải được gán để theo sau giao dịch đó. Do đó, việc thực thi của lần đọc có thể bị trì hoãn. Điểm yếu này có thể được khắc phục tương tự bằng cách bổ sung cho một ánh xạ chi tiết từ các khoảng khóa đến các dấu thời gian commit trong bảng khóa. (Chúng tôi vẫn chưa triển khai tối ưu hóa này.) Khi một giao dịch chỉ đọc đến, dấu thời gian của nó có thể được gán bằng cách lấy giá trị lớn nhất của đối với các khoảng khóa mà giao dịch xung đột, trừ khi có một giao dịch đã chuẩn bị xung đột (có thể được xác định từ thời gian an toàn chi tiết).
như được định nghĩa ở trên có một điểm yếu là nó không thể tiến triển khi không có các lần ghi Paxos. Nghĩa là, một lần đọc snapshot tại không thể thực thi ở các nhóm Paxos mà lần ghi cuối cùng xảy ra trước . Spanner giải quyết vấn đề này bằng cách tận dụng tính rời nhau của các khoảng thời gian thuê của leader. Mỗi leader Paxos tiến triển bằng cách duy trì một ngưỡng mà phía trên đó các dấu thời gian của các lần ghi trong tương lai sẽ xuất hiện: nó duy trì một ánh xạ từ số thứ tự Paxos đến dấu thời gian tối thiểu có thể được gán cho số thứ tự Paxos . Một replica có thể tiến triển đến khi nó đã áp dụng qua .
Một leader duy nhất có thể dễ dàng thực thi các cam kết của nó. Vì các dấu thời gian được cam kết nằm trong thời gian thuê của một leader, bất biến về tính rời nhau thực thi các cam kết giữa các leader. Nếu một leader muốn tiến triển vượt quá thời điểm kết thúc thời gian thuê của nó, trước tiên nó phải gia hạn thời gian thuê. Lưu ý rằng luôn được tiến triển đến giá trị cao nhất trong để duy trì tính rời nhau.
Một leader mặc định tiến triển các giá trị mỗi 8 giây. Do đó, khi không có các giao dịch đã chuẩn bị, các slave khỏe mạnh trong một nhóm Paxos không hoạt động có thể phục vụ các lần đọc tại các dấu thời gian cũ hơn 8 giây trong trường hợp xấu nhất. Một leader cũng có thể tiến triển các giá trị theo yêu cầu từ các slave.
5 Đánh giá
Trước tiên, chúng tôi đo hiệu năng của Spanner đối với sao chép, giao dịch và tính sẵn sàng. Sau đó, chúng tôi cung cấp một số dữ liệu về hành vi của TrueTime và một nghiên cứu tình huống về máy khách đầu tiên của chúng tôi, F1.
5.1 Các phép đo chuẩn vi mô
Bảng 3 trình bày một số phép đo chuẩn vi mô cho Spanner. Các phép đo này được thực hiện trên các máy chia sẻ thời gian: mỗi spanserver chạy trên các đơn vị lập lịch gồm 4GB RAM và 4 lõi (AMD Barcelona 2200MHz). Các máy khách được chạy trên các máy riêng biệt. Mỗi zone chứa một spanserver. Các máy khách và zone được đặt trong một tập hợp các trung tâm dữ liệu có khoảng cách mạng nhỏ hơn 1ms. (Một bố cục như vậy nên là phổ biến: hầu hết ứng dụng không cần phân phối toàn bộ dữ liệu của chúng trên toàn thế giới.) Cơ sở dữ liệu kiểm thử được tạo với 50 nhóm Paxos cùng với 2500 thư mục. Các thao tác là các lần đọc và ghi độc lập với kích thước 4KB. Tất cả các lần đọc được phục vụ từ bộ nhớ sau một lần compaction, do đó chúng tôi chỉ đo chi phí phụ trội của call stack của Spanner. Ngoài ra, một vòng đọc không được đo lường được thực hiện trước tiên để làm nóng mọi cache vị trí.
Đối với các thí nghiệm về độ trễ, các máy khách phát hành đủ ít thao tác để tránh xếp hàng tại các server. Từ các thí nghiệm 1-replica, thời gian chờ xác nhận là khoảng 5ms, và độ trễ Paxos là khoảng 9ms. Khi số lượng replica tăng lên, độ trễ giữ gần như không đổi với độ lệch chuẩn nhỏ hơn vì Paxos thực thi song song tại các replica của một nhóm. Khi số lượng replica tăng lên, độ trễ để đạt được quorum trở nên ít nhạy cảm hơn với sự chậm chạp tại một replica slave.
Đối với các thí nghiệm về thông lượng, các máy khách phát hành đủ nhiều thao tác để bão hòa các CPU của server.
| participants | latency (ms) | |
|---|---|---|
| mean | 99th percentile | |
| 1 | 17.0 ±1.4 | 75.0 ±34.9 |
| 2 | 24.5 ±2.5 | 87.6 ±35.9 |
| 5 | 31.5 ±6.2 | 104.5 ±52.2 |
| 10 | 30.0 ±3.7 | 95.6 ±25.4 |
| 25 | 35.5 ±5.6 | 100.4 ±42.7 |
| 50 | 42.7 ±4.1 | 93.7 ±22.9 |
| 100 | 71.4 ±7.6 | 131.2 ±17.6 |
| 200 | 150.5 ±11.0 | 320.3 ±35.1 |
Bảng 4: Khả năng mở rộng của xác nhận hai pha. Trung bình và độ lệch chuẩn trên 10 lần chạy.
Các lần đọc snapshot có thể thực thi tại bất kỳ replica nào được cập nhật mới nhất, vì vậy thông lượng của chúng tăng gần tuyến tính với số lượng replica. Các giao dịch chỉ đọc một lần đọc chỉ thực thi tại các leader vì việc gán dấu thời gian phải xảy ra tại các leader. Thông lượng của giao dịch chỉ đọc tăng theo số lượng replica vì số lượng spanserver hiệu dụng tăng lên: trong thiết lập thí nghiệm, số lượng spanserver bằng số lượng replica, và các leader được phân phối ngẫu nhiên giữa các zone. Thông lượng ghi được hưởng lợi từ cùng một hiện tượng thực nghiệm (điều này giải thích sự tăng thông lượng từ 3 đến 5 replica), nhưng lợi ích đó bị lấn át bởi sự gia tăng tuyến tính về lượng công việc được thực hiện cho mỗi lần ghi khi số lượng replica tăng lên.
Bảng 4 cho thấy xác nhận hai pha có thể mở rộng đến một số lượng participant hợp lý: nó tóm tắt một tập hợp thí nghiệm được thực hiện trên 3 zone, mỗi zone có 25 spanserver. Việc mở rộng lên đến 50 participant là hợp lý cả về giá trị trung bình và phân vị 99, và độ trễ bắt đầu tăng đáng kể tại 100 participant.
Hình 5 minh họa các lợi ích về tính sẵn sàng của việc chạy Spanner trong nhiều trung tâm dữ liệu. Hình này cho thấy kết quả của ba thí nghiệm về thông lượng khi có sự cố trung tâm dữ liệu, tất cả được chồng lên cùng một thang thời gian. Không gian kiểm thử bao gồm 5 zone , mỗi zone có 25 spanserver. Cơ sở dữ liệu kiểm thử được phân mảnh thành 1250 nhóm Paxos, và 100 máy khách kiểm thử liên tục phát hành các lần đọc không snapshot với tốc độ tổng hợp 50K reads/second. Tất cả leader được đặt rõ ràng trong . Năm giây sau khi bắt đầu mỗi kiểm thử, tất cả server trong một zone bị tắt: non-leader tắt ; leader-hard tắt ; leader-soft tắt , nhưng nó gửi thông báo đến tất cả server rằng chúng nên chuyển giao quyền lãnh đạo trước tiên.
Việc tắt không có ảnh hưởng đến thông lượng đọc. Việc tắt trong khi cho các leader thời gian để chuyển giao quyền lãnh đạo sang một zone khác có ảnh hưởng nhỏ: sự sụt giảm thông lượng không nhìn thấy trong đồ thị, nhưng vào khoảng 3-4%. Mặt khác, việc tắt mà không có cảnh báo gây ảnh hưởng nghiêm trọng: tốc độ hoàn thành giảm gần về 0. Tuy nhiên, khi các leader được bầu lại, thông lượng của hệ thống tăng lên xấp xỉ 100K reads/second do hai hiện tượng thực nghiệm: hệ thống có thêm công suất và các thao tác được xếp hàng trong khi leader không khả dụng. Do đó, thông lượng của hệ thống tăng lên trước khi lại ổn định ở tốc độ ổn định của nó.
Chúng tôi cũng có thể thấy ảnh hưởng của thực tế rằng các lease leader Paxos được đặt thành 10 giây. Khi chúng tôi tắt zone, thời điểm hết hạn lease leader cho các nhóm phải được phân phối đều trong 10 giây tiếp theo. Ngay sau khi mỗi lease từ một leader đã chết hết hạn, một leader mới được bầu. Khoảng 10 giây sau thời điểm tắt, tất cả các nhóm đều có leader và thông lượng đã được khôi phục. Thời gian lease ngắn hơn sẽ làm giảm ảnh hưởng của việc server chết đối với tính sẵn sàng, nhưng sẽ yêu cầu lượng lưu lượng mạng gia hạn lease lớn hơn. Chúng tôi đang trong quá trình thiết kế và triển khai một cơ chế sẽ khiến các slave giải phóng lease leader Paxos khi leader gặp sự cố.
5.2 Tính khả dụng
5.3 TrueTime
Có hai câu hỏi cần được trả lời liên quan đến TrueTime: liệu có thực sự là một cận của độ bất định đồng hồ hay không, và có thể trở nên tệ đến mức nào? Đối với câu hỏi đầu tiên, vấn đề nghiêm trọng nhất sẽ xảy ra nếu độ trôi của đồng hồ cục bộ lớn hơn 200us/sec: điều đó sẽ phá vỡ các giả định mà TrueTime đưa ra. Thống kê máy của chúng tôi cho thấy các CPU lỗi có khả năng xảy ra cao hơn 6 lần so với các đồng hồ lỗi. Nghĩa là, các vấn đề về đồng hồ cực kỳ hiếm gặp so với những vấn đề phần cứng nghiêm trọng hơn nhiều. Do đó, chúng tôi tin rằng triển khai của TrueTime đáng tin cậy như bất kỳ phần mềm nào khác mà Spanner phụ thuộc vào.
Hình 6 trình bày dữ liệu TrueTime được lấy từ vài nghìn máy spanserver trên các datacenter cách nhau tới 2200 km. Hình này biểu diễn các phân vị thứ 90, 99 và 99.9 của , được lấy mẫu tại các timeslave daemon ngay sau khi thăm dò các time master. Việc lấy mẫu này loại bỏ dạng răng cưa trong do độ bất định của đồng hồ cục bộ, và vì vậy đo độ bất định của time-master (thường là 0) cộng với độ trễ truyền thông tới các time master.
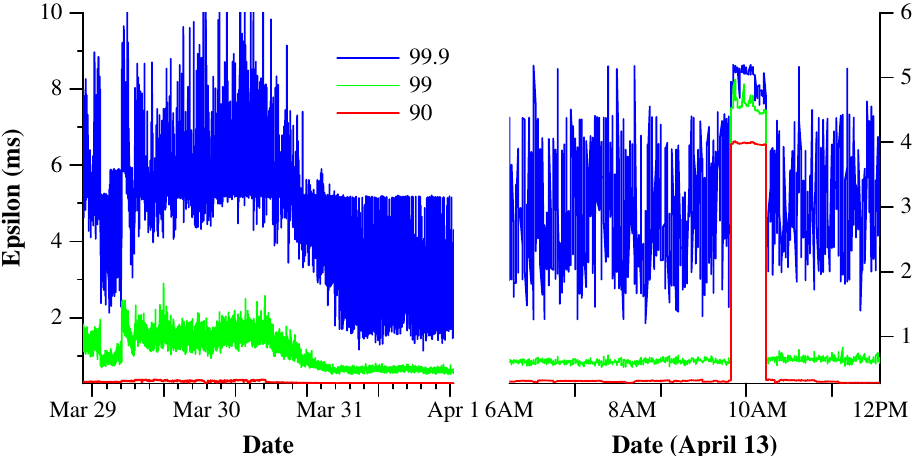
Dữ liệu cho thấy hai yếu tố này trong việc xác định giá trị cơ sở của nhìn chung không phải là vấn đề. Tuy nhiên, có thể có các vấn đề độ trễ đuôi đáng kể gây ra các giá trị cao hơn. Việc giảm độ trễ đuôi bắt đầu từ ngày 30 tháng 3 là do các cải tiến về mạng làm giảm tắc nghẽn tạm thời trên liên kết mạng. Sự gia tăng vào ngày 13 tháng 4, kéo dài khoảng một giờ, là do việc tắt 2 time master tại một datacenter để bảo trì định kỳ. Chúng tôi tiếp tục điều tra và loại bỏ các nguyên nhân gây ra các đột biến của TrueTime.
5.4 F1
Spanner bắt đầu được đánh giá thử nghiệm dưới các tải công việc sản xuất vào đầu năm 2011, như một phần của việc viết lại backend quảng cáo của Google có tên F1 [35]. Backend này ban đầu dựa trên một cơ sở dữ liệu MySQL được phân mảnh thủ công theo nhiều cách. Tập dữ liệu chưa nén có kích thước hàng chục terabyte, nhỏ so với nhiều phiên bản NoSQL, nhưng đủ lớn để gây khó khăn với MySQL đã phân mảnh. Cơ chế sharding của MySQL gán mỗi khách hàng và toàn bộ dữ liệu liên quan vào một shard cố định. Bố cục này cho phép sử dụng các chỉ mục và xử lý truy vấn phức tạp theo từng khách hàng, nhưng yêu cầu một số kiến thức về sharding trong logic nghiệp vụ của ứng dụng. Việc phân mảnh lại cơ sở dữ liệu quan trọng về doanh thu này khi số lượng khách hàng và dữ liệu của họ tăng lên có chi phí cực kỳ lớn. Lần phân mảnh lại cuối cùng mất hơn hai năm nỗ lực cao độ, và liên quan đến việc phối hợp và kiểm thử giữa hàng chục nhóm để giảm thiểu rủi ro. Thao tác này quá phức tạp để thực hiện thường xuyên: do đó, nhóm phải hạn chế sự tăng trưởng trên cơ sở dữ liệu MySQL bằng cách lưu trữ một số dữ liệu trong các Bigtables bên ngoài, điều này làm ảnh hưởng đến hành vi giao dịch và khả năng truy vấn trên toàn bộ dữ liệu.
Nhóm F1 chọn sử dụng Spanner vì một số lý do. Thứ nhất, Spanner loại bỏ nhu cầu phân mảnh lại thủ công. Thứ hai, Spanner cung cấp sao chép đồng bộ và chuyển đổi dự phòng tự động. Với sao chép master-slave của MySQL, chuyển đổi dự phòng rất khó khăn và có nguy cơ mất dữ liệu cũng như thời gian ngừng hoạt động. Thứ ba, F1 yêu cầu ngữ nghĩa giao dịch mạnh, khiến việc sử dụng các hệ thống NoSQL khác trở nên không thực tế. Ngữ nghĩa ứng dụng yêu cầu các giao dịch trên dữ liệu tùy ý và các lần đọc nhất quán. Nhóm F1 cũng cần các chỉ mục thứ cấp trên dữ liệu của họ (vì Spanner chưa cung cấp hỗ trợ tự động cho các chỉ mục thứ cấp), và có thể tự triển khai các chỉ mục toàn cục nhất quán bằng cách sử dụng các giao dịch Spanner.
Tất cả các ghi ứng dụng hiện được mặc định gửi qua F1 tới Spanner, thay vì ngăn xếp ứng dụng dựa trên MySQL. F1 có 2 bản sao ở bờ tây của Mỹ, và 3 bản sao ở bờ đông. Lựa chọn các site bản sao này được thực hiện để đối phó với các sự cố ngừng hoạt động do các thảm họa tự nhiên lớn có thể xảy ra, đồng thời cũng dựa trên lựa chọn các site frontend của họ. Theo quan sát không chính thức, chuyển đổi dự phòng tự động của Spanner gần như không thể nhận thấy đối với họ. Mặc dù đã có các sự cố cụm không được lên kế hoạch trong vài tháng gần đây, điều duy nhất mà nhóm F1 phải làm nhiều nhất là cập nhật lược đồ cơ sở dữ liệu của họ để cho Spanner biết nơi ưu tiên đặt các leader Paxos, nhằm giữ chúng gần nơi các frontend của họ đã di chuyển đến.
Ngữ nghĩa dấu thời gian của Spanner giúp F1 duy trì hiệu quả các cấu trúc dữ liệu trong bộ nhớ được tính toán từ trạng thái cơ sở dữ liệu. F1 duy trì một nhật ký lịch sử logic của tất cả thay đổi, được ghi vào chính Spanner như một phần của mỗi giao dịch. F1 lấy các snapshot đầy đủ của dữ liệu tại một dấu thời gian để khởi tạo các cấu trúc dữ liệu của mình, sau đó đọc các thay đổi gia tăng để cập nhật chúng.
Bảng 5 minh họa phân phối số lượng mảnh trên mỗi thư mục trong F1. Mỗi thư mục thường tương ứng với một khách hàng trong ngăn xếp ứng dụng phía trên F1. Phần lớn áp đảo các thư mục (và do đó là khách hàng) chỉ bao gồm 1 mảnh, điều này có nghĩa là các lần đọc và ghi dữ liệu của những khách hàng đó được đảm bảo chỉ xảy ra trên một server duy nhất. Các thư mục có hơn 100 mảnh đều là các bảng chứa các chỉ mục thứ cấp của F1: các lần ghi tới nhiều hơn một vài mảnh
| operation | latency (ms) | count | |
|---|---|---|---|
| mean | std dev | ||
| all reads | 8.7 | 376.4 | 21.5B |
| single-site commit | 72.3 | 112.8 | 31.2M |
| multi-site commit | 103.0 | 52.2 | 32.1M |
Bảng 6: Độ trễ thao tác được F1 cảm nhận được đo trong khoảng thời gian 24 giờ.
của các bảng như vậy cực kỳ hiếm gặp. Nhóm F1 chỉ quan sát thấy hành vi như vậy khi họ thực hiện các lần nạp dữ liệu hàng loạt chưa được tinh chỉnh dưới dạng các giao dịch.
Bảng 6 trình bày độ trễ của các thao tác Spanner được đo từ các server F1. Các bản sao trong các trung tâm dữ liệu ở bờ đông được ưu tiên cao hơn trong việc chọn các leader Paxos. Dữ liệu trong bảng được đo từ các server F1 trong các trung tâm dữ liệu đó. Độ lệch chuẩn lớn của độ trễ ghi là do phần đuôi khá lớn gây ra bởi các xung đột khóa. Độ lệch chuẩn thậm chí còn lớn hơn của độ trễ đọc một phần là do thực tế rằng các leader Paxos được phân bố trên hai trung tâm dữ liệu, chỉ một trong số đó có các máy với SSD. Ngoài ra, phép đo bao gồm mọi lần đọc trong hệ thống từ hai trung tâm dữ liệu: giá trị trung bình và độ lệch chuẩn của số byte được đọc lần lượt xấp xỉ là 1.6KB và 119KB.
6 Công trình liên quan
Sao chép nhất quán trên các datacenter như một dịch vụ lưu trữ đã được cung cấp bởi Megastore [5] và DynamoDB [3]. DynamoDB cung cấp một giao diện khóa-giá trị, và chỉ sao chép trong phạm vi một vùng. Spanner tiếp nối Megastore trong việc cung cấp một mô hình dữ liệu bán quan hệ, và thậm chí cả một ngôn ngữ lược đồ tương tự. Megastore không đạt được hiệu năng cao. Nó được xây dựng trên Bigtable, vốn áp đặt chi phí giao tiếp cao. Nó cũng không hỗ trợ các leader tồn tại lâu dài: nhiều bản sao có thể khởi tạo việc ghi. Tất cả các thao tác ghi từ các bản sao khác nhau tất yếu xung đột trong giao thức Paxos, ngay cả khi chúng không xung đột về mặt logic: thông lượng sụp đổ trên một nhóm Paxos ở mức vài thao tác ghi mỗi giây. Spanner cung cấp hiệu năng cao hơn, các giao dịch đa dụng, và tính nhất quán bên ngoài.
Pavlo et al. [31] đã so sánh hiệu năng của các cơ sở dữ liệu và MapReduce [12]. Họ chỉ ra một số nỗ lực khác đã được thực hiện để khám phá chức năng cơ sở dữ liệu được xây dựng trên các kho khóa-giá trị phân tán [1, 4, 7, 41] như bằng chứng rằng hai thế giới đang hội tụ. Chúng tôi đồng ý với kết luận này, nhưng chứng minh rằng việc tích hợp nhiều tầng có những ưu điểm: ví dụ, tích hợp kiểm soát đồng thời với sao chép làm giảm chi phí chờ xác nhận trong Spanner.
Khái niệm xây dựng các giao dịch trên một kho được sao chép có lịch sử ít nhất từ luận án của Gifford [16]. Scatter [17] là một kho khóa-giá trị dựa trên DHT gần đây, xây dựng các giao dịch trên lớp sao chép nhất quán. Spanner tập trung vào việc cung cấp một giao diện cấp cao hơn so với Scatter. Gray và Lamport [18] mô tả một giao thức xác nhận không chặn dựa trên Paxos. Giao thức của họ phát sinh nhiều chi phí thông điệp hơn so với xác nhận hai pha, điều này sẽ làm trầm trọng thêm chi phí xác nhận trên các nhóm được phân tán rộng rãi. Walter [36] cung cấp một biến thể của cô lập ảnh chụp nhanh hoạt động trong phạm vi một datacenter, nhưng không hoạt động xuyên qua các datacenter. Ngược lại, các giao dịch chỉ đọc của chúng tôi cung cấp một ngữ nghĩa tự nhiên hơn, bởi vì chúng tôi hỗ trợ tính nhất quán bên ngoài trên tất cả các thao tác.
Đã có một loạt công trình gần đây về việc giảm hoặc loại bỏ chi phí phụ trội của khóa. Calvin [40] loại bỏ kiểm soát đồng thời: nó gán trước các dấu thời gian và sau đó thực thi các giao dịch theo thứ tự dấu thời gian. H-Store [39] và Granola [11] mỗi hệ thống đều hỗ trợ cách phân loại riêng của chúng về các kiểu giao dịch, một số trong đó có thể tránh khóa. Không hệ thống nào trong số này cung cấp tính nhất quán bên ngoài. Spanner giải quyết vấn đề tranh chấp bằng cách cung cấp hỗ trợ cho cô lập ảnh chụp nhanh.
VoltDB [42] là một cơ sở dữ liệu trong bộ nhớ được phân mảnh hỗ trợ sao chép chủ-tớ trên diện rộng để khôi phục sau thảm họa, nhưng không hỗ trợ các cấu hình sao chép tổng quát hơn. Nó là một ví dụ về thứ được gọi là NewSQL, vốn là một sự thúc đẩy của thị trường nhằm hỗ trợ SQL có khả năng mở rộng [38]. Một số cơ sở dữ liệu thương mại triển khai việc đọc trong quá khứ, chẳng hạn như MarkLogic [26] và Oracle’s Total Recall [30]. Lomet và Li [24] mô tả một chiến lược triển khai cho một cơ sở dữ liệu thời gian như vậy.
Farsite suy ra các cận về độ không chắc chắn của đồng hồ (lớn hơn nhiều so với của TrueTime) so với một tham chiếu đồng hồ đáng tin cậy [13]: các hợp đồng thuê server trong Farsite được duy trì theo cùng cách mà Spanner duy trì các hợp đồng thuê Paxos. Các đồng hồ được đồng bộ lỏng đã được sử dụng cho các mục đích kiểm soát đồng thời trong các công trình trước đây [2, 23]. Chúng tôi đã chỉ ra rằng TrueTime cho phép suy luận về thời gian toàn cục trên các tập hợp máy trạng thái Paxos.
7 Công việc tương lai
Chúng tôi đã dành phần lớn năm vừa qua làm việc với đội F1 để chuyển backend quảng cáo của Google từ MySQL sang Spanner. Chúng tôi đang tích cực cải thiện các công cụ giám sát và hỗ trợ của nó, cũng như tinh chỉnh hiệu năng của nó. Ngoài ra, chúng tôi đã làm việc để cải thiện chức năng và hiệu năng của hệ thống sao lưu/khôi phục của mình. Hiện tại chúng tôi đang triển khai ngôn ngữ lược đồ Spanner, việc bảo trì tự động các chỉ mục phụ, và việc tái phân mảnh tự động dựa trên tải. Về lâu dài, có một vài tính năng mà chúng tôi dự định nghiên cứu. Việc thực hiện các đọc song song một cách lạc quan có thể là một chiến lược đáng theo đuổi, nhưng các thử nghiệm ban đầu đã chỉ ra rằng việc triển khai đúng là không tầm thường. Ngoài ra, chúng tôi dự định cuối cùng sẽ hỗ trợ các thay đổi trực tiếp của các cấu hình Paxos [22, 34].
Do chúng tôi kỳ vọng nhiều ứng dụng sẽ sao chép dữ liệu của chúng trên các trung tâm dữ liệu tương đối gần nhau, TrueTime có thể ảnh hưởng đáng kể đến hiệu năng. Chúng tôi không thấy trở ngại không thể vượt qua nào trong việc giảm xuống dưới 1ms. Các khoảng thời gian truy vấn time-master có thể được giảm xuống, và các tinh thể đồng hồ tốt hơn tương đối rẻ. Độ trễ truy vấn time-master có thể được giảm bằng công nghệ mạng được cải thiện, hoặc thậm chí có thể được tránh thông qua công nghệ phân phối thời gian thay thế.
Cuối cùng, có những lĩnh vực rõ ràng cần cải thiện. Mặc dù Spanner có khả năng mở rộng theo số lượng nút, các cấu trúc dữ liệu cục bộ của nút có hiệu năng tương đối kém đối với các truy vấn SQL phức tạp, bởi vì chúng được thiết kế cho các truy cập key-value đơn giản. Các thuật toán và cấu trúc dữ liệu từ tài liệu DB có thể cải thiện đáng kể hiệu năng của một nút đơn. Thứ hai, việc di chuyển dữ liệu tự động giữa các trung tâm dữ liệu để phản hồi các thay đổi trong tải của máy khách từ lâu đã là mục tiêu của chúng tôi, nhưng để mục tiêu đó có hiệu quả, chúng tôi cũng cần khả năng di chuyển các tiến trình ứng dụng máy khách giữa các trung tâm dữ liệu theo cách tự động, phối hợp. Việc di chuyển các tiến trình đặt ra vấn đề còn khó khăn hơn nữa về quản lý việc thu nhận và phân bổ tài nguyên giữa các trung tâm dữ liệu.
8 Kết luận
Tóm lại, Spanner kết hợp và mở rộng các ý tưởng từ hai cộng đồng nghiên cứu: từ cộng đồng cơ sở dữ liệu, một giao diện bán quan hệ quen thuộc, dễ sử dụng, các giao dịch, và một ngôn ngữ truy vấn dựa trên SQL; từ cộng đồng hệ thống, khả năng mở rộng, phân mảnh tự động, khả năng chịu lỗi, sao chép nhất quán, tính nhất quán bên ngoài, và phân phối diện rộng. Kể từ khi Spanner ra đời, chúng tôi đã mất hơn 5 năm để lặp lại qua các phiên bản nhằm đạt đến thiết kế và triển khai hiện tại. Một phần của giai đoạn lặp lại dài này là do việc nhận ra chậm rằng Spanner nên làm nhiều hơn việc giải quyết vấn đề về một không gian tên được sao chép toàn cầu, và cũng nên tập trung vào các tính năng cơ sở dữ liệu mà Bigtable còn thiếu.
Một khía cạnh trong thiết kế của chúng tôi nổi bật: yếu tố then chốt trong tập tính năng của Spanner là TrueTime. Chúng tôi đã chỉ ra rằng việc hiện thực hóa sự không chắc chắn của đồng hồ trong API thời gian giúp có thể xây dựng các hệ thống phân tán với ngữ nghĩa thời gian mạnh hơn nhiều. Ngoài ra, khi hệ thống nền tảng áp đặt các cận chặt chẽ hơn về sự không chắc chắn của đồng hồ, chi phí phụ trội của ngữ nghĩa mạnh hơn sẽ giảm xuống. Là một cộng đồng, chúng ta không nên còn phụ thuộc vào các đồng hồ được đồng bộ lỏng lẻo và các API thời gian yếu trong việc thiết kế các thuật toán phân tán.
Lời cảm ơn
Nhiều người đã giúp cải thiện bài báo này: người hỗ trợ của chúng tôi Jon Howell, người đã vượt xa trách nhiệm của mình; các phản biện ẩn danh; và nhiều Googler: Atul Adya, Fay Chang, Frank Dabek, Sean Dorward, Bob Gruber, David Held, Nick Kline, Alex Thomson, và Joel Wein. Ban quản lý của chúng tôi đã rất ủng hộ cả công việc của chúng tôi lẫn việc xuất bản bài báo này: Aristotle Balogh, Bill Coughran, Urs Hölzle, Doron Meyer, Cos Nicolaou, Kathy Polizzi, Sridhar Ramaswamy, và Shivakumar Venkataraman.
Chúng tôi đã xây dựng dựa trên công việc của các nhóm Bigtable và Megastore. Nhóm F1, đặc biệt là Jeff Shute, đã làm việc chặt chẽ với chúng tôi trong việc phát triển mô hình dữ liệu của chúng tôi và đã giúp rất nhiều trong việc truy tìm các lỗi về hiệu năng và tính đúng đắn. Nhóm Platforms, đặc biệt là Luiz Barroso và Bob Felderman, đã giúp biến True-Time thành hiện thực. Cuối cùng, nhiều Googler từng thuộc nhóm của chúng tôi: Ken Ashcraft, Paul Cychosz, Krzysztof Ostrowski, Amir Voskoboynik, Matthew Weaver, Theo Vassilakis, và Eric Veach; hoặc đã gia nhập nhóm của chúng tôi gần đây: Nathan Bales, Adam Beberg, Vadim Borisov, Ken Chen, Brian Cooper, Cian Cullinan, Robert-Jan Huijsman, Milind Joshi, Andrey Khorlin, Dawid Kuroczko, Laramie Leavitt, Eric Li, Mike Mammarella, Sunil Mushran, Simon Nielsen, Ovidiu Platon, Ananth Shrinivas, Vadim Susvorov, và Marcel van der Holst.