MapReduce: Xử lý dữ liệu đơn giản hóa trên các cụm lớn
Jeffrey Dean and Sanjay Ghemawat jeff@google.com, sanjay@google.com
Google, Inc.
Tóm tắt
MapReduce là một mô hình lập trình và một triển khai đi kèm để xử lý và tạo ra các tập dữ liệu lớn. Người dùng đặc tả một hàm map xử lý một cặp khóa/giá trị để tạo ra một tập các cặp khóa/giá trị trung gian, và một hàm reduce hợp nhất tất cả các giá trị trung gian được liên kết với cùng một khóa trung gian. Nhiều tác vụ thực tế có thể được biểu diễn trong mô hình này, như được trình bày trong bài báo.
Các chương trình được viết theo kiểu hàm này được tự động song song hóa và thực thi trên một cụm lớn các máy phổ thông. Hệ thống thời gian chạy xử lý các chi tiết của việc phân vùng dữ liệu đầu vào, lập lịch thực thi chương trình trên một tập hợp các máy, xử lý các sự cố của máy, và quản lý việc giao tiếp liên máy cần thiết. Điều này cho phép các lập trình viên không có kinh nghiệm về các hệ thống song song và phân tán dễ dàng sử dụng các tài nguyên của một hệ thống phân tán lớn.
Triển khai MapReduce của chúng tôi chạy trên một cụm lớn các máy phổ thông và có khả năng mở rộng cao: một tính toán MapReduce điển hình xử lý nhiều terabyte dữ liệu trên hàng nghìn máy. Các lập trình viên nhận thấy hệ thống dễ sử dụng: hàng trăm chương trình MapReduce đã được triển khai và hơn một nghìn công việc MapReduce được thực thi trên các cụm của Google mỗi ngày.
1 Giới thiệu
Trong năm năm qua, các tác giả và nhiều người khác tại Google đã triển khai hàng trăm phép tính chuyên dụng xử lý lượng lớn dữ liệu thô, chẳng hạn như các tài liệu được thu thập, nhật ký yêu cầu web, v.v., để tính toán nhiều loại dữ liệu dẫn xuất, chẳng hạn như các chỉ mục đảo, các dạng biểu diễn khác nhau của cấu trúc đồ thị của các tài liệu web, các bản tóm tắt về số trang được thu thập trên mỗi host, tập hợp các truy vấn thường xuyên nhất trong một ngày nhất định, v.v. Hầu hết các phép tính như vậy đều đơn giản về mặt khái niệm. Tuy nhiên, dữ liệu đầu vào thường rất lớn và các phép tính phải được phân tán trên hàng trăm hoặc hàng nghìn máy để hoàn thành trong khoảng thời gian hợp lý. Các vấn đề về cách song song hóa tính toán, phân phối dữ liệu và xử lý sự cố kết hợp lại làm che khuất phép tính đơn giản ban đầu bằng một lượng lớn mã phức tạp để giải quyết những vấn đề này.
Để đáp lại sự phức tạp này, chúng tôi thiết kế một trừu tượng hóa mới cho phép biểu đạt các phép tính đơn giản mà chúng tôi muốn thực hiện, nhưng che giấu các chi tiết rắc rối của việc song song hóa, khả năng chịu lỗi, phân phối dữ liệu và cân bằng tải trong một thư viện. Trừu tượng hóa của chúng tôi được lấy cảm hứng từ các nguyên thủy map và reduce có trong Lisp và nhiều ngôn ngữ hàm khác. Chúng tôi nhận thấy rằng hầu hết các phép tính của mình đều bao gồm việc áp dụng một thao tác map lên mỗi “bản ghi” logic trong đầu vào để tính một tập các cặp khóa/giá trị trung gian, sau đó áp dụng một thao tác reduce lên tất cả các giá trị có cùng khóa, nhằm kết hợp dữ liệu dẫn xuất một cách thích hợp. Việc sử dụng mô hình hàm với các thao tác map và reduce do người dùng chỉ định cho phép chúng tôi dễ dàng song song hóa các phép tính lớn và sử dụng việc thực thi lại làm cơ chế chính để chịu lỗi.
Những đóng góp chính của công trình này là một giao diện đơn giản và mạnh mẽ cho phép tự động song song hóa và phân phối các phép tính quy mô lớn, kết hợp với một triển khai của giao diện này đạt hiệu năng cao trên các cụm PC phổ thông.
Mục 2 mô tả mô hình lập trình cơ bản và đưa ra một số ví dụ. Mục 3 mô tả một triển khai của giao diện MapReduce được điều chỉnh cho môi trường tính toán dựa trên cụm của chúng tôi. Mục 4 mô tả một số cải tiến của mô hình lập trình mà chúng tôi nhận thấy hữu ích. Mục 5 trình bày các phép đo hiệu năng của triển khai của chúng tôi đối với nhiều loại tác vụ. Mục 6 khảo sát việc sử dụng MapReduce trong Google, bao gồm kinh nghiệm của chúng tôi khi sử dụng nó làm nền tảng để viết lại hệ thống lập chỉ mục phục vụ sản xuất. Mục 7 thảo luận về các công trình liên quan và công việc trong tương lai.
2 Mô hình lập trình
Tính toán nhận một tập các cặp khóa/giá trị đầu vào và tạo ra một tập các cặp khóa/giá trị đầu ra. Người dùng của thư viện MapReduce biểu diễn phép tính dưới dạng hai hàm: Map và Reduce.
Map, do người dùng viết, nhận một cặp đầu vào và tạo ra một tập các cặp khóa/giá trị trung gian. Thư viện MapReduce nhóm tất cả các giá trị trung gian gắn với cùng một khóa trung gian và truyền chúng cho hàm Reduce.
Hàm Reduce, cũng do người dùng viết, nhận một khóa trung gian và một tập các giá trị của khóa đó. Nó hợp nhất các giá trị này để tạo thành một tập giá trị có thể nhỏ hơn. Thông thường, mỗi lần gọi Reduce chỉ tạo ra không hoặc một giá trị đầu ra. Các giá trị trung gian được cung cấp cho hàm reduce của người dùng thông qua một bộ lặp (iterator). Điều này cho phép chúng tôi xử lý các danh sách giá trị quá lớn để chứa trong bộ nhớ.
2.1 Ví dụ
Xét bài toán đếm số lần xuất hiện của mỗi từ trong một tập hợp lớn các tài liệu. Người dùng sẽ viết mã tương tự mã giả sau:
              map(String key, String value):
    // key: document name
    // value: document contents
    for each word w in value:
        EmitIntermediate(w, "1");

reduce(String key, Iterator values):
    // key: a word
    // values: a list of counts
    int result = 0;
    for each v in values:
        result += ParseInt(v);
    Emit(AsString(result));
Hàm map phát ra mỗi từ cùng với số lần xuất hiện tương ứng (chỉ là ‘1’ trong ví dụ đơn giản này). Hàm reduce cộng tất cả các số đếm được phát ra cho một từ cụ thể.
Ngoài ra, người dùng viết mã để điền vào một đối tượng đặc tả mapreduce tên của các file đầu vào và đầu ra, cùng các tham số tinh chỉnh tùy chọn. Sau đó, người dùng gọi hàm MapReduce, truyền cho nó đối tượng đặc tả. Mã của người dùng được liên kết với thư viện MapReduce (được triển khai bằng C++). Phụ lục A chứa toàn bộ văn bản chương trình cho ví dụ này.
2.2 Các kiểu
Mặc dù mã giả trước đó được viết theo các đầu vào và đầu ra kiểu chuỗi, về mặt khái niệm, các hàm map và reduce do người dùng cung cấp có các kiểu tương ứng:
              map     (k1,v1)          → list(k2,v2)
reduce  (k2,list(v2))    → list(v2)
Tức là, các khóa và giá trị đầu vào được lấy từ một miền khác với miền của các khóa và giá trị đầu ra. Hơn nữa, các khóa và giá trị trung gian thuộc cùng miền với các khóa và giá trị đầu ra.
Cài đặt C++ của chúng tôi truyền các chuỗi đến và đi từ các hàm do người dùng định nghĩa và để mã của người dùng chuyển đổi giữa các chuỗi và các kiểu thích hợp.
2.3 Thêm ví dụ
Dưới đây là một vài ví dụ đơn giản về các chương trình thú vị có thể dễ dàng được biểu diễn dưới dạng các phép tính MapReduce.
Grep phân tán: Hàm map phát ra một dòng nếu nó khớp với mẫu được cung cấp. Hàm reduce là một hàm đồng nhất, chỉ sao chép dữ liệu trung gian được cung cấp sang đầu ra.
Đếm tần suất truy cập URL: Hàm map xử lý các nhật ký yêu cầu trang web và xuất . Hàm reduce cộng tất cả các giá trị của cùng một URL và phát ra một cặp .
Đồ thị liên kết Web đảo: Hàm map xuất các cặp cho mỗi liên kết đến một URL đích được tìm thấy trong một trang có tên source. Hàm reduce nối danh sách tất cả các URL nguồn gắn với một URL đích cho trước và phát ra cặp:
Vectơ thuật ngữ theo máy chủ: Một vectơ thuật ngữ tóm tắt các từ quan trọng nhất xuất hiện trong một tài liệu hoặc một tập tài liệu dưới dạng một danh sách các cặp . Hàm map phát ra một cặp cho mỗi tài liệu đầu vào (trong đó hostname được trích xuất từ URL của tài liệu). Hàm reduce nhận tất cả các vectơ thuật ngữ theo từng tài liệu của một máy chủ cho trước. Nó cộng các vectơ thuật ngữ này lại với nhau, loại bỏ các thuật ngữ ít xuất hiện, rồi phát ra một cặp cuối cùng.
Chỉ mục đảo: Hàm map phân tích từng tài liệu và phát ra một chuỗi các cặp . Hàm reduce nhận tất cả các cặp của một từ cho trước, sắp xếp các ID tài liệu tương ứng và phát ra một cặp . Tập hợp tất cả các cặp đầu ra tạo thành một chỉ mục đảo đơn giản. Có thể dễ dàng mở rộng phép tính này để theo dõi vị trí của các từ.
Sắp xếp phân tán: Hàm map trích xuất khóa từ mỗi bản ghi và phát ra một cặp . Hàm reduce phát ra tất cả các cặp không thay đổi. Phép tính này phụ thuộc vào các cơ chế phân vùng được mô tả trong Mục 4.1 và các thuộc tính thứ tự được mô tả trong Mục 4.2.
3 Cài đặt
Có thể có nhiều cách cài đặt khác nhau cho giao diện MapReduce. Lựa chọn phù hợp phụ thuộc vào môi trường. Ví dụ, một cài đặt có thể phù hợp với một máy nhỏ có bộ nhớ chia sẻ, một cài đặt khác cho một máy đa bộ xử lý NUMA lớn, và một cài đặt khác nữa cho một tập hợp các máy được kết nối mạng thậm chí còn lớn hơn.
Phần này mô tả một cài đặt hướng tới môi trường tính toán được sử dụng rộng rãi tại Google: các cụm lớn gồm các PC phổ thông được kết nối với nhau bằng Ethernet chuyển mạch [4]. Trong môi trường của chúng tôi:
(1) Các máy thường là các bộ xử lý x86 hai bộ xử lý chạy Linux, với 2-4 GB bộ nhớ trên mỗi máy.
(2) Phần cứng mạng phổ thông được sử dụng – thường là 100 megabits/second hoặc 1 gigabit/second ở mức máy, nhưng trung bình thấp hơn đáng kể xét về băng thông chia đôi tổng thể.
(3) Một cluster bao gồm hàng trăm hoặc hàng nghìn máy, và do đó sự cố máy xảy ra thường xuyên.
(4) Lưu trữ được cung cấp bởi các ổ đĩa IDE giá rẻ được gắn trực tiếp vào từng máy riêng lẻ. Một hệ thống file phân tán [8] được phát triển nội bộ được sử dụng để quản lý dữ liệu được lưu trữ trên các ổ đĩa này. Hệ thống file sử dụng sao chép để cung cấp tính sẵn sàng và độ tin cậy trên phần cứng không đáng tin cậy.
(5) Người dùng gửi các job đến một hệ thống lập lịch. Mỗi job bao gồm một tập hợp các tác vụ, và được bộ lập lịch ánh xạ tới một tập hợp các máy khả dụng trong một cluster.
3.1 Tổng quan về thực thi
Các lời gọi Map được phân tán trên nhiều máy bằng cách tự động phân vùng dữ liệu đầu vào thành một tập hợp gồm phần chia. Các phần chia đầu vào có thể được xử lý song song bởi các máy khác nhau. Các lời gọi Reduce được phân tán bằng cách phân vùng không gian khóa trung gian thành phần bằng cách sử dụng một hàm phân vùng (ví dụ, hash(key) mod ). Số lượng phân vùng () và hàm phân vùng được người dùng chỉ định.
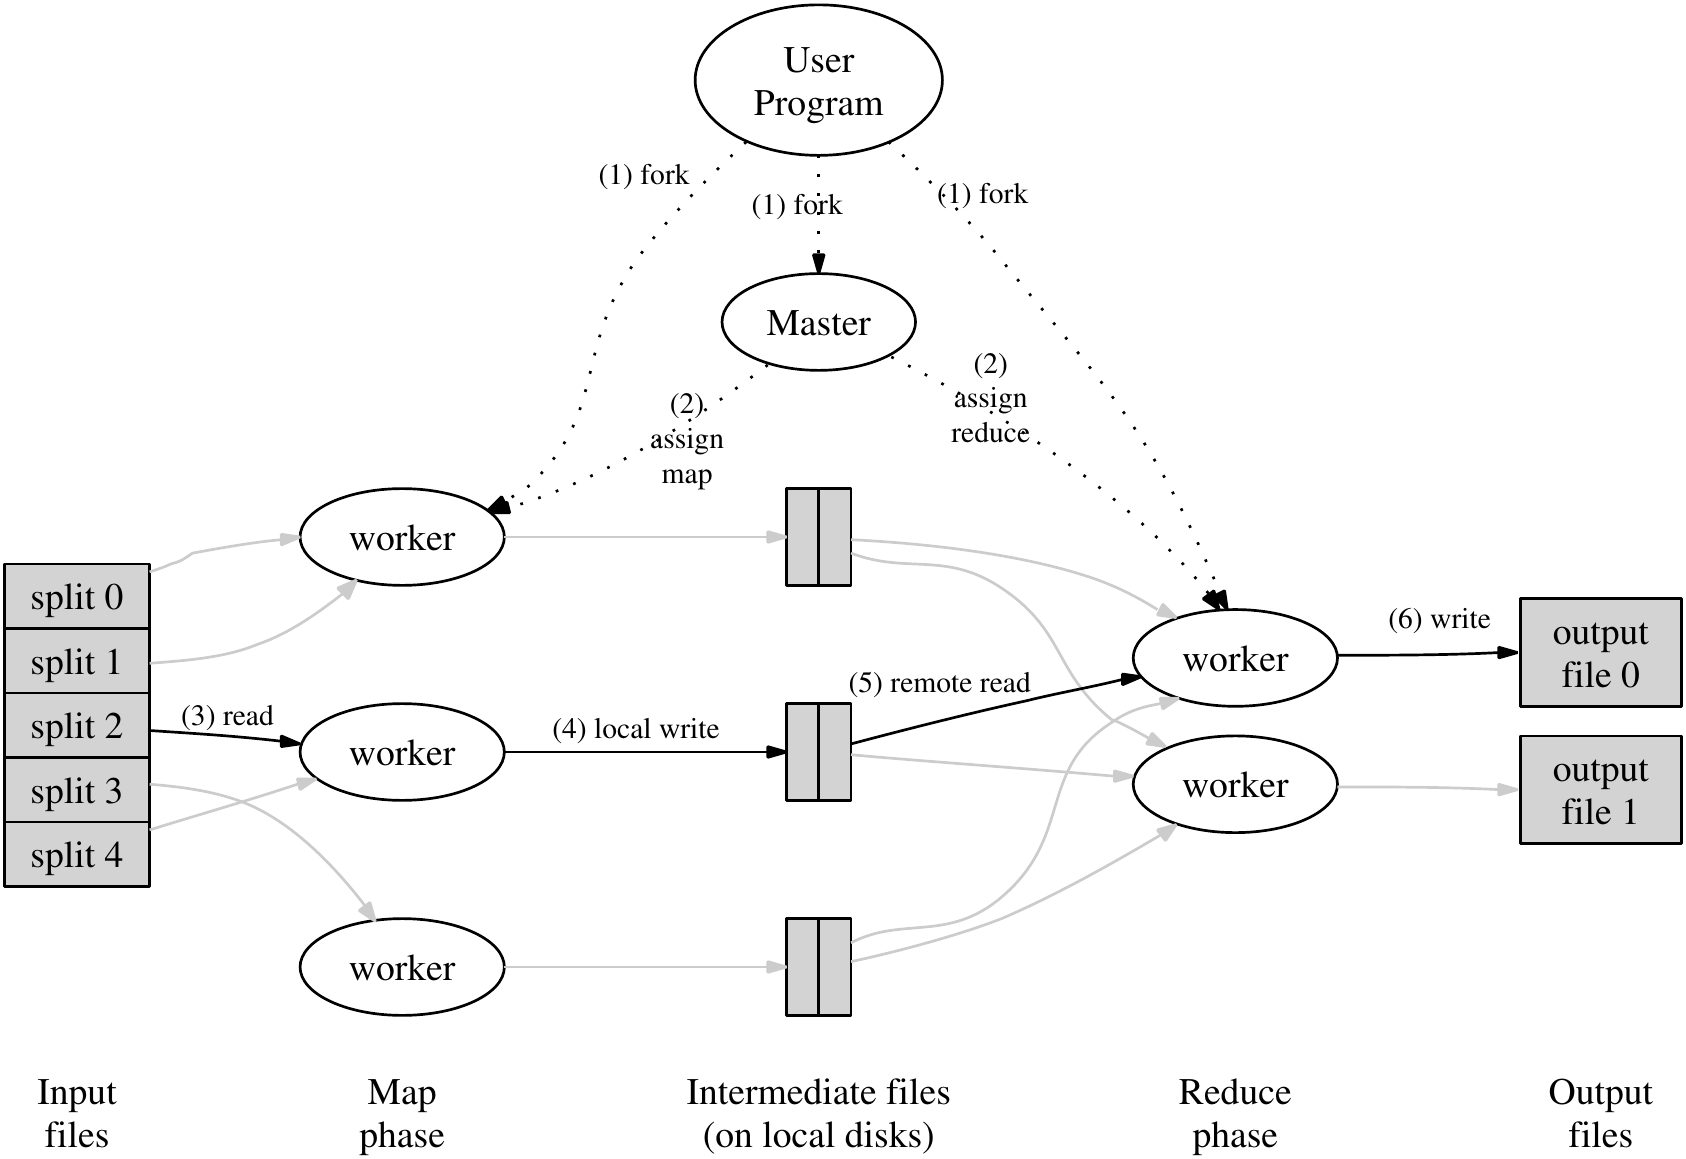
Figure 1 cho thấy luồng tổng thể của một thao tác MapReduce trong cài đặt của chúng tôi. Khi chương trình người dùng gọi hàm MapReduce, chuỗi hành động sau đây xảy ra (các nhãn được đánh số trong Figure 1 tương ứng với các số trong danh sách dưới đây):
- Thư viện MapReduce trong chương trình người dùng trước tiên chia các file đầu vào thành phần, thường có kích thước từ 16 megabytes đến 64 megabytes (MB) cho mỗi phần (có thể được người dùng điều khiển thông qua một tham số tùy chọn). Sau đó nó khởi động nhiều bản sao của chương trình trên một cluster các máy.
- Một trong các bản sao của chương trình là đặc biệt – master. Các bản sao còn lại là các worker được master gán công việc. Có tác vụ map và tác vụ reduce cần được gán. Master chọn các worker đang rảnh và gán cho mỗi worker một tác vụ map hoặc một tác vụ reduce.
- Một worker được gán một tác vụ map đọc nội dung của phần chia đầu vào tương ứng. Nó phân tích cú pháp các cặp khóa/giá trị từ dữ liệu đầu vào và truyền từng cặp cho hàm Map do người dùng định nghĩa. Các cặp khóa/giá trị trung gian được tạo bởi hàm Map được lưu trong bộ đệm trong bộ nhớ.
- Định kỳ, các cặp được lưu trong bộ đệm được ghi vào đĩa cục bộ, được phân vùng thành vùng bởi hàm phân vùng. Vị trí của các cặp được lưu trong bộ đệm này trên đĩa cục bộ được truyền trở lại master, bộ phận chịu trách nhiệm chuyển tiếp các vị trí này tới các worker reduce.
- Khi một worker reduce được master thông báo về các vị trí này, nó sử dụng các lời gọi thủ tục từ xa để đọc dữ liệu được lưu trong bộ đệm từ các đĩa cục bộ của các worker map. Khi một worker reduce đã đọc toàn bộ dữ liệu trung gian, nó sắp xếp dữ liệu theo các khóa trung gian sao cho mọi lần xuất hiện của cùng một khóa được nhóm lại với nhau. Việc sắp xếp là cần thiết vì thông thường nhiều khóa khác nhau được ánh xạ tới cùng một tác vụ reduce. Nếu lượng dữ liệu trung gian quá lớn để vừa trong bộ nhớ, một phép sắp xếp ngoài được sử dụng.
- Worker reduce duyệt qua dữ liệu trung gian đã sắp xếp và với mỗi khóa trung gian duy nhất gặp được, nó truyền khóa đó cùng với tập các giá trị trung gian tương ứng tới hàm Reduce của người dùng. Đầu ra của hàm Reduce được nối thêm vào một file đầu ra cuối cùng cho phân vùng reduce này.
- Khi tất cả các tác vụ map và tác vụ reduce đã hoàn thành, master đánh thức chương trình người dùng. Tại thời điểm này, lời gọi MapReduce trong chương trình người dùng trả quyền điều khiển trở lại mã của người dùng.
Sau khi hoàn thành thành công, đầu ra của thực thi mapreduce có sẵn trong các file đầu ra (mỗi file cho một tác vụ reduce, với tên file do người dùng chỉ định). Thông thường, người dùng không cần kết hợp các file đầu ra này thành một file – họ thường truyền các file này làm đầu vào cho một lời gọi MapReduce khác, hoặc sử dụng chúng từ một ứng dụng phân tán khác có khả năng xử lý đầu vào được phân vùng thành nhiều file.
3.2 Cấu trúc dữ liệu của Master
Master duy trì một số cấu trúc dữ liệu. Đối với mỗi tác vụ map và tác vụ reduce, nó lưu trữ trạng thái (idle, in-progress, hoặc completed), và định danh của máy worker (đối với các tác vụ không ở trạng thái idle).
Master là kênh thông qua đó vị trí của các vùng file trung gian được truyền từ các tác vụ map tới các tác vụ reduce. Vì vậy, đối với mỗi tác vụ map đã hoàn thành, master lưu trữ vị trí và kích thước của vùng file trung gian được tạo ra bởi tác vụ map đó. Các cập nhật về thông tin vị trí và kích thước này được nhận khi các tác vụ map hoàn thành. Thông tin được đẩy tăng dần tới các worker đang có các tác vụ reduce đang tiến hành.
3.3 Khả năng chịu lỗi
Vì thư viện MapReduce được thiết kế để giúp xử lý lượng dữ liệu rất lớn bằng cách sử dụng hàng trăm hoặc hàng nghìn máy, thư viện phải có khả năng chịu các sự cố máy một cách linh hoạt.
Lỗi của Worker
Bộ master ping tới mọi worker theo định kỳ. Nếu không nhận được phản hồi từ một worker trong một khoảng thời gian nhất định, master đánh dấu worker đó là đã gặp sự cố. Bất kỳ tác vụ map nào được worker hoàn thành đều được đặt lại về trạng thái nhàn rỗi ban đầu, và do đó trở nên đủ điều kiện để được lập lịch trên các worker khác. Tương tự, bất kỳ tác vụ map hoặc reduce nào đang thực thi trên một worker đã gặp sự cố cũng được đặt lại về trạng thái nhàn rỗi và trở nên đủ điều kiện để được lập lịch lại.
Các tác vụ map đã hoàn thành được thực thi lại khi xảy ra sự cố vì đầu ra của chúng được lưu trên các đĩa cục bộ của máy đã gặp sự cố và do đó không thể truy cập được. Các tác vụ reduce đã hoàn thành không cần được thực thi lại vì đầu ra của chúng được lưu trong một hệ thống file toàn cục.
Khi một tác vụ map được thực thi lần đầu bởi worker và sau đó được thực thi lại bởi worker (vì đã gặp sự cố), tất cả worker đang thực thi các tác vụ reduce được thông báo về việc thực thi lại. Bất kỳ tác vụ reduce nào chưa đọc dữ liệu từ worker A sẽ đọc dữ liệu từ worker B.
MapReduce có khả năng chống chịu với các sự cố worker ở quy mô lớn. Ví dụ, trong một phép tính MapReduce, việc bảo trì mạng trên một cluster đang chạy đã khiến các nhóm gồm 80 máy mỗi lần không thể truy cập được trong vài phút. Master MapReduce chỉ đơn giản thực thi lại công việc do các máy worker không thể truy cập thực hiện, và tiếp tục tiến triển, cuối cùng hoàn thành phép tính MapReduce.
Sự cố master
Dễ dàng khiến master ghi các điểm kiểm tra định kỳ của các cấu trúc dữ liệu master được mô tả ở trên. Nếu tác vụ master bị dừng, một bản sao mới có thể được khởi động từ trạng thái được lưu tại điểm kiểm tra gần nhất. Tuy nhiên, do chỉ có một master duy nhất, khả năng xảy ra sự cố của nó là thấp; vì vậy triển khai hiện tại của chúng tôi hủy bỏ phép tính MapReduce nếu master gặp sự cố. Các máy khách có thể kiểm tra điều kiện này và thử lại phép tính MapReduce nếu muốn.
Ngữ nghĩa khi có sự cố
Khi các toán tử map và reduce do người dùng cung cấp là các hàm tất định của các giá trị đầu vào, triển khai phân tán của chúng tôi tạo ra cùng một đầu ra như đầu ra được tạo ra bởi một thực thi tuần tự không có lỗi của toàn bộ chương trình.
Chúng tôi dựa vào các lần commit nguyên tử của đầu ra của các tác vụ map và reduce để đạt được tính chất này. Mỗi tác vụ đang thực thi ghi đầu ra của nó vào các file tạm riêng tư. Một tác vụ reduce tạo ra một file như vậy, còn một tác vụ map tạo ra file như vậy (mỗi file tương ứng với một tác vụ reduce). Khi một tác vụ map hoàn thành, worker gửi một thông báo tới master và bao gồm tên của file tạm trong thông báo. Nếu master nhận được thông báo hoàn thành cho một tác vụ map đã hoàn thành trước đó, nó bỏ qua thông báo này. Ngược lại, nó ghi lại tên của file trong một cấu trúc dữ liệu master.
Khi một tác vụ reduce hoàn thành, worker reduce đổi tên nguyên tử file đầu ra tạm thời của nó thành file đầu ra cuối cùng. Nếu cùng một tác vụ reduce được thực thi trên nhiều máy, nhiều lời gọi đổi tên sẽ được thực hiện cho cùng một file đầu ra cuối cùng. Chúng tôi dựa vào thao tác đổi tên nguyên tử do hệ thống file bên dưới cung cấp để đảm bảo rằng trạng thái hệ thống file cuối cùng chỉ chứa dữ liệu được tạo ra bởi một lần thực thi của tác vụ reduce.
Phần lớn các toán tử map và reduce của chúng tôi là tất định, và việc ngữ nghĩa của chúng tôi tương đương với một thực thi tuần tự trong trường hợp này khiến các lập trình viên rất dễ suy luận về hành vi của chương trình của họ. Khi các toán tử map và/hoặc reduce là không tất định, chúng tôi cung cấp ngữ nghĩa yếu hơn nhưng vẫn hợp lý. Với các toán tử không tất định, đầu ra của một tác vụ reduce cụ thể tương đương với đầu ra cho được tạo ra bởi một thực thi tuần tự của chương trình không tất định. Tuy nhiên, đầu ra của một tác vụ reduce khác có thể tương ứng với đầu ra cho được tạo ra bởi một thực thi tuần tự khác của chương trình không tất định.
Xét tác vụ map và các tác vụ reduce và . Gọi là thực thi của đã được commit (có đúng một thực thi như vậy). Ngữ nghĩa yếu hơn xuất hiện vì có thể đã đọc đầu ra được tạo bởi một lần thực thi của và có thể đã đọc đầu ra được tạo bởi một lần thực thi khác của .
3.4 Tính cục bộ
Băng thông mạng là một tài nguyên tương đối khan hiếm trong môi trường tính toán của chúng tôi. Chúng tôi tiết kiệm băng thông mạng bằng cách tận dụng thực tế rằng dữ liệu đầu vào (được quản lý bởi GFS [8]) được lưu trên các đĩa cục bộ của các máy tạo nên cluster của chúng tôi. GFS chia mỗi file thành các khối 64 MB, và lưu nhiều bản sao của mỗi khối (thông thường 3 bản sao) trên các máy khác nhau. Master MapReduce xem xét thông tin vị trí của các file đầu vào và cố gắng lập lịch một tác vụ map trên một máy chứa bản sao của dữ liệu đầu vào tương ứng. Nếu không thành công, nó cố gắng lập lịch một tác vụ map gần một bản sao của dữ liệu đầu vào của tác vụ đó (ví dụ, trên một máy worker nằm trên cùng bộ chuyển mạch mạng với máy chứa dữ liệu). Khi chạy các phép toán MapReduce lớn trên một phần đáng kể các worker trong một cluster, phần lớn dữ liệu đầu vào được đọc cục bộ và không tiêu tốn băng thông mạng.
3.5 Độ hạt của tác vụ
Chúng tôi chia nhỏ giai đoạn map thành phần và giai đoạn reduce thành phần, như đã mô tả ở trên. Lý tưởng nhất, và nên lớn hơn nhiều so với số lượng máy worker. Việc để mỗi worker thực hiện nhiều tác vụ khác nhau cải thiện cân bằng tải động, đồng thời cũng tăng tốc quá trình khôi phục khi một worker gặp sự cố: nhiều tác vụ map mà nó đã hoàn thành có thể được phân tán trên tất cả các máy worker khác.
Có các cận thực tế về độ lớn của và trong triển khai của chúng tôi, vì master phải đưa ra quyết định lập lịch và duy trì trạng thái trong bộ nhớ như đã mô tả ở trên. (Tuy nhiên, các hệ số hằng của việc sử dụng bộ nhớ là nhỏ: phần của trạng thái bao gồm xấp xỉ một byte dữ liệu cho mỗi cặp tác vụ map/tác vụ reduce.)
Hơn nữa, thường bị người dùng giới hạn vì đầu ra của mỗi tác vụ reduce cuối cùng được ghi vào một file đầu ra riêng biệt. Trong thực tế, chúng tôi có xu hướng chọn sao cho mỗi tác vụ riêng lẻ có khoảng 16 MB đến 64 MB dữ liệu đầu vào (để tối ưu hóa locality được mô tả ở trên đạt hiệu quả cao nhất), và chúng tôi đặt là một bội số nhỏ của số máy worker mà chúng tôi dự kiến sử dụng. Chúng tôi thường thực hiện các tính toán MapReduce với và , sử dụng 2,000 máy worker.
3.6 Các tác vụ dự phòng
Một trong những nguyên nhân phổ biến làm kéo dài tổng thời gian thực hiện một thao tác MapReduce là một “straggler”: một máy mất thời gian dài bất thường để hoàn thành một trong vài tác vụ map hoặc reduce cuối cùng trong phép tính. Straggler có thể phát sinh do rất nhiều nguyên nhân. Ví dụ, một máy có ổ đĩa bị lỗi có thể gặp các lỗi có thể sửa chữa thường xuyên làm giảm hiệu năng đọc của nó từ 30 MB/s xuống 1 MB/s. Hệ thống lập lịch cụm có thể đã lập lịch các tác vụ khác trên máy đó, khiến nó thực thi mã MapReduce chậm hơn do cạnh tranh về CPU, bộ nhớ, ổ đĩa cục bộ hoặc băng thông mạng. Một vấn đề gần đây mà chúng tôi gặp phải là một lỗi trong mã khởi tạo máy khiến các cache của bộ xử lý bị vô hiệu hóa: các phép tính trên những máy bị ảnh hưởng chậm hơn hơn một trăm lần.
Chúng tôi có một cơ chế tổng quát để giảm nhẹ vấn đề của các straggler. Khi một thao tác MapReduce gần hoàn thành, master lập lịch các thực thi dự phòng của các tác vụ còn đang tiến hành. Tác vụ được đánh dấu là đã hoàn thành bất cứ khi nào thực thi chính hoặc thực thi dự phòng hoàn thành. Chúng tôi đã tinh chỉnh cơ chế này để nó thường làm tăng các tài nguyên tính toán được sử dụng bởi thao tác không quá vài phần trăm. Chúng tôi nhận thấy rằng cơ chế này làm giảm đáng kể thời gian hoàn thành các thao tác MapReduce lớn. Ví dụ, chương trình sort được mô tả trong Section 5.3 mất nhiều hơn 44% thời gian để hoàn thành khi cơ chế tác vụ dự phòng bị vô hiệu hóa.
4 Các tinh chỉnh
Mặc dù chức năng cơ bản được cung cấp chỉ bằng cách viết các hàm Map và Reduce là đủ cho hầu hết nhu cầu, chúng tôi đã nhận thấy một vài phần mở rộng hữu ích. Các phần mở rộng này được mô tả trong phần này.
4.1 Hàm phân vùng
Người dùng MapReduce chỉ định số lượng tác vụ reduce/tệp đầu ra mà họ mong muốn (). Dữ liệu được phân vùng trên các tác vụ này bằng cách sử dụng một hàm phân vùng trên khóa trung gian. Một hàm phân vùng mặc định được cung cấp, sử dụng phép băm (ví dụ: “hash(key) mod ”). Điều này thường tạo ra các phân vùng được cân bằng khá tốt. Tuy nhiên, trong một số trường hợp, việc phân vùng dữ liệu bằng một hàm khác của khóa là hữu ích. Ví dụ, đôi khi các khóa đầu ra là các URL, và chúng tôi muốn tất cả các mục nhập cho một host duy nhất kết thúc trong cùng một tệp đầu ra. Để hỗ trợ các tình huống như vậy, người dùng của thư viện MapReduce có thể cung cấp một hàm phân vùng đặc biệt. Ví dụ, sử dụng “hash(Hostname(urlkey)) mod ” làm hàm phân vùng khiến tất cả URL từ cùng một host kết thúc trong cùng một tệp đầu ra.
4.2 Các đảm bảo về thứ tự
Chúng tôi đảm bảo rằng trong một phân vùng nhất định, các cặp khóa/giá trị trung gian được xử lý theo thứ tự khóa tăng dần. Đảm bảo về thứ tự này giúp dễ dàng tạo ra một tệp đầu ra đã sắp xếp cho mỗi phân vùng, điều này hữu ích khi định dạng tệp đầu ra cần hỗ trợ các thao tác tra cứu truy cập ngẫu nhiên hiệu quả theo khóa, hoặc người dùng của đầu ra thấy thuận tiện khi dữ liệu được sắp xếp.
4.3 Hàm Combiner
Trong một số trường hợp, có sự lặp lại đáng kể trong các khóa trung gian được tạo ra bởi mỗi tác vụ map, và hàm Reduce do người dùng chỉ định có tính giao hoán và kết hợp. Một ví dụ điển hình là ví dụ đếm từ trong Section 2.1. Vì tần suất từ có xu hướng tuân theo phân phối Zipf, mỗi tác vụ map sẽ tạo ra hàng trăm hoặc hàng nghìn bản ghi có dạng . Tất cả các số đếm này sẽ được gửi qua mạng đến một tác vụ reduce duy nhất và sau đó được cộng lại bởi hàm Reduce để tạo ra một số. Chúng tôi cho phép người dùng chỉ định một hàm Combiner tùy chọn thực hiện việc gộp một phần dữ liệu này trước khi nó được gửi qua mạng.
Hàm Combiner được thực thi trên mỗi máy thực hiện một tác vụ map. Thông thường cùng một mã được sử dụng để triển khai cả hàm combiner và hàm reduce. Khác biệt duy nhất giữa một hàm reduce và một hàm combiner là cách thư viện MapReduce xử lý đầu ra của hàm. Đầu ra của một hàm reduce được ghi vào tệp đầu ra cuối cùng. Đầu ra của một hàm combiner được ghi vào một tệp trung gian sẽ được gửi đến một tác vụ reduce.
Việc kết hợp một phần giúp tăng tốc đáng kể một số lớp thao tác MapReduce. Appendix A chứa một ví dụ sử dụng một combiner.
4.4 Các kiểu đầu vào và đầu ra
Thư viện MapReduce cung cấp hỗ trợ đọc dữ liệu đầu vào ở nhiều định dạng khác nhau. Ví dụ, đầu vào ở chế độ “text” xem mỗi dòng là một cặp khóa/giá trị: khóa là vị trí lệch trong tệp và giá trị là nội dung của dòng. Một định dạng được hỗ trợ phổ biến khác lưu trữ một chuỗi các cặp khóa/giá trị được sắp xếp theo khóa. Mỗi triển khai kiểu đầu vào biết cách chia chính nó thành các phạm vi có ý nghĩa để xử lý như các tác vụ map riêng biệt (ví dụ: việc chia phạm vi của chế độ text đảm bảo rằng các điểm chia phạm vi chỉ xảy ra tại ranh giới dòng). Người dùng có thể thêm hỗ trợ cho một kiểu đầu vào mới bằng cách cung cấp một triển khai của giao diện reader đơn giản, mặc dù hầu hết người dùng chỉ sử dụng một trong một số ít kiểu đầu vào được định nghĩa trước.
Một reader không nhất thiết cần cung cấp dữ liệu được đọc từ một tệp. Ví dụ, dễ dàng định nghĩa một reader đọc các bản ghi từ một cơ sở dữ liệu, hoặc từ các cấu trúc dữ liệu được ánh xạ trong bộ nhớ.
Theo cách tương tự, chúng tôi hỗ trợ một tập hợp các kiểu đầu ra để tạo dữ liệu ở các định dạng khác nhau và mã người dùng dễ dàng thêm hỗ trợ cho các kiểu đầu ra mới.
4.5 Side-effects
Trong một số trường hợp, người dùng MapReduce nhận thấy thuận tiện khi tạo các tệp phụ như các đầu ra bổ sung từ các toán tử map và/hoặc reduce của họ. Chúng tôi dựa vào người viết ứng dụng để làm cho các side-effect như vậy có tính nguyên tử và idempotent. Thông thường ứng dụng ghi vào một tệp tạm thời và đổi tên nguyên tử tệp này sau khi nó đã được tạo hoàn chỉnh.
Chúng tôi không cung cấp hỗ trợ cho các commit hai pha nguyên tử của nhiều tệp đầu ra được tạo bởi một tác vụ duy nhất. Vì vậy, các tác vụ tạo ra nhiều tệp đầu ra với các yêu cầu về tính nhất quán giữa các tệp nên có tính xác định. Hạn chế này chưa từng là một vấn đề trong thực tế.
4.6 Bỏ qua các bản ghi lỗi
Đôi khi có các lỗi trong mã người dùng khiến các hàm Map hoặc Reduce bị crash một cách xác định trên một số bản ghi nhất định. Các lỗi như vậy ngăn một thao tác MapReduce hoàn thành. Cách xử lý thông thường là sửa lỗi, nhưng đôi khi điều này không khả thi; có thể lỗi nằm trong một thư viện bên thứ ba mà mã nguồn không có sẵn. Ngoài ra, đôi khi việc bỏ qua một vài bản ghi là chấp nhận được, ví dụ khi thực hiện phân tích thống kê trên một tập dữ liệu lớn. Chúng tôi cung cấp một chế độ thực thi tùy chọn trong đó thư viện MapReduce phát hiện các bản ghi gây ra crash xác định và bỏ qua các bản ghi này để tiếp tục tiến trình.
Mỗi tiến trình worker cài đặt một bộ xử lý tín hiệu bắt các lỗi vi phạm phân đoạn và lỗi bus. Trước khi gọi một thao tác Map hoặc Reduce của người dùng, thư viện MapReduce lưu số thứ tự của đối số vào một biến toàn cục. Nếu mã nguồn của người dùng tạo ra một tín hiệu, bộ xử lý tín hiệu gửi một gói UDP “last gasp” chứa số thứ tự tới master MapReduce. Khi master đã thấy nhiều hơn một sự cố trên một bản ghi cụ thể, nó chỉ ra rằng bản ghi đó nên được bỏ qua khi nó phát hành lần thực thi lại tiếp theo của tác vụ Map hoặc Reduce tương ứng.
4.7 Thực thi cục bộ
Việc gỡ lỗi các vấn đề trong các hàm Map hoặc Reduce có thể phức tạp, vì tính toán thực tế diễn ra trong một hệ thống phân tán, thường trên vài nghìn máy, với các quyết định gán công việc được master đưa ra một cách động. Để hỗ trợ việc gỡ lỗi, lập hồ sơ và kiểm thử quy mô nhỏ, chúng tôi đã phát triển một triển khai thay thế của thư viện MapReduce, thực thi tuần tự toàn bộ công việc của một thao tác MapReduce trên máy cục bộ. Các điều khiển được cung cấp cho người dùng để tính toán có thể được giới hạn ở các tác vụ map cụ thể. Người dùng gọi chương trình của họ với một cờ đặc biệt và sau đó có thể dễ dàng sử dụng bất kỳ công cụ gỡ lỗi hoặc kiểm thử nào mà họ thấy hữu ích (ví dụ: gdb).
4.8 Thông tin trạng thái
Master chạy một server HTTP nội bộ và xuất ra một tập hợp các trang trạng thái để con người sử dụng. Các trang trạng thái hiển thị tiến trình của tính toán, chẳng hạn như có bao nhiêu tác vụ đã hoàn thành, bao nhiêu tác vụ đang được thực hiện, byte của đầu vào, byte của dữ liệu trung gian, byte của đầu ra, tốc độ xử lý, v.v. Các trang này cũng chứa các liên kết tới các file lỗi tiêu chuẩn và đầu ra tiêu chuẩn được tạo bởi mỗi tác vụ. Người dùng có thể sử dụng dữ liệu này để dự đoán tính toán sẽ mất bao lâu và liệu có nên thêm nhiều tài nguyên hơn vào tính toán hay không. Các trang này cũng có thể được sử dụng để xác định khi nào tính toán chậm hơn nhiều so với dự kiến.
Ngoài ra, trang trạng thái cấp cao nhất hiển thị những worker nào đã gặp sự cố, và những tác vụ map và reduce nào chúng đang xử lý khi gặp sự cố. Thông tin này hữu ích khi cố gắng chẩn đoán lỗi trong mã nguồn của người dùng.
4.9 Bộ đếm
Thư viện MapReduce cung cấp một tiện ích bộ đếm để đếm sự xuất hiện của các sự kiện khác nhau. Ví dụ, mã nguồn của người dùng có thể muốn đếm tổng số từ đã được xử lý hoặc số tài liệu tiếng Đức đã được lập chỉ mục, v.v.
Để sử dụng tiện ích này, mã nguồn của người dùng tạo một đối tượng bộ đếm có tên và sau đó tăng bộ đếm một cách thích hợp trong hàm Map và/hoặc Reduce. Ví dụ:
              Counter* uppercase;
uppercase = GetCounter("uppercase");

map(String name, String contents):
  for each word w in contents:
    if (IsCapitalized(w)):
      uppercase->Increment();
    EmitIntermediate(w, "1");
Các giá trị bộ đếm từ từng máy worker được truyền định kỳ tới master (được gắn kèm trong phản hồi ping). Master tổng hợp các giá trị bộ đếm từ các tác vụ map và reduce thành công và trả chúng về mã nguồn của người dùng khi thao tác MapReduce hoàn tất. Các giá trị bộ đếm hiện tại cũng được hiển thị trên trang trạng thái của master để con người có thể theo dõi tiến trình của tính toán đang chạy. Khi tổng hợp các giá trị bộ đếm, master loại bỏ ảnh hưởng của các lần thực thi trùng lặp của cùng một tác vụ map hoặc reduce để tránh đếm kép. (Các lần thực thi trùng lặp có thể phát sinh từ việc chúng tôi sử dụng các tác vụ sao lưu và từ việc thực thi lại các tác vụ do sự cố.)
Một số giá trị bộ đếm được thư viện MapReduce tự động duy trì, chẳng hạn như số cặp khóa/giá trị đầu vào đã được xử lý và số cặp khóa/giá trị đầu ra đã được tạo ra.
Người dùng nhận thấy tiện ích bộ đếm hữu ích để kiểm tra tính hợp lý của hành vi các thao tác MapReduce. Ví dụ, trong một số thao tác MapReduce, mã nguồn của người dùng có thể muốn đảm bảo rằng số cặp đầu ra được tạo ra chính xác bằng số cặp đầu vào đã được xử lý, hoặc rằng tỷ lệ tài liệu tiếng Đức được xử lý nằm trong một tỷ lệ chấp nhận được nào đó của tổng số tài liệu đã được xử lý.
5 Hiệu năng
Trong phần này, chúng tôi đo hiệu năng của MapReduce trên hai phép tính chạy trên một cụm lớn gồm nhiều máy. Một phép tính tìm kiếm trong khoảng một terabyte dữ liệu để tìm một mẫu cụ thể. Phép tính còn lại sắp xếp khoảng một terabyte dữ liệu.
Hai chương trình này đại diện cho một tập con lớn các chương trình thực tế do người dùng MapReduce viết – một lớp chương trình xáo trộn dữ liệu từ một biểu diễn này sang một biểu diễn khác, và một lớp khác trích xuất một lượng nhỏ dữ liệu đáng quan tâm từ một tập dữ liệu lớn.
5.1 Cấu hình cụm
Tất cả các chương trình được thực thi trên một cụm gồm khoảng 1800 máy. Mỗi máy có hai bộ xử lý Intel Xeon 2GHz với Hyper-Threading được bật, 4GB bộ nhớ, hai ổ đĩa IDE 160GB và một liên kết Ethernet gigabit. Các máy được bố trí trong một mạng chuyển mạch hình cây hai cấp với băng thông tổng hợp khoảng 100-200 Gbps khả dụng tại nút gốc. Tất cả các máy nằm trong cùng một cơ sở lưu trữ và do đó thời gian khứ hồi giữa bất kỳ cặp máy nào đều nhỏ hơn một mili giây.
Trong 4GB bộ nhớ, khoảng 1-1.5GB được dành riêng cho các tác vụ khác đang chạy trên cụm. Các chương trình được thực thi vào một buổi chiều cuối tuần, khi CPU, ổ đĩa và mạng phần lớn ở trạng thái nhàn rỗi.
5.2 Grep
Chương trình grep quét qua bản ghi 100-byte, tìm kiếm một mẫu ba ký tự tương đối hiếm (mẫu xuất hiện trong 92,337 bản ghi). Đầu vào được chia thành các phần khoảng 64MB (), và toàn bộ đầu ra được đặt trong một file ().
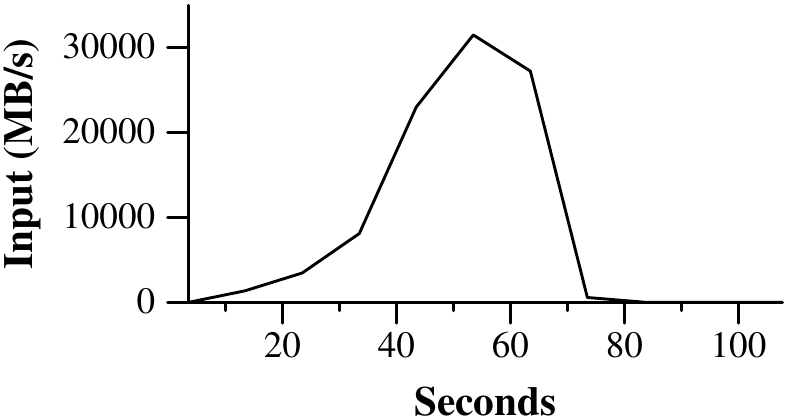
Hình 2 cho thấy tiến trình của phép tính theo thời gian. Trục Y biểu diễn tốc độ quét dữ liệu đầu vào. Tốc độ tăng dần khi có thêm máy được phân công cho phép tính MapReduce này, và đạt đỉnh trên 30 GB/s khi 1764 worker được phân công. Khi tác vụ map hoàn tất, tốc độ bắt đầu giảm và chạm mức 0 khoảng 80 giây sau khi phép tính bắt đầu. Toàn bộ phép tính mất khoảng 150 giây từ đầu đến cuối. Khoảng một phút trong số đó là chi phí phụ trội khởi động. Chi phí phụ trội này là do việc truyền chương trình đến tất cả các máy worker, cũng như các độ trễ khi tương tác với GFS để mở tập gồm 1000 file đầu vào và lấy thông tin cần thiết cho tối ưu hóa tính cục bộ.
5.3 Sort
Chương trình sort sắp xếp bản ghi 100-byte (khoảng một terabyte dữ liệu). Chương trình này được mô hình hóa theo phép đo chuẩn TeraSort [10].
Chương trình sắp xếp gồm chưa đến 50 dòng mã của người dùng. Một hàm Map ba dòng trích xuất một khóa sắp xếp 10-byte từ một dòng văn bản và phát ra khóa cùng
(a) Thực thi bình thường
(b) Không có tác vụ dự phòng
(c) 200 tác vụ bị hủy dòng văn bản gốc dưới dạng cặp khóa/giá trị trung gian. Chúng tôi sử dụng hàm Identity tích hợp sẵn làm toán tử Reduce. Hàm này truyền cặp khóa/giá trị trung gian không thay đổi thành cặp khóa/giá trị đầu ra. Đầu ra đã sắp xếp cuối cùng được ghi vào một tập các file GFS được sao chép 2 chiều (tức là 2 terabyte được ghi làm đầu ra của chương trình).
Như trước đây, dữ liệu đầu vào được chia thành các phần 64MB (). Chúng tôi phân vùng đầu ra đã sắp xếp thành 4000 file (). Hàm phân vùng sử dụng các byte đầu tiên của khóa để phân tách nó vào một trong phần.
Hàm phân vùng của chúng tôi cho phép đo chuẩn này có kiến thức tích hợp về phân phối của các khóa. Trong một chương trình sắp xếp tổng quát, chúng tôi sẽ thêm một phép tính MapReduce tiền xử lý để thu thập một mẫu các khóa và sử dụng phân phối của các khóa được lấy mẫu để tính các điểm phân tách cho lượt sắp xếp cuối cùng.
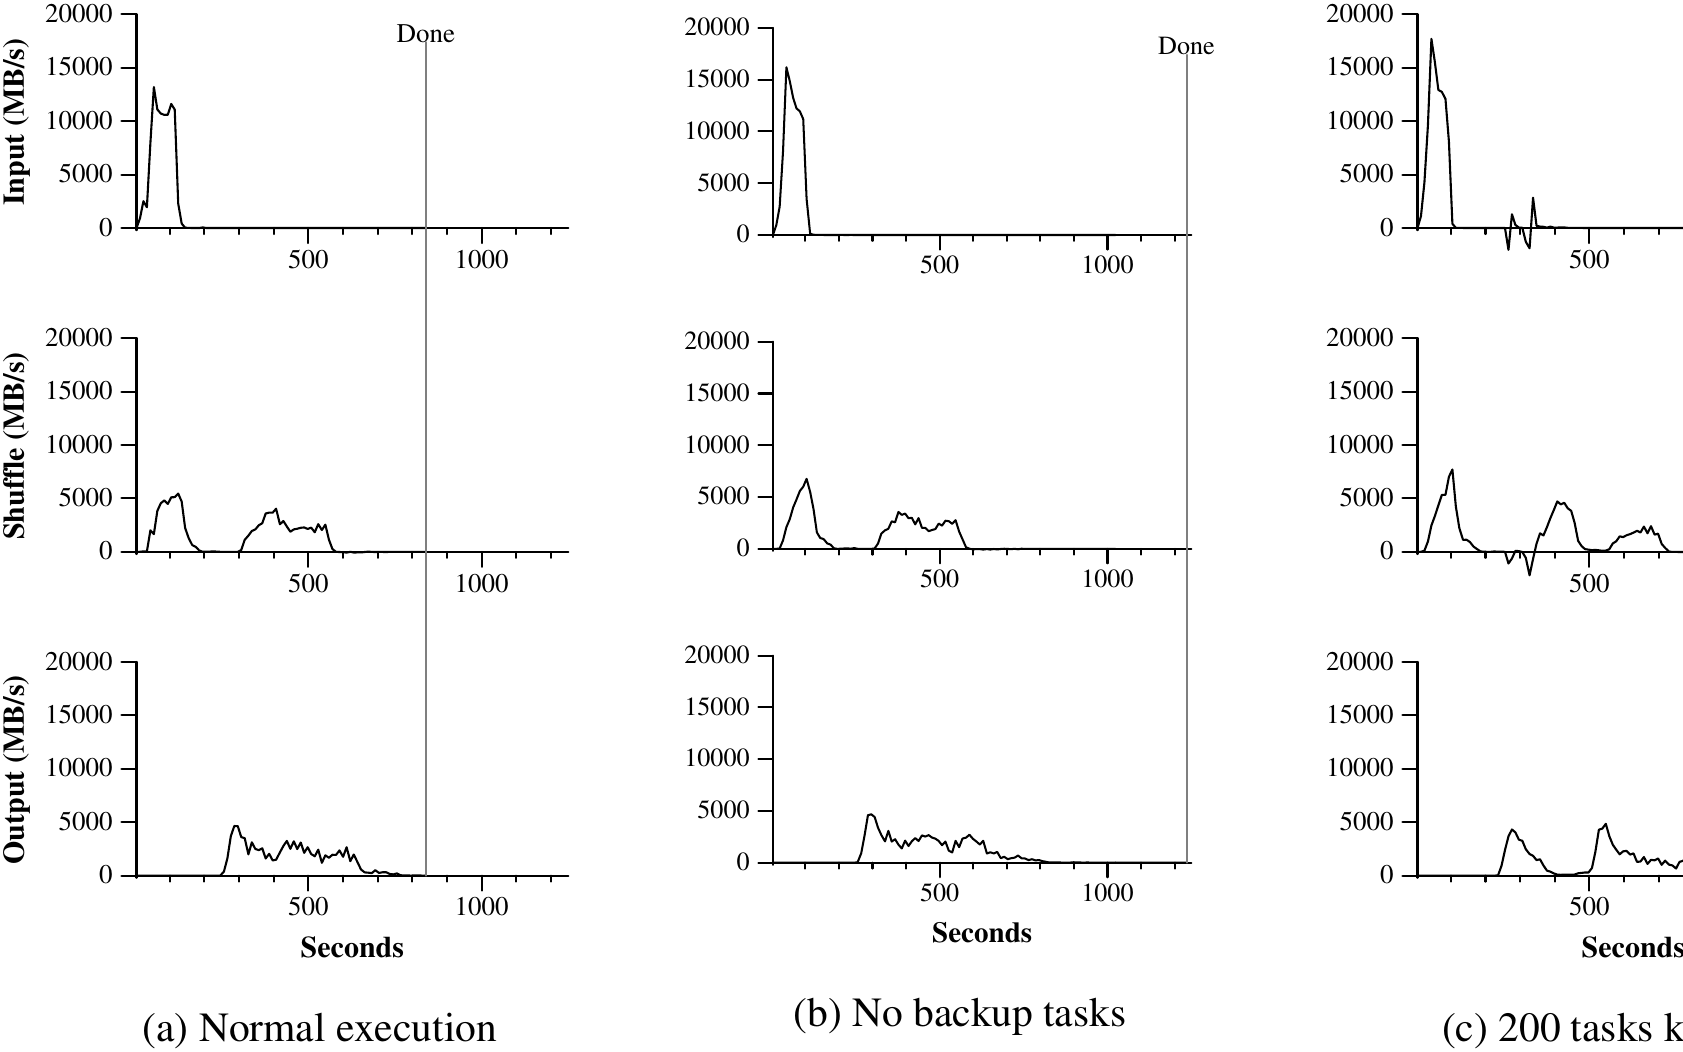
Hình 3 (a) cho thấy tiến trình của một lần thực thi bình thường của chương trình sort. Đồ thị phía trên bên trái cho thấy tốc độ đọc đầu vào. Tốc độ đạt đỉnh khoảng 13 GB/s và giảm khá nhanh vì tất cả các tác vụ map hoàn tất trước khi 200 giây trôi qua. Lưu ý rằng tốc độ đầu vào thấp hơn so với grep. Điều này là do các tác vụ map của sort dành khoảng một nửa thời gian và băng thông I/O để ghi đầu ra trung gian vào các ổ đĩa cục bộ của chúng. Đầu ra trung gian tương ứng của grep có kích thước không đáng kể.
Đồ thị phía giữa bên trái cho thấy tốc độ dữ liệu được gửi qua mạng từ các tác vụ map đến các tác vụ reduce. Việc xáo trộn này bắt đầu ngay khi tác vụ map đầu tiên hoàn tất. Đỉnh đầu tiên trong đồ thị tương ứng với lô đầu tiên gồm khoảng 1700 tác vụ reduce (toàn bộ MapReduce được phân công cho khoảng 1700 máy, và mỗi máy thực thi nhiều nhất một tác vụ reduce tại một thời điểm). Khoảng 300 giây sau khi phép tính bắt đầu, một số tác vụ reduce thuộc lô đầu tiên này hoàn tất và chúng tôi bắt đầu xáo trộn dữ liệu cho các tác vụ reduce còn lại. Toàn bộ việc xáo trộn hoàn tất khoảng 600 giây sau khi phép tính bắt đầu.
Đồ thị phía dưới bên trái cho thấy tốc độ dữ liệu đã sắp xếp được các tác vụ reduce ghi vào các file đầu ra cuối cùng. Có một độ trễ giữa thời điểm kết thúc giai đoạn xáo trộn đầu tiên và thời điểm bắt đầu giai đoạn ghi vì các máy đang bận sắp xếp dữ liệu trung gian. Việc ghi tiếp tục với tốc độ khoảng 2-4 GB/s trong một thời gian. Toàn bộ việc ghi hoàn tất khoảng 850 giây sau khi phép tính bắt đầu. Bao gồm chi phí phụ trội khởi động, toàn bộ phép tính mất 891 giây. Kết quả này tương tự kết quả tốt nhất hiện được báo cáo là 1057 giây đối với phép đo chuẩn TeraSort [18].
Một vài điều cần lưu ý: tốc độ đầu vào cao hơn tốc độ shuffle và tốc độ đầu ra do tối ưu hóa tính cục bộ của chúng tôi – phần lớn dữ liệu được đọc từ đĩa cục bộ và bỏ qua mạng của chúng tôi vốn bị hạn chế tương đối về băng thông. Tốc độ shuffle cao hơn tốc độ đầu ra vì giai đoạn đầu ra ghi hai bản sao của dữ liệu đã sắp xếp (chúng tôi tạo hai bản sao của đầu ra vì lý do độ tin cậy và tính sẵn sàng). Chúng tôi ghi hai bản sao vì đó là cơ chế đảm bảo độ tin cậy và tính sẵn sàng do hệ thống file nền tảng cung cấp. Yêu cầu về băng thông mạng khi ghi dữ liệu sẽ giảm nếu hệ thống file nền tảng sử dụng mã hóa xóa [14] thay vì sao chép.
5.4 Ảnh hưởng của các tác vụ dự phòng
Trong Hình 3 (b), chúng tôi trình bày một lần thực thi chương trình sort khi các tác vụ dự phòng bị vô hiệu hóa. Luồng thực thi tương tự như trong Hình 3 (a), ngoại trừ việc có một phần đuôi rất dài, trong đó hầu như không có hoạt động ghi nào xảy ra. Sau 960 giây, tất cả trừ 5 tác vụ reduce đã hoàn thành. Một vài tác vụ chậm cuối cùng chỉ hoàn thành sau 300 giây nữa. Toàn bộ tính toán mất 1283 giây, tăng 44% về thời gian thực.
5.5 Sự cố máy
Trong Hình 3 (c), chúng tôi trình bày một lần thực thi chương trình sort trong đó chúng tôi cố ý kết thúc 200 trong số 1746 tiến trình worker vài phút sau khi bắt đầu tính toán. Bộ lập lịch cụm nền tảng ngay lập tức khởi động lại các tiến trình worker mới trên những máy này (vì chỉ các tiến trình bị kết thúc, các máy vẫn hoạt động bình thường).
Sự cố của các worker xuất hiện dưới dạng tốc độ đầu vào âm vì một phần công việc map đã hoàn thành trước đó biến mất (do các worker map tương ứng bị kết thúc và cần được thực hiện lại). Việc thực thi lại công việc map này diễn ra tương đối nhanh. Toàn bộ tính toán hoàn thành trong 933 giây, bao gồm chi phí phụ trội khởi động (chỉ tăng 5% so với thời gian thực thi bình thường).
6 Kinh nghiệm
Chúng tôi đã viết phiên bản đầu tiên của thư viện MapReduce vào tháng 2 năm 2003, và thực hiện những cải tiến đáng kể đối với nó vào tháng 8 năm 2003, bao gồm tối ưu hóa tính cục bộ, cân bằng tải động của việc thực thi tác vụ trên các máy worker, v.v. Kể từ thời điểm đó, chúng tôi đã rất ngạc nhiên một cách tích cực về mức độ áp dụng rộng rãi của thư viện MapReduce đối với các loại bài toán mà chúng tôi xử lý. Nó đã được sử dụng trong nhiều lĩnh vực khác nhau bên trong Google, bao gồm:
- các bài toán học máy quy mô lớn,
- các bài toán phân cụm cho các sản phẩm Google News và Froogle,
- trích xuất dữ liệu được sử dụng để tạo báo cáo về các truy vấn phổ biến (ví dụ: Google Zeitgeist),
- trích xuất các thuộc tính của các trang web cho các thử nghiệm và sản phẩm mới (ví dụ: trích xuất vị trí địa lý từ một tập dữ liệu lớn các trang web cho tìm kiếm cục bộ), và
- các phép tính trên đồ thị quy mô lớn.
              Number of jobs                                      29,423
Average job completion time                         634 secs
Machine used                                       79,186 days
Input data read                                    3,288 TB
Intermediate data produced                           758 TB
Output data written                                  193 TB
Average worker machines per job                       157
Average worker deaths per job                         1.2
Average map tasks per job                           3,351
Average reduce tasks per job                           55
Unique map implementations                            395
Unique reduce implementations                         269
Unique map/reduce combinations                        426
Bảng 1: Các công việc MapReduce được chạy vào tháng 8 năm 2004
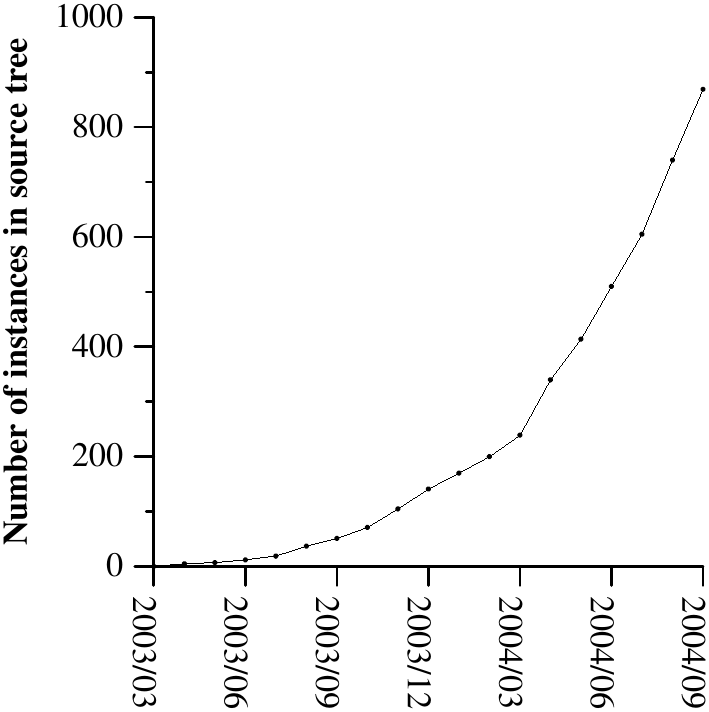
Hình 4 cho thấy sự tăng trưởng đáng kể về số lượng các chương trình MapReduce riêng biệt được đưa vào hệ thống quản lý mã nguồn chính của chúng tôi theo thời gian, từ 0 vào đầu năm 2003 đến gần 900 thể hiện riêng biệt vào cuối tháng 9 năm 2004. MapReduce đã thành công đến vậy vì nó cho phép viết một chương trình đơn giản và chạy nó một cách hiệu quả trên một nghìn máy trong khoảng thời gian nửa giờ, giúp tăng tốc đáng kể chu kỳ phát triển và tạo mẫu. Hơn nữa, nó cho phép các lập trình viên không có kinh nghiệm với các hệ thống phân tán và/hoặc song song dễ dàng khai thác lượng lớn tài nguyên.
Vào cuối mỗi công việc, thư viện MapReduce ghi nhật ký các thống kê về các tài nguyên tính toán được công việc sử dụng. Trong Bảng 1, chúng tôi trình bày một số thống kê cho một tập con các công việc MapReduce được chạy tại Google vào tháng 8 năm 2004.
6.1 Lập chỉ mục quy mô lớn
Một trong những cách sử dụng MapReduce quan trọng nhất của chúng tôi cho đến nay là viết lại hoàn toàn hệ thống lập chỉ mục sản xuất tạo ra các cấu trúc dữ liệu được sử dụng cho dịch vụ tìm kiếm web của Google. Hệ thống lập chỉ mục nhận đầu vào là một tập lớn các tài liệu đã được hệ thống thu thập dữ liệu của chúng tôi lấy về, được lưu trữ dưới dạng một tập các file GFS. Nội dung thô của các tài liệu này có kích thước hơn 20 terabyte dữ liệu. Quá trình lập chỉ mục chạy dưới dạng một chuỗi từ năm đến mười phép toán MapReduce. Việc sử dụng MapReduce (thay vì các lượt truyền phân tán đặc biệt trong phiên bản trước của hệ thống lập chỉ mục) đã mang lại một số lợi ích:
- Mã lập chỉ mục đơn giản hơn, nhỏ hơn và dễ hiểu hơn, bởi vì mã xử lý khả năng chịu lỗi, phân phối và song song hóa được ẩn bên trong thư viện MapReduce. Ví dụ, kích thước của một giai đoạn của phép tính đã giảm từ khoảng 3800 dòng mã C++ xuống còn khoảng 700 dòng khi được biểu diễn bằng MapReduce.
- Hiệu năng của thư viện MapReduce đủ tốt để chúng tôi có thể giữ các phép tính không liên quan về mặt khái niệm tách biệt, thay vì trộn chúng với nhau để tránh các lượt truyền bổ sung qua dữ liệu. Điều này giúp dễ dàng thay đổi quá trình lập chỉ mục. Ví dụ, một thay đổi mất vài tháng để thực hiện trong hệ thống lập chỉ mục cũ của chúng tôi chỉ mất vài ngày để triển khai trong hệ thống mới.
- Quá trình lập chỉ mục trở nên dễ vận hành hơn nhiều, bởi vì phần lớn các vấn đề do sự cố máy, máy chậm và các trục trặc mạng gây ra được thư viện MapReduce tự động xử lý mà không cần sự can thiệp của toán tử. Hơn nữa, có thể dễ dàng cải thiện hiệu năng của quá trình lập chỉ mục bằng cách thêm các máy mới vào cụm lập chỉ mục.
7 Công trình liên quan
Nhiều hệ thống đã cung cấp các mô hình lập trình bị hạn chế và sử dụng các hạn chế này để tự động song song hóa việc tính toán. Ví dụ, một hàm kết hợp có thể được tính trên tất cả các tiền tố của một mảng gồm phần tử trong thời gian trên bộ xử lý bằng cách sử dụng các phép tính tiền tố song song [6, 9, 13]. MapReduce có thể được xem là sự đơn giản hóa và chắt lọc của một số mô hình này dựa trên kinh nghiệm của chúng tôi với các phép tính thực tế quy mô lớn. Quan trọng hơn, chúng tôi cung cấp một triển khai chịu lỗi có khả năng mở rộng đến hàng nghìn bộ xử lý. Ngược lại, hầu hết các hệ thống xử lý song song chỉ được triển khai ở quy mô nhỏ hơn và để lại các chi tiết xử lý sự cố máy cho người lập trình.
Bulk Synchronous Programming [17] và một số nguyên thủy MPI [11] cung cấp các trừu tượng hóa cấp cao hơn giúp người lập trình dễ dàng viết các chương trình song song hơn. Một điểm khác biệt quan trọng giữa các hệ thống này và MapReduce là MapReduce khai thác một mô hình lập trình bị hạn chế để tự động song song hóa chương trình của người dùng và cung cấp khả năng chịu lỗi trong suốt.
Tối ưu hóa cục bộ của chúng tôi lấy cảm hứng từ các kỹ thuật như active disks [12, 15], trong đó việc tính toán được đẩy vào các phần tử xử lý gần với các đĩa cục bộ, nhằm giảm lượng dữ liệu được gửi qua các hệ thống con I/O hoặc mạng. Chúng tôi chạy trên các bộ xử lý phổ thông mà một số lượng nhỏ đĩa được kết nối trực tiếp với chúng thay vì chạy trực tiếp trên các bộ xử lý điều khiển đĩa, nhưng cách tiếp cận tổng quát là tương tự.
Cơ chế tác vụ dự phòng của chúng tôi tương tự với cơ chế lập lịch háo hức được sử dụng trong Charlotte System [3]. Một trong những thiếu sót của lập lịch háo hức đơn giản là nếu một tác vụ nhất định gây ra các sự cố lặp lại, toàn bộ tính toán sẽ không hoàn thành. Chúng tôi khắc phục một số trường hợp của vấn đề này bằng cơ chế bỏ qua các bản ghi xấu.
Triển khai MapReduce dựa vào một hệ thống quản lý cụm nội bộ chịu trách nhiệm phân phối và chạy các tác vụ của người dùng trên một tập hợp lớn các máy dùng chung. Mặc dù không phải là trọng tâm của bài báo này, hệ thống quản lý cụm có tinh thần tương tự như các hệ thống khác như Condor [16].
Cơ sở sắp xếp là một phần của thư viện MapReduce có hoạt động tương tự như NOW-Sort [1]. Các máy nguồn (các worker map) phân vùng dữ liệu cần sắp xếp và gửi nó đến một trong worker reduce. Mỗi worker reduce sắp xếp dữ liệu của mình cục bộ (trong bộ nhớ nếu có thể). Tất nhiên NOW-Sort không có các hàm Map và Reduce do người dùng định nghĩa, những hàm làm cho thư viện của chúng tôi có phạm vi áp dụng rộng rãi.
River [2] cung cấp một mô hình lập trình trong đó các tiến trình giao tiếp với nhau bằng cách gửi dữ liệu qua các hàng đợi phân tán. Giống như MapReduce, hệ thống River cố gắng cung cấp hiệu năng trường hợp trung bình tốt ngay cả khi có các sai khác không đồng nhất do phần cứng không đồng nhất hoặc các nhiễu loạn hệ thống gây ra. River đạt được điều này bằng cách lập lịch cẩn thận các truyền tải đĩa và mạng để đạt được thời gian hoàn thành cân bằng. MapReduce có một cách tiếp cận khác. Bằng cách hạn chế mô hình lập trình, khung MapReduce có thể phân vùng vấn đề thành một số lượng lớn các tác vụ có độ chi tiết nhỏ. Các tác vụ này được lập lịch động trên các worker khả dụng sao cho các worker nhanh hơn xử lý nhiều tác vụ hơn. Mô hình lập trình bị hạn chế cũng cho phép chúng tôi lập lịch các thực thi dư thừa của các tác vụ gần cuối công việc, điều này làm giảm đáng kể thời gian hoàn thành khi có các sai khác không đồng nhất (chẳng hạn như các worker chậm hoặc bị kẹt).
BAD-FS [5] có một mô hình lập trình rất khác so với MapReduce, và không giống MapReduce, được hướng tới việc thực thi các công việc trên một mạng diện rộng. Tuy nhiên, có hai điểm tương đồng cơ bản. (1) Cả hai hệ thống đều sử dụng thực thi dư thừa để khôi phục từ mất dữ liệu do các sự cố gây ra. (2) Cả hai đều sử dụng lập lịch nhận biết tính cục bộ để giảm lượng dữ liệu được gửi qua các liên kết mạng bị tắc nghẽn.
TACC [7] là một hệ thống được thiết kế để đơn giản hóa việc xây dựng các dịch vụ mạng có tính khả dụng cao. Giống như MapReduce, nó dựa vào việc thực thi lại như một cơ chế để triển khai khả năng chịu lỗi.
8 Kết luận
Mô hình lập trình MapReduce đã được sử dụng thành công tại Google cho nhiều mục đích khác nhau. Chúng tôi cho rằng thành công này đến từ một số lý do. Thứ nhất, mô hình này dễ sử dụng, ngay cả đối với các lập trình viên không có kinh nghiệm về các hệ thống song song và phân tán, vì nó che giấu các chi tiết của việc song song hóa, khả năng chịu lỗi, tối ưu hóa cục bộ và cân bằng tải. Thứ hai, một lượng lớn các bài toán có thể dễ dàng được biểu diễn dưới dạng các tính toán MapReduce. Ví dụ, MapReduce được sử dụng để tạo dữ liệu cho dịch vụ tìm kiếm web sản xuất của Google, để sắp xếp, khai phá dữ liệu, học máy và nhiều hệ thống khác. Thứ ba, chúng tôi đã phát triển một triển khai MapReduce có khả năng mở rộng tới các cụm máy lớn bao gồm hàng nghìn máy. Triển khai này sử dụng hiệu quả các tài nguyên máy này và do đó phù hợp để sử dụng cho nhiều bài toán tính toán lớn gặp phải tại Google.
Chúng tôi đã học được một số điều từ công trình này. Thứ nhất, việc hạn chế mô hình lập trình giúp dễ dàng song song hóa và phân phối các tính toán, đồng thời làm cho các tính toán đó có khả năng chịu lỗi. Thứ hai, băng thông mạng là một tài nguyên khan hiếm. Do đó, một số tối ưu hóa trong hệ thống của chúng tôi hướng tới việc giảm lượng dữ liệu được gửi qua mạng: tối ưu hóa cục bộ cho phép chúng tôi đọc dữ liệu từ các đĩa cục bộ, và việc ghi một bản sao duy nhất của dữ liệu trung gian vào đĩa cục bộ giúp tiết kiệm băng thông mạng. Thứ ba, thực thi dư thừa có thể được sử dụng để giảm tác động của các máy chậm, đồng thời xử lý các sự cố máy và mất dữ liệu.
Lời cảm ơn
Josh Levenberg đã đóng vai trò quan trọng trong việc sửa đổi và mở rộng API MapReduce ở mức người dùng với một số tính năng mới dựa trên kinh nghiệm của ông trong việc sử dụng MapReduce và các đề xuất cải tiến từ những người khác. MapReduce đọc đầu vào của nó từ và ghi đầu ra của nó vào Google File System [8]. Chúng tôi xin cảm ơn Mohit Aron, Howard Gobioff, Markus Gutschke, David Kramer, Shun-Tak Leung và Josh Redstone vì công việc của họ trong việc phát triển GFS. Chúng tôi cũng xin cảm ơn Percy Liang và Olcan Sercinoglu vì công việc của họ trong việc phát triển hệ thống quản lý cụm được MapReduce sử dụng. Mike Burrows, Wilson Hsieh, Josh Levenberg, Sharon Perl, Rob Pike và Debby Wallach đã đưa ra những nhận xét hữu ích về các bản thảo trước đó của bài báo này. Các phản biện ẩn danh của OSDI và người hướng dẫn của chúng tôi, Eric Brewer, đã đưa ra nhiều đề xuất hữu ích về những lĩnh vực mà bài báo có thể được cải thiện. Cuối cùng, chúng tôi cảm ơn tất cả người dùng MapReduce trong tổ chức kỹ thuật của Google vì đã cung cấp những phản hồi, đề xuất và báo cáo lỗi hữu ích.
A Tần suất từ
Phần này chứa một chương trình đếm số lần xuất hiện của mỗi từ duy nhất trong một tập hợp các file đầu vào được chỉ định trên dòng lệnh.
C
              #include "mapreduce/mapreduce.h"

// User’s map function
class WordCounter : public Mapper {
 public:
  virtual void Map(const MapInput& input) {
    const string& text = input.value();
    const int n = text.size();
    for (int i = 0; i < n; ) {
      // Skip past leading whitespace
      while ((i < n) && isspace(text[i]))
        i++;

      // Find word end
      int start = i;
      while ((i < n) && !isspace(text[i]))
        i++;
C
                    if (start < i)
        Emit(text.substr(start,i-start),"1");
    }
  }
};
REGISTER_MAPPER(WordCounter);

// User’s reduce function
class Adder : public Reducer {
  virtual void Reduce(ReduceInput* input) {
    // Iterate over all entries with the
    // same key and add the values
    int64 value = 0;
    while (!input->done()) {
      value += StringToInt(input->value());
      input->NextValue();
    }

    // Emit sum for input->key()
    Emit(IntToString(value));
  }
};
REGISTER_REDUCER(Adder);

int main(int argc, char** argv) {
  ParseCommandLineFlags(argc, argv);

  MapReduceSpecification spec;

  // Store list of input files into "spec"
  for (int i = 1; i < argc; i++) {
    MapReduceInput* input = spec.add_input();
    input->set_format("text");
    input->set_filepath(argv[i]);
    input->set_mapper_class("WordCounter");
  }

  // Specify the output files:
  //    /gfs/test/freq-00000-of-00100
  //    /gfs/test/freq-00001-of-00100
  //    ...
  MapReduceOutput* out = spec.output();
  out->set_filebase("/gfs/test/freq");
  out->set_num_tasks(100);
  out->set_format("text");
  out->set_reducer_class("Adder");

  // Optional: do partial sums within map
  // tasks to save network bandwidth
  out->set_combiner_class("Adder");

  // Tuning parameters: use at most 2000
  // machines and 100 MB of memory per task
  spec.set_machines(2000);
  spec.set_map_megabytes(100);
  spec.set_reduce_megabytes(100);

  // Now run it
  MapReduceResult result;
  if (!MapReduce(spec, &result)) abort();

  // Done: ’result’ structure contains info
  // about counters, time taken, number of
  // machines used, etc.

  return 0;
}