Dự án Máy Cơ sở dữ liệu Gamma
David J. DeWitt Shahram Ghandeharizadeh Donovan Schneider Allan Bricker Hui-I Hsiao Rick Rasmussen
Khoa Khoa học Máy tính Đại học Wisconsin
Nghiên cứu này được hỗ trợ một phần bởi Cơ quan Dự án Nghiên cứu Tiên tiến Quốc phòng theo hợp đồng N00039-86-C-0578, bởi Quỹ Khoa học Quốc gia theo tài trợ DCR-8512862, bởi một chương trình Trợ lý Nghiên cứu Sau đại học do DARPA/NASA tài trợ trong lĩnh vực Xử lý Song song, và bởi các khoản tài trợ nghiên cứu từ Intel Scientific Computers, Tandem Computers, và Digital Equipment Corporation.
TÓM TẮT
Bài báo này mô tả thiết kế của máy cơ sở dữ liệu Gamma và các kỹ thuật được sử dụng trong quá trình triển khai nó. Gamma là một máy cơ sở dữ liệu quan hệ hiện đang hoạt động trên một siêu khối Intel iPSC/2 với 32 bộ xử lý và 32 ổ đĩa. Gamma sử dụng ba ý tưởng kỹ thuật then chốt cho phép kiến trúc có thể mở rộng đến hàng trăm bộ xử lý. Thứ nhất, tất cả các quan hệ được phân vùng theo chiều ngang trên nhiều ổ đĩa, cho phép quét các quan hệ song song. Thứ hai, các thuật toán song song mới dựa trên băm được sử dụng để triển khai các toán tử quan hệ phức tạp như phép nối và các hàm tổng hợp. Thứ ba, các kỹ thuật lập lịch luồng dữ liệu được sử dụng để phối hợp các truy vấn đa toán tử. Bằng cách sử dụng các kỹ thuật này, có thể kiểm soát việc thực thi các truy vấn rất phức tạp với sự phối hợp tối thiểu - một yêu cầu cần thiết đối với các cấu hình liên quan đến một số lượng rất lớn bộ xử lý.
Ngoài việc mô tả thiết kế của phần mềm Gamma, bài báo cũng trình bày một đánh giá hiệu năng toàn diện của phiên bản Gamma trên siêu khối iPSC/2. Ngoài việc đo lường ảnh hưởng của kích thước quan hệ và các chỉ mục đến thời gian đáp ứng đối với các truy vấn chọn lọc, nối, tổng hợp và cập nhật, chúng tôi cũng phân tích hiệu năng của Gamma so với số lượng bộ xử lý được sử dụng khi kích thước của các quan hệ đầu vào được giữ không đổi (tăng tốc) và khi kích thước của các quan hệ đầu vào được tăng tỷ lệ thuận với số lượng bộ xử lý (mở rộng quy mô). Các kết quả tăng tốc thu được cho cả truy vấn chọn lọc và truy vấn nối là tuyến tính; do đó, việc tăng gấp đôi số lượng bộ xử lý sẽ giảm một nửa thời gian đáp ứng cho một truy vấn. Các kết quả mở rộng quy mô thu được cũng rất đáng khích lệ. Chúng cho thấy rằng có thể duy trì thời gian đáp ứng gần như không đổi đối với cả truy vấn chọn lọc và truy vấn nối khi tải công việc được tăng lên bằng cách bổ sung một số lượng bộ xử lý và đĩa tỷ lệ thuận.
1 Giới thiệu
Trong 5 năm qua, dự án máy cơ sở dữ liệu Gamma đã tập trung vào các vấn đề liên quan đến thiết kế và triển khai các máy cơ sở dữ liệu song song cao. Theo nhiều cách, thiết kế của Gamma dựa trên những điều chúng tôi đã học được từ máy cơ sở dữ liệu trước đây của mình, DIRECT [DEWI79]. Mặc dù DIRECT đã chứng minh rằng tính song song có thể được áp dụng thành công vào việc xử lý các thao tác cơ sở dữ liệu, nó có một số thiếu sót nghiêm trọng trong thiết kế khiến việc mở rộng kiến trúc lên hàng trăm bộ xử lý là không thể; chủ yếu là do việc sử dụng bộ nhớ chia sẻ và điều khiển tập trung cho việc thực thi các thuật toán song song của nó [BITT83].
Như một giải pháp cho các vấn đề gặp phải với DIRECT, Gamma sử dụng những giải pháp ngày nay có vẻ tương đối đơn giản. Về mặt kiến trúc, Gamma dựa trên kiến trúc không chia sẻ (shared-nothing) [STON86] bao gồm một số bộ xử lý được kết nối với nhau bởi một mạng truyền thông như hypercube hoặc vòng, với các đĩa được kết nối trực tiếp tới từng bộ xử lý riêng lẻ. Người ta nhìn chung chấp nhận rằng các kiến trúc như vậy có thể được mở rộng để tích hợp hàng nghìn bộ xử lý. Trên thực tế, các máy cơ sở dữ liệu Teradata [TERA85] sử dụng kiến trúc không chia sẻ với hơn 200 bộ xử lý đã được đưa vào sử dụng. Ý tưởng then chốt thứ hai được Gamma sử dụng là việc dùng các thuật toán song song dựa trên băm. Không giống như các thuật toán được sử dụng bởi DIRECT, các thuật toán này không yêu cầu điều khiển tập trung và do đó, giống như kiến trúc phần cứng, có thể được mở rộng gần như vô hạn. Cuối cùng, để tận dụng tốt nhất băng thông I/O hạn chế do thế hệ ổ đĩa hiện tại cung cấp, Gamma sử dụng khái niệm phân vùng ngang [RIES78] (còn được gọi là phân cụm lại [LIVN87]) để phân phối các bộ của một quan hệ giữa nhiều ổ đĩa. Thiết kế này cho phép các quan hệ lớn được xử lý bởi nhiều bộ xử lý đồng thời mà không phát sinh bất kỳ chi phí phụ trội truyền thông nào.
Sau khi thiết kế phần mềm Gamma được hoàn thành vào mùa thu năm 1984, công việc bắt đầu trên nguyên mẫu đầu tiên, nguyên mẫu này đã hoạt động vào mùa thu năm 1985. Phiên bản Gamma này được triển khai trên nền một hệ thống đa máy tính hiện có bao gồm 20 bộ xử lý VAX 11/750 [DEWI84b]. Trong giai đoạn 1986-1988, nguyên mẫu được cải tiến thông qua việc bổ sung một số toán tử mới (ví dụ: các toán tử tổng hợp và cập nhật), các phương pháp kết nối song song mới (Hybrid, Grace, và Sort-Merge [SCHN89a]), cùng một cơ chế điều khiển đồng thời hoàn chỉnh. Ngoài ra, chúng tôi cũng tiến hành một số nghiên cứu về hiệu năng của hệ thống trong giai đoạn này [DEWI86, DEWI88, GHAN89, GHAN90]. Vào mùa xuân năm 1989, Gamma được chuyển sang một hypercube Intel iPSC/2 gồm 32 bộ xử lý và nguyên mẫu dựa trên VAX được loại bỏ.
Gamma tương tự với một số nỗ lực tích cực khác về máy cơ sở dữ liệu song song. Ngoài Teradata [TERA85], Bubba [COPE88] và Tandem [TAND88] cũng sử dụng kiến trúc không chia sẻ và áp dụng khái niệm phân vùng ngang. Trong khi Teradata và Tandem cũng dựa vào băm để phi tập trung hóa việc thực thi các thuật toán song song của chúng, cả hai hệ thống có xu hướng dựa vào các thuật toán kết nối tương đối truyền thống như sort-merge để xử lý các mảnh của quan hệ tại mỗi vị trí. Gamma, XPRS [STON88], và Volcano [GRAE89] đều sử dụng các phiên bản song song của thuật toán kết nối Hybrid [DEWI84a].
Phần còn lại của bài báo này được tổ chức như sau. Trong Section 2, chúng tôi mô tả phần cứng được sử dụng bởi mỗi nguyên mẫu Gamma và kinh nghiệm của chúng tôi với từng nguyên mẫu. Section 3 thảo luận về tổ chức của phần mềm Gamma và mô tả cách các truy vấn nhiều toán tử được điều khiển. Các thuật toán song song được Gamma sử dụng được mô tả trong Section 4 và các kỹ thuật chúng tôi sử dụng cho quản lý giao dịch và sự cố được trình bày trong Section 5. Section 6 trình bày một nghiên cứu về hiệu năng của nguyên mẫu hypercube Intel gồm 32 bộ xử lý. Các kết luận và hướng nghiên cứu tương lai của chúng tôi được mô tả trong Section 7.
2 Kiến trúc phần cứng của Gamma
2.1. Tổng quan
Gamma dựa trên khái niệm về một kiến trúc không chia sẻ (shared-nothing) [STON86] trong đó các bộ xử lý không chia sẻ các ổ đĩa hoặc bộ nhớ truy cập ngẫu nhiên và chỉ có thể giao tiếp với nhau bằng cách gửi các thông điệp qua một mạng liên kết. Lưu trữ khối lượng lớn trong một kiến trúc như vậy thường được phân tán giữa các bộ xử lý bằng cách kết nối một hoặc nhiều ổ đĩa với mỗi bộ xử lý như được minh họa trong Hình 1. Có một số lý do khiến phương pháp không chia sẻ trở thành kiến trúc được lựa chọn. Thứ nhất, không có gì ngăn cản kiến trúc đạt khả năng mở rộng tới hàng nghìn bộ xử lý, không giống như các máy chia sẻ bộ nhớ mà việc mở rộng vượt quá 30-40 bộ xử lý có thể là không khả thi. Thứ hai, như được chứng minh trong [DEWI88, COPE88, TAND88], bằng cách liên kết một số lượng nhỏ
ổ đĩa Hình 1 với mỗi bộ xử lý và phân phối các bộ của mỗi quan hệ trên các ổ đĩa, có thể đạt được băng thông I/O tổng hợp rất cao mà không sử dụng các bộ điều khiển đĩa tùy chỉnh [KIM86, PATT88]. Hơn nữa, bằng cách sử dụng công nghệ lưu trữ khối lượng lớn có sẵn trên thị trường, người ta có thể sử dụng công nghệ mới nhất trong các ổ đĩa nhỏ 3 1/2" với bộ điều khiển đĩa tích hợp. Một ưu điểm khác của phương pháp không chia sẻ là không còn cần phải tự xây dựng phần cứng. Gần đây, cả Intel và Ncube đã bổ sung lưu trữ khối lượng lớn vào các sản phẩm đa bộ xử lý dựa trên hypercube của họ.
2.2. Phiên bản Gamma 1.0
Phiên bản ban đầu của Gamma bao gồm 17 bộ xử lý VAX 11/750, mỗi bộ có hai megabyte bộ nhớ. Một vòng token 80 megabit/giây [PROT85] được sử dụng để kết nối các bộ xử lý với nhau và với một VAX khác đang chạy Unix. Bộ xử lý này đóng vai trò là máy chủ cho Gamma. Tám trong số các bộ xử lý được gắn các ổ đĩa Fujitsu 333 megabyte được sử dụng để lưu trữ cơ sở dữ liệu. Các bộ xử lý không có đĩa được sử dụng cùng với các bộ xử lý có đĩa để thực thi các toán tử hàm nối và tổng hợp nhằm khảo sát liệu các bộ xử lý không có đĩa có thể được khai thác hiệu quả hay không.
Chúng tôi gặp phải một số vấn đề với nguyên mẫu này. Thứ nhất, vòng token có kích thước gói mạng tối đa là 2K byte. Trong phiên bản đầu tiên của nguyên mẫu, kích thước của một trang đĩa được đặt là 2K byte để có thể truyền một trang đĩa "nguyên vẹn" từ một bộ xử lý sang bộ xử lý khác mà không cần sao chép. Điều này yêu cầu, ví dụ, mỗi trang đĩa cũng phải chứa không gian cho phần đầu giao thức được phần mềm giao tiếp giữa các bộ xử lý sử dụng. Mặc dù ban đầu điều này có vẻ là một ý tưởng tốt, chúng tôi nhanh chóng nhận ra rằng lợi ích của kích thước trang đĩa lớn hơn bù đắp nhiều hơn chi phí phải sao chép các bộ từ một trang đĩa vào một gói mạng.
Vấn đề thứ hai chúng tôi gặp phải là giao diện mạng và Unibus trên 11/750 đều là các nút thắt cổ chai [GERB87, DEWI88]. Mặc dù băng thông của chính vòng token là 80 megabit/giây, Unibus trên 11/750 (nơi giao diện mạng được gắn vào) chỉ có băng thông 4 megabit/giây. Khi thực thi một truy vấn nối mà không có vị từ chọn trên bất kỳ quan hệ đầu vào nào, Unibus trở thành nút thắt cổ chai vì tốc độ truyền các trang từ đĩa cao hơn tốc độ của Unibus [DEWI88]. Giao diện mạng là một nút thắt cổ chai vì nó chỉ có thể đệm hai gói đến tại một thời điểm. Cho đến khi một gói được truyền vào bộ nhớ của VAX, các gói đến khác bị từ chối và phải được giao thức truyền thông truyền lại. Mặc dù cuối cùng chúng tôi đã xây dựng một giao diện tới vòng token được cắm trực tiếp vào bảng nối đa năng của VAX, vào thời điểm bo mạch hoạt động thì các VAX đã lỗi thời và chúng tôi quyết định không chi thêm kinh phí để nâng cấp toàn bộ hệ thống.
Vấn đề nghiêm trọng khác chúng tôi gặp phải với nguyên mẫu này là mỗi bộ xử lý chỉ có 2 megabyte bộ nhớ. Đây đặc biệt là một vấn đề vì hệ điều hành được Gamma sử dụng không cung cấp bộ nhớ ảo. Vấn đề trở nên nghiêm trọng hơn do không gian cho các bảng băm nối, không gian ngăn xếp cho các tiến trình và nhóm bộ đệm được quản lý riêng biệt để tránh xóa các trang nóng khỏi nhóm bộ đệm. Mặc dù việc các không gian này được phần mềm quản lý riêng biệt có những ưu điểm, trong một cấu hình mà bộ nhớ vốn đã hạn chế, việc cân bằng kích thước của ba nhóm bộ nhớ này tỏ ra khó khăn.
2.3. Phiên bản Gamma 2.0
Vào mùa thu năm 1988, chúng tôi thay thế nguyên mẫu dựa trên VAX bằng một hypercube iPSC/2 32 bộ xử lý từ Intel. Mỗi bộ xử lý được cấu hình với một CPU 386, 8 megabyte bộ nhớ và một ổ đĩa MAXTOR 4380 330-megabyte (5 1/4"). Mỗi ổ đĩa có một bộ điều khiển SCSI tích hợp cung cấp một bộ đệm RAM 45 Kbyte đóng vai trò là cache đĩa trong các thao tác đọc.
Các nút trong hypercube được liên kết với nhau để tạo thành một hypercube bằng cách sử dụng các mô-đun định tuyến VLSI tùy chỉnh. Mỗi mô-đun hỗ trợ tám1 kênh giao tiếp song công hoàn toàn, nối tiếp, tin cậy hoạt động ở tốc độ 2.8 megabyte/giây. Các thông điệp nhỏ (<= 100 byte) được gửi dưới dạng datagram. Đối với các thông điệp lớn, phần cứng xây dựng một mạch giao tiếp giữa hai nút, qua đó toàn bộ thông điệp được truyền mà không có chi phí phụ trội của phần mềm hoặc sao chép. Sau khi thông điệp được truyền hoàn toàn, mạch được giải phóng. Độ dài của một thông điệp chỉ bị giới hạn bởi kích thước của bộ nhớ vật lý trên mỗi bộ xử lý. Bảng 1 tóm tắt thời gian truyền từ một tiến trình Gamma tới một tiến trình khác (trên hai nút hypercube khác nhau) đối với nhiều kích thước thông điệp.
| Kích thước gói (tính bằng byte) | Thời gian truyền |
|---|---|
| 50 | 0.74 ms. |
| 500 | 1.46 ms. |
| 1000 | 1.57 ms. |
| 4000 | 2.69 ms. |
| 8000 | 4.64 ms. |
Bảng 1
Việc chuyển đổi phần mềm Gamma sang hypercube bắt đầu vào đầu tháng 12 năm 1988. Vì hầu hết người dùng hypercube Intel có xu hướng chạy một tiến trình duy nhất tại một thời điểm trong khi xử lý dữ liệu số, hệ điều hành do Intel cung cấp chỉ hỗ trợ một số lượng hạn chế các tiến trình nặng. Do đó, chúng tôi bắt đầu quá trình chuyển đổi bằng cách chuyển hệ điều hành của Gamma, NOSE (xem Section 3.5). Để đơn giản hóa việc chuyển đổi, chúng tôi quyết định chạy NOSE như một gói luồng bên trong một tiến trình NX/2 duy nhất nhằm tránh phải chuyển NOSE để chạy trực tiếp trên phần cứng thuần.
Sau khi NOSE được chạy, chúng tôi bắt đầu chuyển đổi phần mềm Gamma. Quá trình này mất 4-6 tháng-người nhưng kéo dài khoảng 6 tháng vì, trong quá trình chuyển đổi, chúng tôi phát hiện rằng giao diện giữa bộ điều khiển đĩa SCSI và bộ nhớ không thể truyền các khối đĩa lớn hơn 1024 byte (cạm bẫy của việc là một địa điểm thử nghiệm beta). Phần lớn việc chuyển đổi phần mềm Gamma gần như là đơn giản vì, bằng cách chuyển NOSE trước, những khác biệt giữa hai hệ thống trong việc khởi tạo truyền đĩa và thông điệp đã hoàn toàn được ẩn khỏi phần mềm Gamma. Khi chuyển mã sang 386, chúng tôi đã phát hiện một số lỗi ẩn trong phiên bản VAX của mã vì VAX không bắt lỗi khi một con trỏ null bị tham chiếu. Vấn đề lớn nhất mà chúng tôi gặp phải là các nút trên máy tính đa xử lý VAX được đánh số bắt đầu từ 1 trong khi hypercube sử dụng 0 làm địa chỉ logic của nút đầu tiên. Mặc dù chúng tôi nghĩ rằng việc thực hiện các thay đổi cần thiết sẽ tẻ nhạt nhưng đơn giản, chúng tôi đã đi được khoảng một nửa quá trình chuyển đổi trước khi nhận ra rằng chúng tôi phải tìm và thay đổi mọi vòng lặp "for" trong hệ thống mà chỉ số vòng lặp cũng được sử dụng làm địa chỉ của máy mà một thông điệp được gửi tới. Mặc dù điều này nghe có vẻ ngớ ngẩn hiện nay, chúng tôi đã mất vài tuần để tìm tất cả các vị trí cần thay đổi. Nhìn lại, chúng tôi nên để NOSE che giấu những khác biệt giữa hai lược đồ địa chỉ.
Tuy nhiên, từ góc nhìn của hệ thống cơ sở dữ liệu, có một số lĩnh vực mà Intel có thể cải thiện thiết kế của iPSC/2. Trước hết, nên cung cấp một cơ chế tiến trình nhẹ như một phương án thay thế cho NX/2. Mặc dù điều này gần như chắc chắn sẽ làm tăng thời gian cần thiết để thực hiện việc chuyển đổi, về lâu dài chúng tôi có thể tránh được việc duy trì NOSE. Một vấn đề nghiêm trọng hơn nhiều với phiên bản hiện tại của hệ thống là bộ điều khiển đĩa không thực hiện các truyền DMA trực tiếp vào bộ nhớ. Thay vào đó, khi một khối được đọc từ đĩa, bộ điều khiển đĩa thực hiện một truyền DMA vào một FIFO 4K byte. Khi FIFO đầy một nửa, CPU bị ngắt và nội dung của FIFO được sao chép vào vị trí thích hợp trong bộ nhớ.1 Mặc dù một lệnh khối được sử dụng cho thao tác sao chép, chúng tôi đã đo được rằng khoảng 10% số chu kỳ CPU khả dụng bị lãng phí để thực hiện thao tác sao chép. Ngoài ra, CPU bị ngắt 13 lần trong quá trình truyền một khối 8 Kbyte, một phần vì sử dụng bộ điều khiển đĩa SCSI và một phần vì FIFO giữa bộ điều khiển đĩa và bộ nhớ.
3 Kiến trúc phần mềm của Gamma
Trong phần này, chúng tôi trình bày tổng quan về kiến trúc phần mềm của Gamma và mô tả các kỹ thuật mà Gamma sử dụng để thực thi các truy vấn theo kiểu luồng dữ liệu. Chúng tôi bắt đầu bằng việc mô tả các cấu trúc lưu trữ thay thế được cung cấp bởi phần mềm Gamma. Tiếp theo, kiến trúc hệ thống tổng thể được mô tả từ trên xuống dưới. Sau khi mô tả cấu trúc tiến trình tổng thể, chúng tôi minh họa hoạt động của hệ thống bằng cách mô tả sự tương tác của
thuộc tính phân vùng.
Khi một truy vấn đang được tối ưu hóa, thông tin phân vùng cho mỗi quan hệ nguồn trong truy vấn được đưa vào kế hoạch truy vấn do bộ tối ưu hóa truy vấn tạo ra. Trong trường hợp các quan hệ được phân vùng theo băm và theo khoảng, thông tin phân vùng này được bộ lập lịch truy vấn (được thảo luận bên dưới) sử dụng để hạn chế số lượng bộ xử lý tham gia vào việc thực thi các truy vấn chọn trên thuộc tính phân vùng. Ví dụ, nếu quan hệ X được phân vùng theo băm trên thuộc tính y, có thể hướng các thao tác chọn với các vị từ có dạng "X.y = Constant" đến một site duy nhất; tránh sự tham gia của bất kỳ site nào khác trong việc thực thi truy vấn. Trong trường hợp các quan hệ được phân vùng theo khoảng, bộ lập lịch truy vấn có thể hạn chế việc thực thi truy vấn chỉ đến những bộ xử lý có khoảng của chúng chồng lấp với khoảng của vị từ chọn (có thể là vị từ bằng hoặc vị từ khoảng).
Nhìn lại, chúng tôi đã mắc một sai lầm nghiêm trọng khi chọn phân cụm phân tán tất cả các quan hệ trên tất cả các nút có đĩa. Một phương pháp tốt hơn nhiều, như được đề xuất trong [COPE88], là sử dụng "độ nóng" của một quan hệ để xác định mức độ mà quan hệ được phân cụm phân tán. Đáng tiếc, việc bổ sung khả năng như vậy vào phần mềm Gamma tại thời điểm này sẽ đòi hỏi một nỗ lực khá lớn - một nỗ lực mà chúng tôi khó có khả năng thực hiện.
3.2. Cấu trúc tiến trình Gamma
Cấu trúc tổng thể của các tiến trình khác nhau tạo thành phần mềm Gamma được thể hiện trong Hình 2. Vai trò của mỗi tiến trình được mô tả ngắn gọn bên dưới. Hoạt động của cơ chế phát hiện và phục hồi bế tắc phân tán được trình bày trong các Mục 5.1 và 5.2. Tại thời điểm khởi tạo hệ thống, một tiến trình daemon UNIX cho Trình quản lý Catalog (CM) được khởi tạo cùng với một tập hợp các Tiến trình Lập lịch, một tập hợp các Tiến trình Toán tử, Tiến trình Phát hiện Bế tắc và Tiến trình Phục hồi.
Trình quản lý Catalog
Chức năng của Trình quản lý Catalog là hoạt động như một kho lưu trữ trung tâm cho tất cả thông tin lược đồ khái niệm và nội bộ của mỗi cơ sở dữ liệu. Thông tin lược đồ được tải vào bộ nhớ khi một cơ sở dữ liệu được mở lần đầu. Vì nhiều người dùng có thể mở cùng một cơ sở dữ liệu đồng thời và vì mỗi người dùng có thể cư trú trên một máy khác với máy mà Trình quản lý Catalog đang thực thi, Trình quản lý Catalog chịu trách nhiệm đảm bảo tính nhất quán giữa các bản sao được cache bởi mỗi người dùng.
Trình quản lý truy vấn
Một tiến trình trình quản lý truy vấn được liên kết với mỗi người dùng Gamma đang hoạt động. Trình quản lý truy vấn chịu trách nhiệm cache thông tin lược đồ cục bộ, cung cấp giao diện cho các truy vấn đặc biệt sử dụng gdl (biến thể của Quel của chúng tôi [STON76]), phân tích cú pháp truy vấn, tối ưu hóa và biên dịch.
Các tiến trình lập lịch
Trong khi thực thi, mỗi truy vấn đa site được điều khiển bởi một tiến trình lập lịch. Tiến trình này chịu trách nhiệm kích hoạt các Tiến trình Toán tử được sử dụng để thực thi các nút của một cây truy vấn đã biên dịch. Các tiến trình lập lịch có thể chạy trên bất kỳ bộ xử lý nào, đảm bảo rằng không có bộ xử lý nào trở thành nút thắt cổ chai. Tuy nhiên, trong thực tế, các tiến trình lập lịch tiêu thụ hầu như không có tài nguyên và có thể chạy một số lượng lớn chúng trên một bộ xử lý duy nhất. Một tiến trình điều phối tập trung được sử dụng để gán các tiến trình lập lịch cho các truy vấn. Những truy vấn mà bộ tối ưu hóa có thể phát hiện là truy vấn một site được gửi trực tiếp đến nút thích hợp để thực thi, bỏ qua tiến trình lập lịch.
Tiến trình toán tử
Đối với mỗi toán tử trong một cây truy vấn, ít nhất một Tiến trình Toán tử được sử dụng tại mỗi bộ xử lý tham gia vào việc thực thi toán tử đó. Các toán tử này được chuẩn bị tại thời điểm khởi tạo hệ thống nhằm tránh chi phí phụ trội của việc khởi động các tiến trình tại thời điểm thực thi truy vấn (các tiến trình bổ sung có thể được fork khi cần). Cấu trúc của một tiến trình toán tử và ánh xạ các toán tử quan hệ tới các tiến trình toán tử được thảo luận chi tiết hơn bên dưới. Khi một bộ lập lịch muốn khởi động một toán tử mới trên một nút, nó gửi một yêu cầu đến một cổng truyền thông đặc biệt được gọi là cổng "new task". Khi một yêu cầu được nhận trên cổng này, một tiến trình toán tử nhàn rỗi được gán cho yêu cầu và cổng truyền thông của tiến trình toán tử này được trả về cho tiến trình lập lịch yêu cầu.
3.3. Tổng quan về thực thi truy vấn
Các giao diện truy vấn đặc biệt và truy vấn nhúng
Hai giao diện cho Gamma có sẵn: một ngôn ngữ truy vấn đặc biệt và một giao diện ngôn ngữ truy vấn nhúng trong đó các truy vấn có thể được nhúng vào một chương trình C. Khi người dùng gọi giao diện truy vấn đặc biệt, một tiến trình Trình quản lý truy vấn (QM) được khởi động và ngay lập tức kết nối với tiến trình CM thông qua cơ chế socket Internet UNIX. Khi giao diện truy vấn đã biên dịch được sử dụng, bộ tiền xử lý dịch mỗi truy vấn nhúng thành một kế hoạch truy vấn đã biên dịch được chương trình gọi tại thời gian chạy. Một cơ chế truyền các tham số từ chương trình C đến các kế hoạch truy vấn đã biên dịch tại thời gian chạy cũng được cung cấp.
Thực thi truy vấn
Gamma sử dụng các kỹ thuật quan hệ truyền thống cho việc phân tích cú pháp truy vấn, tối ưu hóa [SELI79, JARK84], và sinh mã. Quá trình tối ưu hóa được đơn giản hóa phần nào vì Gamma chỉ sử dụng các thuật toán dựa trên băm cho các phép nối và các phép toán phức tạp khác. Các truy vấn được biên dịch thành một cây toán tử sâu trái. Tại thời điểm thực thi, mỗi toán tử được thực thi bởi một hoặc nhiều tiến trình toán tử tại mỗi site tham gia.
Khi thiết kế bộ tối ưu hóa cho phiên bản VAX của Gamma, tập các kế hoạch truy vấn khả dĩ được bộ tối ưu hóa xem xét bị giới hạn chỉ còn các cây sâu trái vì chúng tôi cho rằng không có đủ bộ nhớ để hỗ trợ các kế hoạch sâu phải hoặc dạng bụi rậm. Bằng cách sử dụng kết hợp các cây truy vấn sâu trái và các thuật toán nối dựa trên băm, chúng tôi có thể đảm bảo rằng không quá hai phép toán nối từng hoạt động đồng thời và do đó có thể tối đa hóa lượng bộ nhớ vật lý có thể được cấp phát cho mỗi toán tử nối. Vì giới hạn bộ nhớ này thực sự chỉ là một đặc tính của nguyên mẫu VAX, gần đây chúng tôi đã bắt đầu khảo sát các ảnh hưởng về hiệu năng của các kế hoạch truy vấn sâu phải và dạng bụi rậm [SCHN89b].
Như đã thảo luận trong Section 3.1, trong quá trình tối ưu hóa một truy vấn, bộ tối ưu hóa truy vấn nhận biết rằng một số truy vấn nhất định chỉ có thể được hướng tới một tập con các nút trong hệ thống. Trong trường hợp truy vấn một site, truy vấn được QM gửi trực tiếp đến bộ xử lý thích hợp để thực thi. Trong trường hợp truy vấn nhiều site, bộ tối ưu hóa thiết lập một kết nối tới một tiến trình scheduler nhàn rỗi thông qua một tiến trình dispatcher tập trung. Tiến trình dispatcher, bằng cách kiểm soát số lượng scheduler đang hoạt động, triển khai một cơ chế kiểm soát tải đơn giản. Khi đã thiết lập kết nối với một tiến trình scheduler, QM gửi truy vấn đã biên dịch đến tiến trình scheduler và chờ truy vấn hoàn thành thực thi. Tiến trình scheduler, lần lượt, kích hoạt các tiến trình toán tử tại mỗi bộ xử lý truy vấn được chọn để thực thi toán tử. Cuối cùng, QM đọc các kết quả của truy vấn và trả chúng thông qua giao diện truy vấn ad-hoc cho người dùng hoặc thông qua giao diện truy vấn nhúng tới chương trình từ đó truy vấn được khởi tạo.
3.4. Cấu trúc Toán tử và Tiến trình
Các thuật toán cho tất cả các toán tử quan hệ được viết như thể chúng sẽ được chạy trên một bộ xử lý duy nhất. Như được trình bày trong Figure 3, đầu vào của một Tiến trình Toán tử là một luồng các tuple và đầu ra là một luồng các tuple được phân kênh thông qua một cấu trúc mà chúng tôi gọi là bảng phân tách. Khi tiến trình bắt đầu thực thi, nó liên tục đọc các tuple từ luồng đầu vào, xử lý từng tuple, và sử dụng một bảng phân tách để định tuyến tuple kết quả tới tiến trình được chỉ ra trong bảng phân tách.1 Khi tiến trình phát hiện kết thúc luồng đầu vào, trước tiên nó đóng các luồng đầu ra rồi gửi một thông điệp điều khiển tới tiến trình scheduler của nó cho biết rằng nó đã hoàn thành thực thi. Việc đóng các luồng đầu ra có tác dụng phụ là gửi các thông điệp "end of stream" tới từng tiến trình đích.
Figure 3
Bảng phân tách định nghĩa một ánh xạ các giá trị tới một tập các tiến trình đích. Gamma sử dụng ba kiểu bảng phân tách khác nhau tùy thuộc vào kiểu thao tác đang được thực hiện [DEWI86]. Là một ví dụ về một dạng bảng phân tách, hãy xem xét việc sử dụng bảng phân tách được trình bày trong Figure 4 kết hợp với việc thực thi một phép nối sử dụng 4 bộ xử lý. Mỗi tiến trình tạo ra các tuple cho phép nối sẽ áp dụng một hàm băm cho thuộc tính nối của mỗi tuple đầu ra để tạo ra một giá trị trong khoảng từ 0 đến 3. Giá trị này sau đó được sử dụng làm chỉ mục vào bảng phân tách để lấy địa chỉ của tiến trình đích sẽ nhận tuple.
| Giá trị | Tiến trình Đích |
|---|---|
| 0 | (Processor #3, Port #5) |
| 1 | (Processor #2, Port #13) |
| 2 | (Processor #7, Port #6) |
| 3 | (Processor #9, Port #15) |
Một Ví dụ về Bảng Phân Tách Figure 4
Một Ví dụ
Là một ví dụ về cách các truy vấn được thực thi, hãy xem xét truy vấn được trình bày trong Figure 5. Trong Figure 6, các tiến trình được sử dụng để thực thi truy vấn được trình bày cùng với luồng dữ liệu giữa các tiến trình khác nhau cho một cấu hình Gamma bao gồm hai bộ xử lý có đĩa và hai bộ xử lý không có đĩa. Vì hai quan hệ đầu vào A và B được phân vùng trên các đĩa gắn với các bộ xử lý P1 và P2, các toán tử chọn và quét được khởi tạo trên cả hai bộ xử lý P1 và P2. Các bảng phân tách cho cả toán tử chọn và quét đều chứa hai mục nhập vì hai bộ xử lý đang được sử dụng cho thao tác nối. Các bảng phân tách cho mỗi phép chọn và quét là giống hệt nhau - định tuyến các tuple có giá trị thuộc tính nối băm thành 0 (các đường nét đứt) tới P3 và các tuple có giá trị băm thành 1 (các đường liền) tới P4. Toán tử nối thực thi theo hai giai đoạn. Trong giai đoạn đầu tiên, được gọi là giai đoạn Building, các tuple từ quan hệ bên trong (A trong ví dụ này) được chèn vào một bảng băm nằm trong bộ nhớ bằng cách băm trên giá trị thuộc tính nối. Sau khi giai đoạn đầu tiên hoàn thành, giai đoạn probing của phép nối được khởi tạo, trong đó các tuple từ quan hệ bên ngoài được sử dụng để thăm dò bảng băm nhằm tìm các tuple khớp.1 Vì quan hệ kết quả được phân vùng trên hai đĩa, bảng phân tách cho mỗi toán tử nối chứa hai mục nhập và các tuple của C được phân phối theo cách round-robin giữa P1 và P2.
Figure 5
Figure 6
Một trong những vấn đề chính với nguyên mẫu DIRECT là mỗi trang dữ liệu được xử lý đều yêu cầu ít nhất một thông điệp điều khiển đến một bộ lập lịch tập trung. Trong Gamma, nút thắt này hoàn toàn được tránh. Trên thực tế, số lượng thông điệp điều khiển cần thiết để thực thi một truy vấn xấp xỉ bằng ba lần số lượng toán tử trong truy vấn nhân với số lượng bộ xử lý được sử dụng để thực thi mỗi toán tử. Ví dụ, hãy xem Hình 7, trong đó mô tả luồng điều khiển của các thông điệp điều khiển1 từ một tiến trình bộ lập lịch đến các tiến trình trên các bộ xử lý P1 và P3 trong Hình 6 (một tập thông điệp giống hệt sẽ được truyền từ bộ lập lịch đến P2 và P4). Bộ lập lịch bắt đầu bằng cách khởi tạo giai đoạn xây dựng của phép nối và toán tử chọn trên quan hệ A. Khi cả hai toán tử này hoàn thành, bộ lập lịch tiếp theo khởi tạo toán tử lưu trữ, giai đoạn thăm dò của phép nối và việc quét quan hệ B. Khi mỗi toán tử này hoàn thành, một thông điệp kết quả được trả về cho người dùng.
Hình 7
3.5. Hệ điều hành và Hệ thống lưu trữ
Gamma được xây dựng trên một hệ điều hành được thiết kế đặc biệt để hỗ trợ các hệ quản trị cơ sở dữ liệu. NOSE cung cấp nhiều tiến trình nhẹ với bộ nhớ dùng chung. Một chính sách lập lịch không chiếm quyền được sử dụng để giúp ngăn chặn các đoàn xe [BLAS79] xảy ra. NOSE cung cấp giao tiếp giữa các tiến trình NOSE bằng cách sử dụng phần cứng truyền thông điệp đáng tin cậy của siêu khối Intel iPSC/2. Các dịch vụ file trong NOSE dựa trên Wisconsin Storage System (WiSS) [CHOU85]. Các phần tới hạn của WiSS được bảo vệ bằng cơ chế semaphore do NOSE cung cấp.
Các dịch vụ file do WiSS cung cấp bao gồm các file tuần tự có cấu trúc, các file luồng byte như trong UNIX, các chỉ mục B+, các mục dữ liệu dài, một tiện ích sắp xếp và một cơ chế quét. Một file tuần tự là một chuỗi các bản ghi. Các bản ghi có thể thay đổi về độ dài (lên đến một trang), và có thể được chèn và xóa tại các vị trí tùy ý trong một file tuần tự. Tùy chọn, mỗi file có thể có một hoặc nhiều chỉ mục liên kết, ánh xạ các giá trị khóa tới các định danh bản ghi của các bản ghi trong file chứa giá trị khớp. Một thuộc tính được lập chỉ mục có thể được chỉ định làm thuộc tính phân cụm cho file. Cơ chế quét tương tự như cơ chế được System R’s RSS [ASTR76] cung cấp, ngoại trừ việc các vị từ được trình tối ưu hóa truy vấn biên dịch thành ngôn ngữ máy 386 để tối đa hóa hiệu năng.
4 Các thuật toán xử lý truy vấn
4.1. Toán tử Selection
Vì tất cả các quan hệ đều được giải cụm trên nhiều ổ đĩa, việc song song hóa thao tác selection chỉ đơn giản là khởi tạo một toán tử selection trên tập các nút liên quan có đĩa. Khi vị từ trong mệnh đề selection nằm trên thuộc tính phân vùng của quan hệ và quan hệ được phân vùng bằng hash hoặc theo khoảng, bộ lập lịch có thể điều hướng toán tử selection đến một tập con các nút. Nếu quan hệ được phân vùng round-robin hoặc vị từ selection không nằm trên thuộc tính phân vùng, một toán tử selection phải được khởi tạo trên tất cả các nút mà quan hệ được giải cụm. Để cải thiện hiệu năng, Gamma sử dụng một cơ chế đọc trước một trang khi quét các trang của một file theo tuần tự hoặc thông qua một chỉ mục phân cụm. Cơ chế này cho phép việc xử lý một trang được chồng lấp với thao tác I/O của trang tiếp theo.
4.2. Toán tử Join
Các thuật toán join đa bộ xử lý do Gamma cung cấp dựa trên khái niệm phân vùng hai quan hệ cần được join thành các tập con rời nhau gọi là buckets [GOOD81, KITS83, BRAT84]. bằng cách áp dụng một hàm hash lên thuộc tính join của mỗi bộ. Các bucket đã được phân vùng biểu diễn các tập con rời nhau của các quan hệ ban đầu và có đặc tính quan trọng là tất cả các bộ có cùng giá trị thuộc tính join đều nằm trong cùng một bucket. Chúng tôi đã triển khai các phiên bản song song của bốn thuật toán join trên nguyên mẫu Gamma: sort-merge, Grace [KITS83], Simple [DEWI84], và Hybrid [DEWI84]. Mặc dù cả bốn thuật toán đều sử dụng khái niệm phân vùng dựa trên hash này, phép tính join thực tế phụ thuộc vào thuật toán. Thuật toán join hybrid song song được mô tả trong phần tiếp theo. Thông tin bổ sung về cả bốn thuật toán song song và hiệu năng tương đối của chúng có thể được tìm thấy trong [SCHN89a]. Vì nghiên cứu này cho thấy Hybrid hash join gần như luôn cung cấp hiệu năng tốt nhất, nó hiện là thuật toán mặc định trong Gamma và được mô tả chi tiết hơn trong phần tiếp theo. Vì các thuật toán join dựa trên hash này không thể được sử dụng để thực thi các thao tác non-equijoin, các thao tác như vậy hiện chưa được hỗ trợ. Để khắc phục tình trạng này, chúng tôi đang trong quá trình thiết kế một thuật toán non-equijoin song song cho Gamma.
Hybrid Hash-Join
Một thuật toán Hybrid hash-join tập trung [DEWI84] hoạt động trong ba giai đoạn. Trong giai đoạn đầu tiên, thuật toán sử dụng một hàm hash để phân vùng quan hệ bên trong (nhỏ hơn), R, thành N bucket. Các bộ của bucket đầu tiên được sử dụng để xây dựng một bảng hash trong bộ nhớ trong khi N-1 bucket còn lại được lưu trong các file tạm thời. Một hàm hash tốt tạo ra vừa đủ số lượng bucket để đảm bảo rằng mỗi bucket các bộ sẽ đủ nhỏ để hoàn toàn vừa với bộ nhớ chính. Trong giai đoạn thứ hai, quan hệ S được phân vùng bằng cách sử dụng hàm hash từ bước 1. Một lần nữa, N-1 bucket cuối cùng được lưu trong các file tạm thời trong khi các bộ trong bucket đầu tiên được sử dụng để ngay lập tức dò tìm bảng hash trong bộ nhớ được xây dựng trong giai đoạn đầu tiên. Trong giai đoạn thứ ba, thuật toán join các bucket còn lại từ quan hệ với các bucket tương ứng của chúng từ quan hệ . Do đó, phép join được chia thành một chuỗi các phép join nhỏ hơn; mỗi phép trong số đó hy vọng có thể được tính toán mà không gặp phải tràn join. Kích thước của quan hệ nhỏ hơn xác định số lượng bucket; phép tính này độc lập với kích thước của quan hệ lớn hơn.
Phiên bản song song của thuật toán Hybrid hash join của chúng tôi tương tự như thuật toán tập trung được mô tả ở trên. Một bảng tách phân vùng trước tiên tách các quan hệ join thành bucket logic. Số lượng bucket được chọn sao cho các bộ tương ứng với mỗi bucket logic sẽ vừa trong bộ nhớ tổng hợp của các bộ xử lý join. Các bucket được dành cho việc lưu trữ tạm thời trên đĩa đều được phân vùng trên tất cả các vị trí đĩa khả dụng. Tương tự, một bảng tách join sẽ được sử dụng để định tuyến các bộ đến bộ xử lý join tương ứng của chúng (các bộ xử lý này không nhất thiết có đĩa gắn kèm), do đó song song hóa giai đoạn join. Hơn nữa, việc phân vùng quan hệ bên trong, , thành các bucket được chồng lấp với việc chèn các bộ từ bucket đầu tiên của vào các bảng hash cư trú trong bộ nhớ tại mỗi nút join. Ngoài ra, việc phân vùng quan hệ bên ngoài, , thành các bucket được chồng lấp với việc join bucket đầu tiên của với bucket đầu tiên của . Điều này yêu cầu bảng tách phân vùng cho và được tăng cường bằng bảng tách join vì các bộ trong bucket đầu tiên phải được gửi đến những bộ xử lý được sử dụng để thực hiện phép join. Tất nhiên, khi các bucket còn lại được join, chỉ cần bảng tách join. Figure 8 mô tả quan hệ được phân vùng thành bucket trên vị trí đĩa trong đó bucket đầu tiên được join trên bộ xử lý ( có thể nhỏ hơn, bằng, hoặc lớn hơn ).
4.3. Các thao tác Aggregate
Gamma triển khai các aggregate vô hướng bằng cách cho mỗi bộ xử lý tính toán phần kết quả của nó song song. Các kết quả từng phần sau đó được gửi đến một process duy nhất, process này kết hợp các kết quả từng phần này thành đáp án cuối cùng. Các hàm aggregate được tính toán theo hai bước. Đầu tiên, mỗi bộ xử lý tính toán một phần của kết quả bằng cách tính một giá trị cho từng phân vùng. Tiếp theo, các bộ xử lý phân phối lại các kết quả từng phần bằng cách băm trên thuộc tính "group by". Kết quả của bước này là thu thập các kết quả từng phần cho mỗi phân vùng tại một vị trí duy nhất để có thể tính toán kết quả cuối cùng cho mỗi phân vùng.
4.4. Các toán tử cập nhật
Phần lớn, các toán tử cập nhật (thay thế, xóa và thêm vào) được triển khai bằng cách sử dụng các kỹ thuật chuẩn. Ngoại lệ duy nhất xảy ra khi một toán tử thay thế sửa đổi thuộc tính phân vùng của một bộ. Trong trường hợp này, thay vì ghi bộ đã sửa đổi trở lại vào phân mảnh cục bộ của quan hệ, bộ đã sửa đổi được truyền qua một bảng phân tách để xác định site nào nên chứa bộ đó.
5 Quản lý giao dịch và sự cố
Trong phần này chúng tôi mô tả các cơ chế mà Gamma sử dụng cho việc quản lý giao dịch và sự cố. Trong khi các cơ chế khóa đã hoàn toàn hoạt động, hệ thống phục hồi hiện đang được triển khai. Chúng tôi dự kiến bắt đầu triển khai cơ chế quản lý sự cố vào đầu năm 1990.
5.1. Kiểm soát đồng thời trong Gamma
Kiểm soát đồng thời trong Gamma dựa trên khóa hai pha [GRAY78]. Hiện tại, hai mức chi tiết của khóa, file và page, cùng năm chế độ khóa, S, X, IS, IX và SIX được cung cấp. Mỗi site trong Gamma có bộ quản lý khóa cục bộ và bộ phát hiện bế tắc riêng. Bộ quản lý khóa duy trì một bảng khóa và một đồ thị chờ-để-giao dịch. Chi phí thiết lập một khóa thay đổi từ khoảng 100 lệnh, nếu không có xung đột, đến 250 lệnh nếu yêu cầu khóa xung đột với nhóm đã được cấp quyền. Trong trường hợp này, đồ thị chờ-để phải được kiểm tra bế tắc và giao dịch yêu cầu khóa phải được tạm dừng thông qua cơ chế semaphore.
Để phát hiện các bế tắc đa site, Gamma sử dụng một thuật toán phát hiện bế tắc tập trung. Định kỳ, bộ phát hiện bế tắc tập trung gửi một thông điệp đến mỗi nút trong cấu hình, yêu cầu đồ thị chờ-để-giao dịch cục bộ của nút đó. Ban đầu, khoảng thời gian chạy bộ phát hiện bế tắc tập trung được đặt là một giây. Mỗi lần bộ phát hiện bế tắc không tìm thấy một bế tắc toàn cục, khoảng thời gian này được nhân đôi và mỗi lần phát hiện thấy một bế tắc thì giá trị hiện tại của khoảng thời gian được chia đôi. Cận trên của khoảng thời gian được giới hạn ở 60 giây và cận dưới là 1 giây. Sau khi thu thập đồ thị chờ-để từ mỗi site, bộ phát hiện bế tắc tập trung tạo ra một đồ thị chờ-để-giao dịch toàn cục. Bất cứ khi nào một chu trình được phát hiện trong đồ thị chờ-để toàn cục, bộ quản lý bế tắc tập trung chọn hủy giao dịch đang giữ số lượng khóa ít nhất.
5.2. Kiến trúc phục hồi và Bộ quản lý nhật ký
Các thuật toán hiện đang được triển khai để phối hợp xác nhận, hủy bỏ và quay lui giao dịch hoạt động như sau. Khi một tiến trình toán tử cập nhật một bản ghi, nó cũng tạo ra một bản ghi nhật ký ghi lại sự thay đổi của trạng thái cơ sở dữ liệu. Liên kết với mỗi bản ghi nhật ký là một số thứ tự nhật ký (LSN), được tạo thành từ một số nút và một số thứ tự cục bộ. Số nút được xác định tĩnh tại thời điểm cấu hình hệ thống, trong khi số thứ tự cục bộ, được gọi là current LSN, là một giá trị tăng đơn điệu.
Các bản ghi nhật ký được gửi bởi các bộ xử lý truy vấn đến một hoặc nhiều Bộ quản lý nhật ký (mỗi bộ chạy trên một bộ xử lý riêng), các bộ này hợp nhất các bản ghi nhật ký nhận được để tạo thành một luồng nhật ký duy nhất. Nếu M là số lượng bộ xử lý nhật ký đang được sử dụng, bộ xử lý truy vấn i sẽ chuyển các bản ghi nhật ký của nó đến bộ xử lý nhật ký (i mod M) [AGRA85]. Vì thuật toán này chọn bộ xử lý nhật ký một cách tĩnh và một bộ xử lý truy vấn luôn gửi các bản ghi nhật ký của nó đến cùng một bộ xử lý nhật ký, tiến trình phục hồi tại một nút xử lý truy vấn có thể dễ dàng xác định nơi yêu cầu các bản ghi nhật ký để xử lý việc hủy bỏ một giao dịch.
Khi một page của các bản ghi nhật ký đầy, nó được ghi xuống disk. Bộ quản lý nhật ký duy trì một bảng, được gọi là Flushed Log Table, chứa, đối với mỗi nút, LSN của bản ghi nhật ký cuối cùng từ nút đó đã được ghi xuống disk. Các giá trị này được trả về các nút theo yêu cầu hoặc khi chúng có thể được ghép kèm trong một thông điệp khác. Các nút xử lý truy vấn lưu thông tin này trong một biến cục bộ, được gọi là Flushed LSN.
Các bộ quản lý bộ đệm tại các nút xử lý truy vấn tuân theo giao thức WAL [GRAY78]. Khi một page bẩn cần được ép ghi xuống disk, bộ quản lý bộ đệm trước tiên so sánh LSN của page với giá trị cục bộ của Flushed LSN. Nếu LSN của page của một page nhỏ hơn hoặc bằng Flushed LSN, page đó có thể được ghi an toàn xuống disk. Ngược lại, hoặc một page bẩn khác phải được chọn, hoặc một thông điệp phải được gửi đến Bộ quản lý nhật ký để xóa các bản ghi nhật ký tương ứng của page bẩn. Chỉ sau khi Bộ quản lý nhật ký xác nhận rằng bản ghi nhật ký đã được ghi vào disk nhật ký thì page dữ liệu bẩn mới được ghi trở lại disk. Để giảm thời gian chờ phản hồi từ Bộ quản lý nhật ký, bộ quản lý bộ đệm luôn giữ sẵn T (một ngưỡng được chọn trước) page bộ đệm sạch và không cố định. Khi bộ quản lý bộ đệm nhận thấy số lượng page bộ đệm sạch, không cố định đã giảm xuống dưới T, một tiến trình, được gọi là local log manager, được kích hoạt. Tiến trình này gửi một thông điệp đến Bộ quản lý nhật ký để xóa một hoặc nhiều bản ghi nhật ký sao cho số lượng page sạch và không cố định cộng với số lượng page bẩn có thể được ghi an toàn xuống disk lớn hơn T.
Tiến trình bộ lập lịch cho một truy vấn chịu trách nhiệm gửi các bản ghi xác nhận hoặc hủy bỏ đến các Bộ quản lý nhật ký thích hợp. Nếu một giao dịch hoàn thành thành công, một bản ghi xác nhận cho giao dịch đó được tạo bởi bộ lập lịch của nó và được gửi đến mỗi Bộ quản lý nhật ký liên quan, sử dụng một giao thức xác nhận nhóm. Mặt khác, nếu một giao dịch bị hủy bỏ bởi hệ thống hoặc người dùng, bộ lập lịch của nó sẽ gửi một thông điệp hủy bỏ đến tất cả các bộ xử lý truy vấn đã tham gia vào việc thực thi của nó. Tiến trình phục hồi tại mỗi nút tham gia phản hồi bằng cách yêu cầu các bản ghi nhật ký được tạo bởi nút đó từ Bộ quản lý nhật ký của nó (LSN của mỗi bản ghi nhật ký chứa số nút khởi tạo). Khi các bản ghi nhật ký được nhận, tiến trình phục hồi hoàn tác các bản ghi nhật ký theo thứ tự thời gian ngược bằng cách sử dụng thuật toán undo ARIES [MOHA89]. Các thuật toán ARIES cũng được sử dụng làm cơ sở cho việc tạo điểm kiểm tra và phục hồi khởi động lại.
5.3. Quản lý sự cố
Để giúp đảm bảo tính sẵn sàng của hệ thống trong trường hợp xảy ra sự cố với bộ xử lý và/hoặc đĩa, Gamma sử dụng một kỹ thuật sẵn sàng mới được gọi là phân mảnh theo chuỗi [HSIA90]. Giống như cơ chế đĩa nhân bản của Tandem [BORR81] và cơ chế phân mảnh xen kẽ của Teradata [TERA85, COPE89], phân mảnh theo chuỗi duy trì cả bản sao chính và bản sao dự phòng của mỗi quan hệ. Cả ba hệ thống đều có thể chịu được sự cố của một bộ xử lý hoặc đĩa đơn lẻ mà không chịu bất kỳ sự mất mát nào về tính sẵn sàng của dữ liệu. Trong [HSIA90], chúng tôi chỉ ra rằng phân mảnh theo chuỗi cung cấp mức độ sẵn sàng cao hơn so với phân mảnh xen kẽ và, trong trường hợp xảy ra sự cố với bộ xử lý hoặc đĩa, phân phối tải công việc của nút bị hỏng tốt hơn. Cơ chế đĩa nhân bản, mặc dù cung cấp mức độ sẵn sàng cao nhất, lại phân phối tải của một bộ xử lý bị hỏng rất kém.
Bố trí dữ liệu với phân mảnh theo chuỗi
Với phân mảnh theo chuỗi, các nút (một bộ xử lý với một hoặc nhiều đĩa) được chia thành các nhóm rời nhau gọi là các cụm-quan hệ và các bộ của mỗi quan hệ được phân mảnh giữa các ổ đĩa tạo thành một trong các cụm quan hệ. Hai bản sao vật lý của mỗi quan hệ, được gọi là bản sao chính và bản sao dự phòng, được duy trì. Ví dụ, xét Figure 9 trong đó M, số lượng đĩa trong cụm quan hệ, bằng 8. Các bộ trong bản sao chính của quan hệ R được phân mảnh bằng một trong ba chiến lược phân vùng của Gamma, với các bộ trong mảnh chính thứ i (được ký hiệu là Ri) được lưu trữ trên ổ đĩa thứ {i mod M}. Bản sao dự phòng được phân mảnh bằng cùng một chiến lược phân vùng nhưng mảnh dự phòng thứ i (được ký hiệu là ri) được lưu trữ trên đĩa thứ {(i + 1) mod M}. Chúng tôi gọi phương pháp sao chép dữ liệu này là phân mảnh theo chuỗi vì các đĩa được liên kết với nhau bởi các mảnh của một quan hệ, giống như một chuỗi.
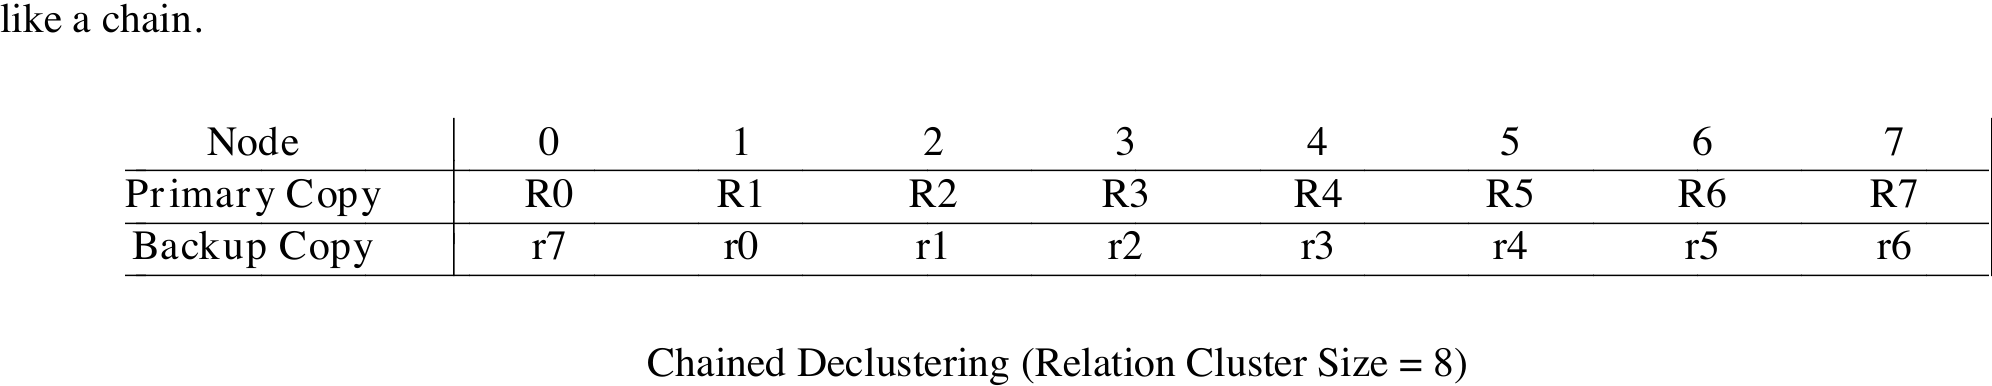
Sự khác biệt giữa cơ chế phân mảnh theo chuỗi và phân mảnh xen kẽ [TERA85, COPE89] được minh họa bởi Figure 10. Trong Figure 10, các mảnh từ bản sao chính của R được phân mảnh trên toàn bộ 8 ổ đĩa bằng cách băm trên một thuộc tính "key". Với cơ chế phân mảnh xen kẽ, tập hợp các đĩa được chia thành các đơn vị có kích thước N gọi là các cụm. Như được minh họa trong Figure 10, trong đó N=4, mỗi mảnh dự phòng được chia nhỏ thành N-1 mảnh con và mỗi mảnh con được đặt trên một đĩa khác nhau trong cùng một cụm, khác với đĩa chứa mảnh chính.
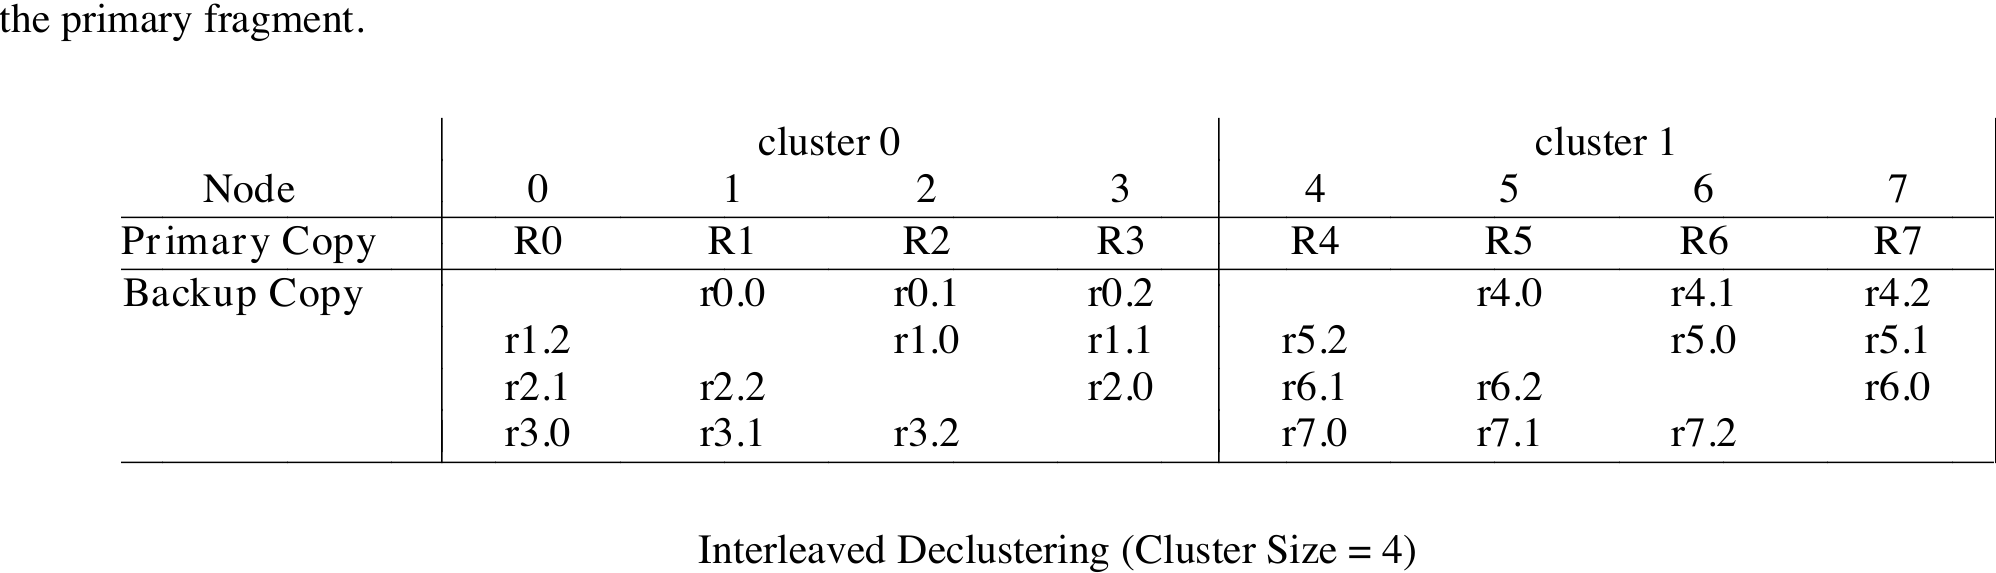
Vì cả phân mảnh xen kẽ và phân mảnh theo chuỗi đều có thể chịu được sự cố của một đĩa hoặc bộ xử lý đơn lẻ, vậy sự khác biệt giữa hai cơ chế này là gì? Trong trường hợp sự cố của một nút đơn lẻ (bộ xử lý hoặc đĩa), cả hai chiến lược phân mảnh theo chuỗi và phân mảnh xen kẽ đều có khả năng phân phối đồng đều tải công việc của cụm giữa các nút hoạt động còn lại. Ví dụ, với kích thước cụm là 8, khi một bộ xử lý hoặc đĩa gặp sự cố, tải trên mỗi nút còn lại sẽ tăng thêm 1/7th. Khi đó có thể kết luận rằng kích thước cụm nên được làm lớn nhất có thể; cho đến khi, tất nhiên, chi phí phụ trội của tính song song bắt đầu lấn át các lợi ích thu được. Mặc dù điều này đúng đối với phân mảnh theo chuỗi, tính sẵn sàng của chiến lược xen kẽ tỷ lệ nghịch với kích thước cụm, vì sự cố của bất kỳ hai bộ xử lý hoặc đĩa nào sẽ làm cho dữ liệu không thể truy cập được. Do đó, việc tăng gấp đôi kích thước cụm để giảm một nửa (xấp xỉ) mức tăng tải trên các nút còn lại khi xảy ra sự cố có tác dụng phụ (rất tiêu cực) là làm tăng gấp đôi xác suất dữ liệu thực sự không sẵn sàng. Vì lý do này, Teradata khuyến nghị kích thước cụm là 4 hoặc 8 bộ xử lý.
Figure 11 minh họa cách tải công việc được cân bằng trong trường hợp xảy ra sự cố nút (nút 1 trong ví dụ này) với cơ chế phân mảnh theo chuỗi. Trong chế độ hoạt động bình thường, các yêu cầu đọc được chuyển đến các mảnh của bản sao chính và các thao tác ghi cập nhật cả hai bản sao. Khi xảy ra sự cố, các phần của cả mảnh chính và mảnh dự phòng được sử dụng cho các thao tác đọc. Ví dụ, với sự cố của nút 1, mảnh chính R1 không còn có thể được truy cập và do đó mảnh dự phòng r1 trên nút 2 phải được sử dụng để xử lý các truy vấn vốn thường được chuyển đến R1. Tuy nhiên, thay vì yêu cầu nút 2 xử lý tất cả các truy cập đến cả R2 và r1, phân mảnh theo chuỗi giảm tải 6/7-ths số truy cập đến R2 bằng cách chuyển hướng chúng đến r2 trên nút 3. Ngược lại, 5/7-ths số truy cập đến R3 trên nút 3 được gửi đến R4 thay thế. Việc gán lại tải công việc động này dẫn đến mức tăng 1/7-th trong tải công việc của mỗi nút còn lại trong cụm. Vì kích thước cụm quan hệ có thể được tăng lên mà không bị phạt, có thể làm cho mức tăng tải này nhỏ đến mức mong muốn.
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | |
|---|---|---|---|---|---|---|---|---|
| Bản sao chính | R0 | --- | R2 | R3 | R4 | R5 | R6 | R7 |
| Bản sao dự phòng | r7 | --- | r1 | r2 | r3 | r4 | r5 | r6 |
Sử dụng mảnh với phân mảnh theo chuỗi Sau sự cố của nút 1 (Kích thước cụm quan hệ = 8) Figure 11
Điều làm cho lược đồ này hấp dẫn hơn nữa là việc gán lại các mảnh đang hoạt động không phát sinh I/O đĩa cũng như di chuyển dữ liệu. Chỉ một số giá trị cận và con trỏ/chỉ mục trong một bảng điều khiển nằm trong bộ nhớ cần được thay đổi, và các sửa đổi này có thể được thực hiện rất nhanh chóng và hiệu quả.
Ví dụ được trình bày trong Hình 11 cung cấp một cái nhìn rất đơn giản hóa về cách cơ chế phân cụm phân mảnh theo chuỗi thực sự cân bằng tải công việc trong trường hợp một nút gặp sự cố. Trong thực tế, các truy vấn không thể chỉ đơn giản truy cập một phần tùy ý của một mảnh dữ liệu, đặc biệt khi xét đến sự đa dạng của các cơ chế phân vùng và chỉ mục được cung cấp bởi phần mềm Gamma. Trong [HSIA90], chúng tôi mô tả cách tất cả các tổ hợp của các kiểu truy vấn, phương thức truy cập và phân vùng
6 Các nghiên cứu về hiệu năng
6.1. Giới thiệu và Tổng quan về Thí nghiệm
Để đánh giá hiệu năng của phiên bản siêu khối của Gamma, ba độ đo khác nhau đã được sử dụng. Trước tiên, tập các truy vấn phép đo chuẩn Wisconsin [BITT83] được chạy trên một cấu hình gồm 30 bộ xử lý với ba kích thước khác nhau của các quan hệ: 100,000, 1 triệu, và 10 triệu bộ. Trong khi hiệu năng tuyệt đối là một độ đo của một hệ thống cơ sở dữ liệu, tăng tốc và mở rộng quy mô cũng là các độ đo hữu ích cho các máy cơ sở dữ liệu đa bộ xử lý [ENGL89]. Tăng tốc là một độ đo thú vị vì nó chỉ ra liệu các bộ xử lý và ổ đĩa bổ sung có dẫn đến sự giảm tương ứng trong thời gian đáp ứng của một truy vấn hay không. Đối với một tập con các truy vấn phép đo chuẩn Wisconsin, chúng tôi đã tiến hành các thí nghiệm tăng tốc bằng cách thay đổi số lượng bộ xử lý từ 1 đến 30 trong khi kích thước của các quan hệ kiểm tra được cố định ở 1 triệu bộ. Với cùng tập truy vấn đó, chúng tôi cũng tiến hành các thí nghiệm mở rộng quy mô bằng cách thay đổi số lượng bộ xử lý từ 5 đến 30 trong khi kích thước của các quan hệ kiểm tra lần lượt được tăng từ 1 đến 6 triệu bộ. Mở rộng quy mô là một độ đo có giá trị vì nó chỉ ra liệu một thời gian đáp ứng không đổi có thể được duy trì khi tải công việc được tăng lên bằng cách thêm một số lượng bộ xử lý và ổ đĩa tỷ lệ thuận hay không. [ENGL89] mô tả một tập kiểm tra tương tự trên Release 2 của hệ thống NonStop SQL của Tandem.
Các quan hệ phép đo chuẩn được sử dụng cho các thí nghiệm dựa trên các quan hệ phép đo chuẩn Wisconsin tiêu chuẩn [BITT83]. Mỗi quan hệ bao gồm các bộ có độ rộng 208 byte. Chúng tôi đã xây dựng các phiên bản 100,000, 1 triệu, và 10 triệu bộ của các quan hệ phép đo chuẩn. Hai bản sao của mỗi quan hệ được tạo và nạp. Ngoại trừ trường hợp được ghi chú khác, các bộ được phân tán bằng cách phân vùng băm trên thuộc tính Unique1. Trong mọi trường hợp, các kết quả được trình bày biểu diễn thời gian đáp ứng trung bình của một số truy vấn tương đương. Gamma được cấu hình để sử dụng kích thước trang đĩa 8K byte và một nhóm bộ đệm 2 megabyte.
Kết quả của tất cả các truy vấn được lưu trữ trong cơ sở dữ liệu. Chúng tôi tránh trả dữ liệu về máy chủ để tránh việc tốc độ của liên kết truyền thông giữa máy chủ và máy cơ sở dữ liệu hoặc chính bộ xử lý máy chủ ảnh hưởng đến kết quả. Bằng cách lưu trữ các quan hệ kết quả trong cơ sở dữ liệu, tác động của các yếu tố này được giảm thiểu - với chi phí phải chịu thêm chi phí phân tán và lưu trữ các quan hệ kết quả.
6.2. Các truy vấn lựa chọn
Hiệu năng tương đối so với kích thước quan hệ
Tập kiểm tra lựa chọn đầu tiên được thiết kế để xác định cách Gamma phản hồi khi kích thước của các quan hệ nguồn được tăng lên trong khi cấu hình máy được giữ ở mức 30 bộ xử lý với các ổ đĩa. Lý tưởng nhất, thời gian đáp ứng của một truy vấn nên tăng theo một hàm tuyến tính của kích thước các quan hệ đầu vào và kết quả. Đối với các kiểm tra này, sáu truy vấn lựa chọn khác nhau được chạy trên ba tập quan hệ chứa lần lượt 100,000, 1 triệu, và 10 triệu bộ. Hai truy vấn đầu tiên có hệ số chọn lọc là 1% và 10% và không sử dụng bất kỳ chỉ mục nào. Truy vấn thứ ba và thứ tư có cùng các hệ số chọn lọc nhưng sử dụng một chỉ mục phân cụm để định vị các bộ thỏa mãn. Truy vấn thứ năm có hệ số chọn lọc 1% và sử dụng một chỉ mục không phân cụm để định vị các bộ mong muốn. Không có truy vấn lựa chọn 10% thông qua chỉ mục không phân cụm vì bộ tối ưu hóa truy vấn của Gamma chọn sử dụng quét tuần tự cho truy vấn này. Truy vấn cuối cùng sử dụng một chỉ mục phân cụm để lấy một bộ duy nhất. Ngoại trừ truy vấn cuối cùng, vị từ của mỗi truy vấn chỉ định một miền giá trị và do đó, vì các quan hệ đầu vào được phân tán bằng băm, truy vấn phải được gửi đến tất cả các nút.
Các kết quả từ các kiểm tra này được lập bảng trong Bảng 3. Phần lớn, thời gian thực thi của mỗi truy vấn mở rộng theo một hàm khá tuyến tính của kích thước các quan hệ đầu vào và đầu ra. Tuy nhiên, có một số trường hợp việc mở rộng không hoàn toàn tuyến tính. Trước tiên hãy xét phép lựa chọn 1% không có chỉ mục. Trong khi sự tăng thời gian đáp ứng khi kích thước quan hệ đầu vào được tăng từ 1 đến 10 triệu bộ gần như hoàn toàn tuyến tính (8.16 secs. đến 81.15 secs.), sự tăng từ 100,000 bộ đến 1 triệu bộ (0.45 sec. đến 8.16 sec) thực sự là dưới tuyến tính. Phép lựa chọn 10% sử dụng chỉ mục phân cụm là một ví dụ khác trong đó việc tăng kích thước quan hệ đầu vào lên một hệ số mười dẫn đến mức tăng lớn hơn mười lần trong thời gian đáp ứng của truy vấn. Truy vấn này mất 5.02 giây trên quan hệ 1 triệu bộ và 61.86 giây trên quan hệ 10 triệu bộ. Để hiểu tại sao điều này xảy ra, cần xem xét tác động của thời gian tìm kiếm lên thời gian thực thi của truy vấn. Vì hai bản sao của mỗi quan hệ đã được nạp, khi hai quan hệ một triệu bộ được phân tán trên 30 ổ đĩa, các mảnh chiếm xấp xỉ 53 cylinder (trong số 1224) trên mỗi ổ đĩa. Hai quan hệ mười triệu bộ lấp đầy khoảng 530 cylinder trên mỗi ổ đĩa. Khi mỗi trang của quan hệ kết quả được ghi vào đĩa, các đầu đọc đĩa phải được di chuyển từ vị trí hiện tại của chúng trên quan hệ đầu vào đến một khối trống trên đĩa. Vì vậy, với quan hệ 10 triệu bộ, chi phí ghi mỗi trang đầu ra cao hơn nhiều.
Như mong đợi, việc sử dụng chỉ mục B-tree phân cụm luôn cung cấp sự cải thiện đáng kể về hiệu năng. Một nhận xét rút ra từ Bảng 3 là tính nhất quán tương đối của thời gian thực thi của các truy vấn lựa chọn thông qua chỉ mục phân cụm. Lưu ý rằng thời gian thực thi của một phép lựa chọn 10% trên quan hệ 1 triệu bộ gần như giống hệt thời gian thực thi của phép lựa chọn 1% trên quan hệ 10 triệu bộ. Trong cả hai trường hợp, 100,000 bộ được lấy và lưu trữ, dẫn đến chi phí I/O và CPU giống hệt nhau.
Hàng cuối cùng của Bảng 3 trình bày thời gian cần thiết để chọn một bộ từ đơn bằng cách sử dụng chỉ mục phân cụm và trả nó về máy chủ. Vì vị từ chọn nằm trên thuộc tính phân vùng, truy vấn được hướng đến một nút duy nhất, tránh chi phí phụ trội của việc khởi động truy vấn trên tất cả 30 bộ xử lý. Thời gian đáp ứng cho truy vấn này tăng đáng kể khi kích thước
Bảng 3 - Các truy vấn chọn 30 Bộ xử lý với các đĩa (Tất cả thời gian thực thi tính bằng giây)
                                                                   Number of Tuples in Source Relation
Query Description                                    100,000          1,000,000          10,000,000

1% nonindexed selection                              0.45             8.16               81.15
10% nonindexed selection                             0.82             10.82              135.61
1% selection using clustered index                   0.35             0.82               5.12
10% selection using clustered index                  0.77             5.02               61.86
1% selection using non-clustered index               0.60             8.77               113.37
single tuple select using clustered index            0.08             0.08               0.14
của quan hệ được tăng từ 1 triệu lên 10 triệu bộ từ vì chiều cao của B-tree tăng từ hai lên ba mức.
Các thí nghiệm tăng tốc
Trong phần này, chúng tôi xem xét cách thời gian đáp ứng của cả các truy vấn chọn không có chỉ mục và có chỉ mục trên quan hệ 1 triệu bộ từ1 bị ảnh hưởng bởi số lượng bộ xử lý được sử dụng để thực thi truy vấn. Lý tưởng nhất là có thể thấy sự cải thiện tuyến tính về hiệu năng khi số lượng bộ xử lý được tăng từ 1 lên 30. Việc tăng số lượng bộ xử lý làm tăng cả công suất CPU tổng hợp và băng thông I/O khả dụng, đồng thời giảm số lượng bộ từ phải được xử lý bởi mỗi bộ xử lý.
Trong Hình 12, thời gian đáp ứng trung bình cho các truy vấn chọn không có chỉ mục 1% và 10% trên quan hệ một triệu bộ từ được trình bày. Như mong đợi, thời gian đáp ứng của mỗi truy vấn giảm khi số lượng nút được tăng lên. Thời gian đáp ứng cao hơn đối với phép chọn 10% do chi phí của việc phân cụm lại và lưu trữ quan hệ kết quả. Mặc dù luôn có thể lưu trữ các bộ từ kết quả cục bộ, bằng cách phân vùng tất cả các quan hệ kết quả theo cách round-robin (hoặc băm), có thể đảm bảo rằng các mảnh của mỗi quan hệ kết quả chứa xấp xỉ cùng một số lượng bộ từ. Các đường cong tăng tốc tương ứng với Hình 12 được trình bày trong Hình 13. Trong Hình 14, thời gian đáp ứng trung bình được trình bày như một hàm của số lượng bộ xử lý cho ba truy vấn sau: một phép chọn 1% thông qua chỉ mục phân cụm, một phép chọn 10% thông qua chỉ mục phân cụm, và một phép chọn 1% thông qua chỉ mục không phân cụm,
Hình 12
Hình 13 chỉ mục phân cụm, tất cả đều truy cập quan hệ 1 triệu bộ từ. Các đường cong tăng tốc tương ứng được trình bày trong Hình 15.
Trong số các đường cong tăng tốc được trình bày trong Hình 13 và 14, ba truy vấn là siêu tuyến tính, một truy vấn hơi dưới tuyến tính, và một truy vấn dưới tuyến tính đáng kể. Trước tiên, hãy xem xét phép chọn 10% thông qua quét quan hệ, phép chọn 1% thông qua chỉ mục không phân cụm, và phép chọn 10% thông qua chỉ mục phân cụm. Như đã thảo luận ở trên, nguồn gốc của các mức tăng tốc siêu tuyến tính thể hiện bởi các truy vấn này là do sự khác biệt đáng kể về thời gian mà các cấu hình khác nhau dành cho việc tìm kiếm. Với một bộ xử lý, quan hệ 1 triệu bộ từ chiếm xấp xỉ 66% đĩa. Khi cùng quan hệ đó được phân cụm lại trên 30 ổ đĩa, nó chiếm khoảng 2% của mỗi đĩa. Trong trường hợp chọn chỉ mục không phân cụm 1%, mỗi bộ từ được chọn yêu cầu một lần tìm kiếm ngẫu nhiên. Với một bộ xử lý, phạm vi của mỗi lần tìm kiếm ngẫu nhiên xấp xỉ 800 cylinder, trong khi với 30 bộ xử lý, phạm vi của lần tìm kiếm bị giới hạn khoảng 27 cylinder. Vì thời gian tìm kiếm tỷ lệ với căn bậc hai của khoảng cách mà đầu đĩa di chuyển [GRAY88], việc giảm kích thước của mảnh quan hệ trên mỗi đĩa làm giảm đáng kể lượng thời gian mà truy vấn dành cho việc tìm kiếm.
Một hiệu ứng tương tự cũng xảy ra với phép chọn chỉ mục phân cụm 10%. Trong trường hợp này, một khi chỉ mục đã được sử dụng để định vị các bộ từ thỏa mãn truy vấn, mỗi trang đầu vào sẽ tạo ra một trang đầu ra và tại một thời điểm nào đó vùng bộ đệm sẽ được lấp đầy bằng các trang đầu ra bẩn. Để ghi một trang đầu ra, đầu đĩa phải được di chuyển
Hình 14
Hình 15 từ vị trí của nó trên quan hệ đầu vào đến vị trí trên đĩa nơi các trang đầu ra được đặt. Chi phí tương đối của lần tìm kiếm này giảm tỷ lệ thuận khi số lượng bộ xử lý tăng lên, dẫn đến mức tăng tốc siêu tuyến tính cho truy vấn. Phép chọn không có chỉ mục 10% được thể hiện trong Hình 13 cũng siêu tuyến tính vì các lý do tương tự. Lý do truy vấn này không bị ảnh hưởng ở cùng mức độ là vì, không có chỉ mục, thời gian tìm kiếm chiếm một phần nhỏ hơn trong tổng thời gian thực thi của truy vấn.
Phép chọn 1% thông qua chỉ mục phân cụm thể hiện các mức tăng tốc dưới tuyến tính vì chi phí khởi tạo toán tử chọn và lưu trữ trên mỗi bộ xử lý (tổng cộng 0.24 giây cho 30 bộ xử lý) trở thành một phần đáng kể của tổng quá trình thực thi khi số lượng bộ xử lý được tăng lên.
Các thí nghiệm mở rộng quy mô
Trong tập cuối cùng của các thí nghiệm selection, số lượng bộ xử lý được thay đổi từ 5 đến 30 trong khi kích thước của các quan hệ đầu vào được tăng tương ứng từ 1 triệu đến 6 triệu bộ. Như được thể hiện trong Figure 16, thời gian phản hồi cho mỗi trong năm truy vấn selection vẫn gần như không đổi. Sự gia tăng nhỏ trong thời gian phản hồi là do chi phí phụ trội của việc khởi tạo toán tử selection và store tại mỗi site. Vì một process đơn được sử dụng để khởi tạo việc thực thi của một truy vấn, khi số lượng bộ xử lý được sử dụng tăng lên, tải trên process này cũng tăng theo tỷ lệ. Chuyển sang sơ đồ khởi tạo truy vấn dựa trên cây [GERB87] sẽ phân phối chi phí phụ trội này giữa tất cả các bộ xử lý.
Figure 16
6.3. Các truy vấn Join
Giống như các truy vấn selection trong phần trước, chúng tôi đã tiến hành ba tập thí nghiệm join. Trước tiên, đối với hai truy vấn join khác nhau, chúng tôi thay đổi kích thước của các quan hệ đầu vào trong khi cấu hình của các bộ xử lý được giữ không đổi. Tiếp theo, đối với một truy vấn join, một loạt các thí nghiệm speedup và scaleup đã được tiến hành. Với mỗi phép kiểm tra này, hai cách phân vùng khác nhau của các quan hệ đầu vào đã được sử dụng. Trong trường hợp thứ nhất, các quan hệ đầu vào được decluster bằng cách băm trên thuộc tính join. Trong trường hợp thứ hai, các quan hệ đầu vào được decluster bằng cách sử dụng một thuộc tính khác. Thuật toán join lai được sử dụng cho tất cả các truy vấn.
Hiệu năng tương đối so với kích thước quan hệ
Truy vấn join đầu tiên [BITT83], joinABprime, là một phép join đơn giản của hai quan hệ: A và Bprime. Quan hệ A chứa lần lượt 100,000, 1 triệu, hoặc 10 triệu bộ. Quan hệ Bprime chứa tương ứng 10,000, 100,000, hoặc 1 triệu bộ. Quan hệ kết quả có cùng số lượng bộ như quan hệ Bprime.1 Truy vấn thứ hai, joinAselB, bao gồm một phép join và một phép selection. A và B có cùng số lượng bộ và phép
selection trên B làm giảm kích thước của B xuống kích thước của quan hệ Bprime trong truy vấn joinABprime tương ứng. Quan hệ kết quả của truy vấn này có cùng số lượng bộ như trong truy vấn joinABprime tương ứng. Ví dụ, nếu A có 10 triệu bộ, thì joinABprime thực hiện join A với một quan hệ Bprime chứa 1 triệu bộ, trong khi trong joinAselB phép selection trên B giới hạn B từ 10 triệu bộ xuống 1 triệu bộ và sau đó thực hiện join kết quả với A.
Biến thể đầu tiên của các truy vấn join được kiểm tra không sử dụng chỉ mục và sử dụng một thuộc tính không phân vùng cho cả thuộc tính join và thuộc tính selection. Do đó, trước khi phép join có thể được thực hiện, hai quan hệ đầu vào phải được phân phối lại bằng cách băm trên giá trị thuộc tính join của mỗi bộ. Kết quả từ các phép kiểm tra này được trình bày trong 2 hàng đầu tiên của Table 4. Biến thể thứ hai của các truy vấn join cũng không sử dụng bất kỳ chỉ mục nào nhưng trong trường hợp này, các quan hệ được phân vùng băm trên thuộc tính join; cho phép bỏ qua giai đoạn phân phối lại của phép join. Kết quả cho các phép kiểm tra này được trình bày trong 2 hàng cuối của Table 4.
Các kết quả trong Table 4 chỉ ra rằng thời gian thực thi của mỗi truy vấn join tăng theo cách gần tuyến tính khi kích thước của các quan hệ đầu vào tăng lên. Gamma không thể hiện tính tuyến tính đối với các truy vấn 10 triệu bộ vì kích thước của quan hệ bên trong (208 megabyte) lớn gấp hai lần không gian khả dụng tổng cộng cho các bảng băm. Vì vậy, thuật toán join Hybrid cần hai bucket để xử lý các truy vấn này. Trong khi các bộ trong bucket đầu tiên có thể được đặt trực tiếp vào các bảng băm cư trú trong bộ nhớ, bucket thứ hai phải được ghi ra disk (xem Section 4.2).
Như dự kiến, phiên bản của mỗi truy vấn trong đó thuộc tính phân vùng được sử dụng làm thuộc tính join chạy nhanh hơn. Từ các kết quả này, có thể ước lượng một cận dưới về tốc độ tổng hợp mà dữ liệu có thể được phân phối lại bởi hypercube Intel iPSC/2. Xét phiên bản của truy vấn joinABprime trong đó một quan hệ một triệu bộ được
Table 4 - Các truy vấn Join 30 Bộ xử lý với Disk (Tất cả thời gian thực thi tính bằng giây)
| Mô tả truy vấn | 100,000 | 1,000,000 | 10,000,000 |
|---|---|---|---|
| JoinABprime với các thuộc tính không phân vùng của A và B được sử dụng làm thuộc tính join | 3.52 | 28.69 | 438.90 |
| JoinAselB với các thuộc tính không phân vùng của A và B được sử dụng làm thuộc tính join | 2.69 | 25.13 | 373.98 |
| JoinABprime với các thuộc tính phân vùng của A và B được sử dụng làm thuộc tính join | 3.34 | 25.95 | 426.25 |
| JoinAselB với các thuộc tính phân vùng của A và B được sử dụng làm thuộc tính join | 2.74 | 23.77 | 362.89 |
join với một quan hệ 100,000 bộ. Truy vấn này cần 28.69 giây khi phép join không được thực hiện trên thuộc tính phân vùng. Trong quá trình thực thi truy vấn này, 1.1 triệu bộ 208 byte phải được phân phối lại bằng cách băm trên thuộc tính join, tạo ra tốc độ truyền tổng hợp là 7.9 megabyte/giây trong quá trình xử lý truy vấn này. Tuy nhiên, điều này không nên được xem là một ước lượng chính xác về băng thông truyền thông giữa các bộ xử lý tối đa có thể đạt được vì các CPU có thể là yếu tố giới hạn (các disk khó có khả năng là yếu tố giới hạn vì từ Table 3 có thể ước lượng rằng băng thông tổng hợp của 30 disk là khoảng 25 megabyte/giây).
Các thí nghiệm Speedup
Đối với các thí nghiệm speedup của join, chúng tôi sử dụng truy vấn joinABprime với một quan hệ A có 1 triệu bộ và một quan hệ Bprime có 100,000 bộ. Số lượng bộ xử lý được thay đổi từ năm đến ba mươi. Vì với ít hơn năm bộ xử lý cần hai hoặc nhiều bucket, việc bao gồm thời gian thực thi cho một bộ xử lý (cần 5 bucket) sẽ khiến thời gian phản hồi cho năm hoặc nhiều bộ xử lý xuất hiện nhanh một cách giả tạo; dẫn đến các đường cong speedup siêu tuyến tính.
Thời gian đáp ứng thu được được biểu diễn trong Hình 17 và các đường cong tăng tốc tương ứng được trình bày trong Hình 18. Từ hình dạng của các đồ thị này, rõ ràng rằng thời gian thực thi của truy vấn được giảm đáng kể khi sử dụng thêm các bộ xử lý. Một số yếu tố ngăn hệ thống đạt được mức tăng tốc tuyến tính hoàn hảo.
Hình 17
Hình 18
Thứ nhất, chi phí khởi động bốn tác vụ toán tử (hai phép quét, một phép nối, và một phép lưu trữ) trên mỗi bộ xử lý tăng theo số lượng bộ xử lý được sử dụng. Thứ hai, ảnh hưởng của việc bỏ qua các thông điệp cục bộ giảm khi số lượng bộ xử lý tăng lên. Ví dụ, xét một cấu hình năm bộ xử lý và phiên bản thuộc tính không phân vùng của truy vấn JoinABprime. Khi mỗi bộ xử lý phân vùng lại các bộ bằng cách băm trên thuộc tính nối, 1/5 số bộ đầu vào mà nó xử lý được dành cho chính nó và sẽ được phần mềm truyền thông bỏ qua. Ngoài ra, khi truy vấn tạo ra các bộ của quan hệ kết quả (được phân vùng theo cách vòng tròn), chúng cũng sẽ được bỏ qua. Khi số lượng bộ xử lý tăng lên, số lượng gói tin được bỏ qua giảm đến mức với 30 bộ xử lý, chỉ 1/30 số gói tin được bỏ qua. Vì các gói tin nội nút này ít tốn kém hơn so với các gói tin liên nút tương ứng, các cấu hình nhỏ hơn sẽ hưởng lợi nhiều hơn từ việc bỏ qua. Trong trường hợp các phép nối theo thuộc tính phân vùng, tất cả các bộ đầu vào sẽ bỏ qua mạng cùng với một phần các bộ đầu ra.
Các thí nghiệm mở rộng quy mô
Truy vấn JoinABprime cũng được sử dụng cho các thí nghiệm mở rộng quy mô của phép nối. Đối với các phép thử này, số lượng bộ xử lý được thay đổi từ 5 đến 30 trong khi kích thước của quan hệ A được thay đổi từ 1 triệu đến 6 triệu bộ theo các bước tăng 1 triệu bộ và kích thước của quan hệ Bprime được thay đổi từ 100,000 đến 600,000 bộ theo các bước tăng 100,000. Với mỗi cấu hình, chỉ cần một bucket nối. Kết quả của các phép thử này được trình bày trong Hình 19. Ba yếu tố góp phần làm tăng nhẹ thời gian đáp ứng. Thứ nhất, tác vụ khởi tạo 4 tiến trình tại mỗi site được thực hiện bởi một bộ xử lý duy nhất. Thứ hai, khi số lượng bộ xử lý tăng lên, ảnh hưởng của việc bỏ qua thông điệp trong quá trình thực thi các truy vấn này giảm đi - đặc biệt trong trường hợp thuộc tính nối không phải là thuộc tính phân vùng. Cuối cùng, thời gian đáp ứng có thể bị giới hạn bởi tốc độ của mạng truyền thông.
Hình 19
6.4. Các truy vấn tổng hợp
Các phép thử tổng hợp của chúng tôi bao gồm sự kết hợp giữa các truy vấn tổng hợp vô hướng và các truy vấn hàm tổng hợp chạy trên cấu hình 30 bộ xử lý. Truy vấn đầu tiên tính giá trị nhỏ nhất của một thuộc tính không có chỉ mục. Hai truy vấn tiếp theo lần lượt tính tổng và giá trị nhỏ nhất của một thuộc tính sau khi phân vùng quan hệ thành 20 tập con. Ba kích thước của quan hệ đầu vào được sử dụng: 100,000, 1 triệu, và 10 triệu bộ. Kết quả từ các phép thử này được chứa trong Bảng 5. Vì các toán tử tổng hợp vô hướng và toán tử hàm tổng hợp được thực thi bằng các thuật toán tương tự như các thuật toán được sử dụng bởi các toán tử chọn và nối, tương ứng, nên không tiến hành các thí nghiệm tăng tốc hoặc mở rộng quy mô.
Bảng 5 - Các truy vấn tổng hợp 30 Bộ xử lý với Đĩa (Tất cả thời gian thực thi tính bằng giây)
| Mô tả truy vấn | Số lượng bộ trong quan hệ nguồn | ||
|---|---|---|---|
| 100,000 | 1,000,000 | 10,000,000 | |
| Tổng hợp vô hướng | 1.10 | 10.36 | 106.42 |
| Hàm tổng hợp Min (20 Phân vùng) | 2.03 | 12.48 | 120.03 |
| Hàm tổng hợp Sum (20 Phân vùng) | 2.03 | 12.39 | 120.22 |
6.5. Các truy vấn cập nhật
Tập các phép thử tiếp theo bao gồm sự kết hợp giữa các truy vấn thêm, xóa và sửa đổi trên ba kích thước quan hệ khác nhau: 100,000, 1 triệu, và 10 triệu bộ. Kết quả của các phép thử này được trình bày trong Bảng 6. Vì cơ chế phục hồi của Gamma vẫn chưa hoạt động, các kết quả này cần được xem xét tương ứng.
Truy vấn đầu tiên thêm một bộ đơn vào một quan hệ không tồn tại chỉ mục nào. Truy vấn thứ hai thêm một bộ vào một quan hệ có một chỉ mục tồn tại. Truy vấn thứ ba xóa một bộ đơn khỏi một quan hệ, sử dụng chỉ mục B-tree phân cụm để định vị bộ cần xóa. Trong truy vấn đầu tiên không có chỉ mục nào tồn tại và do đó không cần cập nhật chỉ mục nào, trong khi ở truy vấn thứ hai và thứ ba, một chỉ mục cần được cập nhật.
Các truy vấn thứ tư đến thứ sáu kiểm tra chi phí sửa đổi một bộ theo ba cách khác nhau. Trong cả ba phép thử, một chỉ mục không phân cụm tồn tại trên thuộc tính unique2, và ngoài ra, một chỉ mục phân cụm tồn tại trên thuộc tính Unique1. Trong trường hợp đầu tiên, thuộc tính được sửa đổi là thuộc tính phân vùng, do đó yêu cầu bộ được sửa đổi phải được định vị lại. Hơn nữa, vì bộ được định vị lại, chỉ mục thứ cấp cũng phải được cập nhật. Truy vấn sửa đổi thứ hai sửa đổi một thuộc tính không phân vùng, không có chỉ mục. Truy vấn sửa đổi thứ ba sửa đổi một thuộc tính trên đó một chỉ mục không phân cụm đã được xây dựng, sử dụng chỉ mục để định vị bộ cần sửa đổi.
Bảng 6 - Các truy vấn cập nhật 30 Bộ xử lý Với Đĩa (Tất cả thời gian thực thi tính bằng giây)
| Số lượng bộ trong quan hệ nguồn | |||
|---|---|---|---|
| 100,000 | 1,000,000 | 10,000,000 | |
| Thêm 1 bộ (Không tồn tại chỉ mục) | 0.07 | 0.08 | 0.10 |
| Thêm 1 bộ (Một chỉ mục tồn tại) | 0.18 | 0.21 | 0.22 |
| Xóa 1 bộ | 0.34 | 0.28 | 0.49 |
| Sửa đổi 1 bộ (#1) | 0.72 | 0.73 | 0.93 |
| Sửa đổi 1 bộ (#2) | 0.18 | 0.20 | 0.24 |
| Sửa đổi 1 bộ (#3) | 0.33 | 0.38 | 0.52 |
7 Các kết luận và hướng nghiên cứu trong tương lai
Trong bài báo này, chúng tôi đã mô tả thiết kế và triển khai của máy cơ sở dữ liệu Gamma. Gamma sử dụng kiến trúc không chia sẻ (shared-nothing) trong đó mỗi bộ xử lý có một hoặc nhiều đĩa và các bộ xử lý chỉ có thể giao tiếp với nhau bằng cách gửi thông điệp thông qua một mạng liên kết. Trong khi phiên bản trước của phần mềm Gamma chạy trên một tập hợp các VAX 11/750 được liên kết với nhau thông qua một vòng token 80 mbit/giây, hiện tại hệ thống chạy trên một siêu khối iPSC/2 của Intel với 32 bộ xử lý và 32 ổ đĩa.
Gamma sử dụng ba ý tưởng then chốt cho phép kiến trúc được mở rộng tới hàng trăm bộ xử lý. Thứ nhất, tất cả các quan hệ được phân vùng ngang trên nhiều ổ đĩa được gắn với các bộ xử lý riêng biệt; cho phép các quan hệ được quét song song mà không cần bất kỳ phần cứng chuyên dụng nào. Ngoài ra, để cho phép thiết kế cơ sở dữ liệu được điều chỉnh theo nhu cầu của ứng dụng, ba chiến lược phân vùng thay thế được cung cấp. Đóng góp lớn thứ hai của phần mềm Gamma là việc sử dụng rộng rãi các thuật toán song song dựa trên băm để xử lý các toán tử quan hệ phức tạp như các phép nối và các hàm tổng hợp. Cuối cùng, hệ thống sử dụng các kỹ thuật lập lịch luồng dữ liệu độc đáo để phối hợp việc thực thi các truy vấn đa toán tử. Các kỹ thuật này giúp có thể kiểm soát việc thực thi các truy vấn rất phức tạp với sự phối hợp tối thiểu - một yêu cầu cần thiết đối với các cấu hình liên quan đến số lượng lớn bộ xử lý
Ngoài việc mô tả thiết kế của phần mềm Gamma, chúng tôi cũng đã trình bày một đánh giá hiệu năng toàn diện của phiên bản Gamma trên siêu khối iPSC/2. Ba nhóm thí nghiệm đã được thực hiện. Thứ nhất, với một cấu hình máy cố định gồm 30 bộ xử lý, thời gian đáp ứng cho tập truy vấn chuẩn của phép đo chuẩn Wisconsin được đo với 3 kích thước khác nhau của các quan hệ. Đối với một tập con các truy vấn này, chúng tôi cũng đo hiệu năng của hệ thống tương ứng với số lượng bộ xử lý được sử dụng khi kích thước của các quan hệ đầu vào được giữ cố định (tăng tốc) và khi kích thước của các quan hệ đầu vào được tăng tỷ lệ thuận với số lượng bộ xử lý (mở rộng quy mô). Các kết quả tăng tốc thu được cho cả truy vấn chọn và truy vấn nối gần như tuyến tính hoàn hảo; do đó tăng gấp đôi số lượng bộ xử lý sẽ giảm một nửa thời gian đáp ứng cho một truy vấn. Các kết quả mở rộng quy mô thu được cũng rất đáng khích lệ. Chúng cho thấy thời gian đáp ứng không đổi có thể được duy trì cho cả các truy vấn chọn và truy vấn nối khi tải công việc được tăng lên bằng cách thêm số lượng bộ xử lý và đĩa tỷ lệ thuận.
Hiện tại chúng tôi đang tiến hành một số dự án mới. Thứ nhất, chúng tôi dự định triển khai cơ chế phân cụm liên kết và đánh giá tính hiệu quả của nó. Liên quan đến việc xử lý truy vấn, chúng tôi đã thiết kế [SCHN89b] và hiện đang đánh giá các chiến lược thay thế để xử lý các truy vấn liên quan đến nhiều phép nối. Ví dụ, xét một truy vấn liên quan đến 10 phép nối trên một máy có 100 bộ xử lý. Liệu tốt hơn là sử dụng tất cả 100 bộ xử lý cho mỗi phép nối (phân bổ 1/10 bộ nhớ trên mỗi bộ xử lý cho mỗi phép nối), hay sử dụng 10 bộ xử lý cho mỗi phép nối (trong trường hợp này mỗi toán tử nối sẽ được sử dụng toàn bộ bộ nhớ tại mỗi bộ xử lý)? Cuối cùng, chúng tôi đang nghiên cứu một số cơ chế phân vùng mới kết hợp các đặc điểm tốt nhất của các chiến lược phân vùng băm và phân vùng theo khoảng.
8 Lời cảm ơn
Giống như mọi dự án hệ thống lớn, một số lượng lớn người ngoài những người được liệt kê là tác giả đã làm cho bài báo này có thể thực hiện được. Bob Gerber xứng đáng nhận được sự ghi nhận đặc biệt vì công việc của ông trong việc thiết kế Gamma cùng với vai trò lãnh đạo của ông trong việc triển khai nguyên mẫu đầu tiên. Bộ tối ưu hóa truy vấn được M. Muralikrishna triển khai. Rajiv Jauhari đã triển khai cơ chế đọc trước để cải thiện hiệu năng của các phép quét tuần tự. Anoop Sharma đã triển khai cả các thuật toán tổng hợp và giao diện truy vấn nhúng. Goetz Graefe và Joanna Chen đã triển khai một trình biên dịch vị từ. Họ xứng đáng nhận được sự ghi nhận đặc biệt vì đã sẵn sàng gỡ lỗi mã máy do trình biên dịch tạo ra.
Chúng tôi cũng muốn cảm ơn Jim Gray và Susan Englert của Tandem Computers vì đã cho phép sử dụng bộ sinh quan hệ phép đo chuẩn Wisconsin của họ. Nếu không có bộ sinh này, các phép kiểm thử mà chúng tôi tiến hành đơn giản là không thể thực hiện được, vì trước đó chúng tôi không có cách nào tạo ra các quan hệ lớn hơn 1 triệu bộ.