Deep Residual Learning for Image Recognition
arXiv:1512.03385v1 [cs.CV] 10 Dec 2015
Học dư sâu cho nhận dạng ảnh
Kaiming He Xiangyu Zhang Shaoqing Ren Jian Sun
Microsoft Research
{kahe, v-xiangz, v-shren, jiansun}@microsoft.com
Tóm tắt
Mạng nơ-ron sâu hơn khó huấn luyện hơn. Chúng tôi trình bày một khung học dư để giúp việc huấn luyện các mạng sâu hơn đáng kể so với những mạng được sử dụng trước đây. Chúng tôi định dạng lại rõ ràng các lớp thành việc học các hàm dư với tham chiếu đến các đầu vào của lớp, thay vì học các hàm không có tham chiếu. Chúng tôi cung cấp bằng chứng thực nghiệm toàn diện cho thấy các mạng dư này dễ tối ưu hóa hơn, và có thể đạt được độ chính xác từ việc tăng độ sâu đáng kể. Trên tập dữ liệu ImageNet, chúng tôi đánh giá các mạng dư có độ sâu lên tới 152 lớp—sâu hơn 8× so với các mạng VGG [41] nhưng vẫn có độ phức tạp thấp hơn. Một tổ hợp các mạng dư này đạt được lỗi 3.57% trên tập kiểm thử ImageNet. Kết quả này giành vị trí thứ 1 trong nhiệm vụ phân loại ILSVRC 2015. Chúng tôi cũng trình bày phân tích trên CIFAR-10 với 100 và 1000 lớp.
Độ sâu của các biểu diễn có tầm quan trọng trung tâm đối với nhiều nhiệm vụ nhận dạng thị giác. Chỉ nhờ các biểu diễn cực kỳ sâu của chúng tôi, chúng tôi đạt được mức cải thiện tương đối 28% trên tập dữ liệu phát hiện đối tượng COCO. Các mạng dư sâu là nền tảng cho các bài nộp của chúng tôi tới các cuộc thi ILSVRC & COCO 20151, nơi chúng tôi cũng giành các vị trí thứ 1 trong các nhiệm vụ phát hiện ImageNet, định vị ImageNet, phát hiện COCO, và phân đoạn COCO.
arXiv:1512.03385v1 [cs.CV] 10 Dec 2015
Deep Residual Learning for Image Recognition
Kaiming He Xiangyu Zhang Shaoqing Ren Jian Sun
Microsoft Research
{kahe, v-xiangz, v-shren, jiansun}@microsoft.com
Abstract
Deeper neural networks are more difficult to train. We present a residual learning framework to ease the training of networks that are substantially deeper than those used previously. We explicitly reformulate the layers as learning residual functions with reference to the layer inputs, instead of learning unreferenced functions. We provide comprehensive empirical evidence showing that these residual networks are easier to optimize, and can gain accuracy from considerably increased depth. On the ImageNet dataset we evaluate residual nets with a depth of up to 152 layers—8× deeper than VGG nets [41] but still having lower complexity. An ensemble of these residual nets achieves 3.57% error on the ImageNet test set. This result won the 1st place on the ILSVRC 2015 classification task. We also present analysis on CIFAR-10 with 100 and 1000 layers.
The depth of representations is of central importance for many visual recognition tasks. Solely due to our extremely deep representations, we obtain a 28% relative improvement on the COCO object detection dataset. Deep residual nets are foundations of our submissions to ILSVRC & COCO 2015 competitions1, where we also won the 1st places on the tasks of ImageNet detection, ImageNet localization, COCO detection, and COCO segmentation.
1 Giới thiệu
1 Introduction
Các mạng nơ-ron tích chập sâu [22], [21] đã dẫn đến một loạt đột phá trong phân loại ảnh [21], [50], [40]. Các mạng sâu tự nhiên tích hợp các đặc trưng mức thấp/trung bình/cao [50] và các bộ phân loại theo cách nhiều lớp đầu-cuối, và các “mức” của đặc trưng có thể được làm phong phú hơn bởi số lượng lớp được xếp chồng (độ sâu). Các bằng chứng gần đây [41, 44] cho thấy độ sâu của mạng có tầm quan trọng then chốt, và các kết quả dẫn đầu [41, 44, 13, 16] trên tập dữ liệu ImageNet đầy thách thức [36] đều khai thác các mô hình “rất sâu” [41], với độ sâu từ mười sáu [41] đến ba mươi [16]. Nhiều tác vụ nhận dạng thị giác không tầm thường khác [8, 12, 7, 32, 27] cũng đã thu được nhiều lợi ích từ các mô hình rất sâu.
Deep convolutional neural networks [22], [21] have led to a series of breakthroughs for image classification [21], [50], [40]. Deep networks naturally integrate low/mid/high-level features [50] and classifiers in an end-to-end multilayer fashion, and the “levels” of features can be enriched by the number of stacked layers (depth). Recent evidence [41, 44] reveals that network depth is of crucial importance, and the leading results [41, 44, 13, 16] on the challenging ImageNet dataset [36] all exploit “very deep” [41] models, with a depth of sixteen [41] to thirty [16]. Many other non-trivial visual recognition tasks [8, 12, 7, 32, 27] have also greatly benefited from very deep models.
Bị thúc đẩy bởi tầm quan trọng của độ sâu, một câu hỏi được đặt ra: \Liệu việc học các mạng tốt hơn có dễ dàng như việc xếp chồng thêm các lớp không?\ Một trở ngại để trả lời câu hỏi này là vấn đề nổi tiếng về gradient biến mất/bùng nổ [1, 9], gây cản trở sự hội tụ ngay từ đầu. Tuy nhiên, vấn đề này phần lớn đã được giải quyết bằng khởi tạo được chuẩn hóa [23, 9, 37, 13] và các lớp chuẩn hóa trung gian [16], cho phép các mạng với hàng chục lớp bắt đầu hội tụ khi thực hiện giảm gradient ngẫu nhiên (SGD) với lan truyền ngược [22].
Driven by the significance of depth, a question arises: Is learning better networks as easy as stacking more layers? An obstacle to answering this question was the notorious problem of vanishing/exploding gradients [1, 9], which hamper convergence from the beginning. This problem, however, has been largely addressed by normalized initialization [23, 9, 37, 13] and intermediate normalization layers [16], which enable networks with tens of layers to start converging for stochastic gradient descent (SGD) with back-propagation [22].
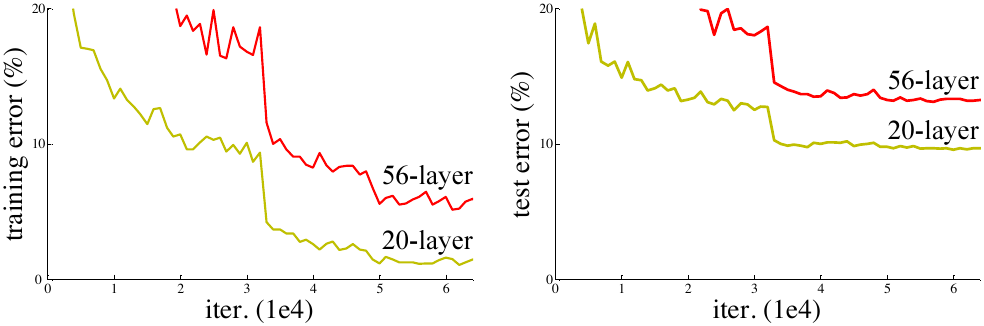
Khi các mạng sâu hơn có thể bắt đầu hội tụ, một vấn đề \suy giảm\ đã được phát hiện: khi độ sâu của mạng tăng lên, độ chính xác đạt trạng thái bão hòa (điều này có thể không đáng ngạc nhiên) và sau đó suy giảm nhanh chóng. Không ngờ rằng, sự suy giảm như vậy \không phải do quá khớp\, và việc thêm nhiều lớp hơn vào một mô hình đủ sâu dẫn đến \lỗi huấn luyện cao hơn\, như được báo cáo trong [11, 42] và được xác minh kỹ lưỡng bởi các thí nghiệm của chúng tôi. Hình 1 cho thấy một ví dụ điển hình.
When deeper networks are able to start converging, a degradation problem has been exposed: with the network depth increasing, accuracy gets saturated (which might be unsurprising) and then degrades rapidly. Unexpectedly, such degradation is not caused by overfitting, and adding more layers to a suitably deep model leads to higher training error, as reported in [11, 42] and thoroughly verified by our experiments. Fig. 1 shows a typical example.
Sự suy giảm (của độ chính xác huấn luyện) cho thấy không phải tất cả các hệ thống đều dễ tối ưu hóa như nhau. Hãy xem xét một kiến trúc nông hơn và phiên bản sâu hơn tương ứng của nó, bổ sung thêm các lớp vào đó. Tồn tại một giải pháp \bằng cách xây dựng\ cho mô hình sâu hơn: các lớp được thêm vào là \ánh xạ đồng nhất\, và các lớp còn lại được sao chép từ mô hình nông hơn đã được học. Sự tồn tại của giải pháp được xây dựng này cho thấy rằng một mô hình sâu hơn sẽ không tạo ra lỗi huấn luyện cao hơn so với phiên bản nông hơn tương ứng. Nhưng các thí nghiệm cho thấy rằng các bộ giải hiện có của chúng tôi không thể tìm thấy các giải pháp
The degradation (of training accuracy) indicates that not all systems are similarly easy to optimize. Let us consider a shallower architecture and its deeper counterpart that adds more layers onto it. There exists a solution by construction to the deeper model: the added layers are identity mapping, and the other layers are copied from the learned shallower model. The existence of this constructed solution indicates that a deeper model should produce no higher training error than its shallower counterpart. But experiments show that our current solvers on hand are unable to find solutions that
có chất lượng tương đương hoặc tốt hơn giải pháp được xây dựng (hoặc không thể thực hiện điều đó trong thời gian khả thi).
are comparably good or better than the constructed solution (or unable to do so in feasible time).
Trong bài báo này, chúng tôi giải quyết vấn đề suy giảm bằng cách giới thiệu một khung \học phần dư sâu\. Thay vì hy vọng rằng mỗi vài lớp được xếp chồng sẽ trực tiếp khớp với ánh xạ nền tảng mong muốn, chúng tôi cho phép rõ ràng các lớp này khớp với một ánh xạ phần dư. Về mặt hình thức, ký hiệu ánh xạ nền tảng mong muốn là , chúng tôi cho phép các lớp phi tuyến được xếp chồng khớp với một ánh xạ khác . Ánh xạ ban đầu được chuyển đổi thành . Chúng tôi đưa ra giả thuyết rằng việc tối ưu hóa ánh xạ phần dư dễ hơn so với tối ưu hóa ánh xạ ban đầu, không có tham chiếu. Ở mức cực đoan, nếu một ánh xạ đồng nhất là tối ưu, việc đẩy phần dư về không sẽ dễ hơn so với việc khớp một ánh xạ đồng nhất bằng một chồng các lớp phi tuyến.
In this paper, we address the degradation problem by introducing a deep residual learning framework. Instead of hoping each few stacked layers directly fit a desired underlying mapping, we explicitly let these layers fit a residual mapping. Formally, denoting the desired underlying mapping as , we let the stacked nonlinear layers fit another mapping of . The original mapping is recast into . We hypothesize that it is easier to optimize the residual mapping than to optimize the original, unreferenced mapping. To the extreme, if an identity mapping were optimal, it would be easier to push the residual to zero than to fit an identity mapping by a stack of nonlinear layers.
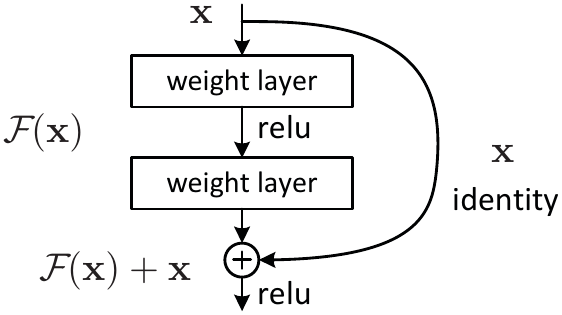
Cách biểu diễn có thể được hiện thực hóa bởi các mạng nơ-ron truyền thẳng với các “kết nối tắt” (Hình 2). Các kết nối tắt [2, 34, 49] là những kết nối bỏ qua một hoặc nhiều lớp. Trong trường hợp của chúng tôi, các kết nối tắt chỉ đơn giản thực hiện ánh xạ \đồng nhất\, và đầu ra của chúng được cộng vào đầu ra của các lớp được xếp chồng (Hình 2). Các kết nối tắt đồng nhất không thêm bất kỳ tham số bổ sung nào cũng như độ phức tạp tính toán. Toàn bộ mạng vẫn có thể được huấn luyện đầu-cuối bằng SGD với lan truyền ngược, và có thể dễ dàng được triển khai bằng cách sử dụng các thư viện thông dụng (\ví dụ\, Caffe [19]) mà không cần sửa đổi các bộ giải.
The formulation of can be realized by feedforward neural networks with “shortcut connections” (Fig. 2). Shortcut connections [2, 34, 49] are those skipping one or more layers. In our case, the shortcut connections simply perform identity mapping, and their outputs are added to the outputs of the stacked layers (Fig. 2). Identity shortcut connections add neither extra parameter nor computational complexity. The entire network can still be trained end-to-end by SGD with backpropagation, and can be easily implemented using common libraries (e.g., Caffe [19]) without modifying the solvers.
Chúng tôi trình bày các thí nghiệm toàn diện trên ImageNet [36] để chỉ ra vấn đề suy giảm và đánh giá phương pháp của mình. Chúng tôi chỉ ra rằng: 1) Các mạng dư cực sâu của chúng tôi dễ tối ưu hóa, nhưng các mạng “thuần” tương ứng (chỉ đơn giản xếp chồng các lớp) thể hiện lỗi huấn luyện cao hơn khi độ sâu tăng lên; 2) Các mạng dư sâu của chúng tôi có thể dễ dàng thu được lợi ích về độ chính xác từ việc tăng độ sâu đáng kể, tạo ra các kết quả tốt hơn nhiều so với các mạng trước đây.
We present comprehensive experiments on ImageNet [36] to show the degradation problem and evaluate our method. We show that: 1) Our extremely deep residual nets are easy to optimize, but the counterpart “plain” nets (that simply stack layers) exhibit higher training error when the depth increases; 2) Our deep residual nets can easily enjoy accuracy gains from greatly increased depth, producing results substantially better than previous networks.
Các hiện tượng tương tự cũng được thể hiện trên tập CIFAR-10 [20], cho thấy rằng những khó khăn trong tối ưu hóa và các tác động của phương pháp của chúng tôi không chỉ tương tự với một tập dữ liệu cụ thể. Chúng tôi trình bày các mô hình được huấn luyện thành công trên tập dữ liệu này với hơn 100 lớp, và khảo sát các mô hình với hơn 1000 lớp.
Similar phenomena are also shown on the CIFAR-10 set [20], suggesting that the optimization difficulties and the effects of our method are not just akin to a particular dataset. We present successfully trained models on this dataset with over 100 layers, and explore models with over 1000 layers.
Trên tập dữ liệu phân loại ImageNet [36], chúng tôi thu được các kết quả xuất sắc bằng các mạng dư cực sâu. Mạng dư 152 lớp của chúng tôi là mạng sâu nhất từng được trình bày trên ImageNet, đồng thời vẫn có độ phức tạp thấp hơn các mạng VGG [41]. Tổ hợp của chúng tôi có lỗi top-5 \\3.57%\\ trên tập \kiểm thử\ ImageNet, và \giành vị trí thứ nhất trong cuộc thi phân loại ILSVRC 2015\. Các biểu diễn cực sâu cũng có hiệu năng tổng quát hóa xuất sắc trên các tác vụ nhận dạng khác, và giúp chúng tôi tiếp tục \giành các vị trí thứ nhất trong: phát hiện ImageNet, định vị ImageNet, phát hiện COCO, và phân đoạn COCO\ trong các cuộc thi ILSVRC & COCO 2015. Bằng chứng mạnh mẽ này cho thấy nguyên lý học phần dư là tổng quát, và chúng tôi kỳ vọng rằng nó có thể áp dụng cho các vấn đề thị giác và phi thị giác khác.
On the ImageNet classification dataset [36], we obtain excellent results by extremely deep residual nets. Our 152-layer residual net is the deepest network ever presented on ImageNet, while still having lower complexity than VGG nets [41]. Our ensemble has 3.57% top-5 error on the ImageNet test set, and won the 1st place in the ILSVRC 2015 classification competition. The extremely deep representations also have excellent generalization performance on other recognition tasks, and lead us to further win the 1st places on: ImageNet detection, ImageNet localization, COCO detection, and COCO segmentation in ILSVRC & COCO 2015 competitions. This strong evidence shows that the residual learning principle is generic, and we expect that it is applicable in other vision and non-vision problems.
2 Công trình liên quan
2 Related Work
Biểu diễn phần dư. Trong nhận dạng ảnh, VLAD [18] là một biểu diễn mã hóa bằng các vectơ phần dư đối với một từ điển, và Fisher Vector [30] có thể được xây dựng như một phiên bản xác suất [18] của VLAD. Cả hai đều là các biểu diễn nông mạnh mẽ cho truy hồi ảnh và phân loại [4, 48]. Đối với lượng tử hóa vectơ, việc mã hóa các vectơ phần dư [17] được cho thấy hiệu quả hơn so với việc mã hóa các vectơ gốc.
Residual Representations. In image recognition, VLAD [18] is a representation that encodes by the residual vectors with respect to a dictionary, and Fisher Vector [30] can be formulated as a probabilistic version [18] of VLAD. Both of them are powerful shallow representations for image retrieval and classification [4, 48]. For vector quantization, encoding residual vectors [17] is shown to be more effective than encoding original vectors.
Trong thị giác mức thấp và đồ họa máy tính, để giải các Phương trình Vi phân Riêng phần (PDEs), phương pháp Multigrid được sử dụng rộng rãi [3] cải tổ hệ thống thành các bài toán con ở nhiều tỷ lệ, trong đó mỗi bài toán con chịu trách nhiệm cho nghiệm phần dư giữa một tỷ lệ thô hơn và một tỷ lệ mịn hơn. Một phương án thay thế cho Multigrid là tiền điều kiện hóa cơ sở phân cấp [45, 46], dựa trên các biến biểu diễn các vectơ phần dư giữa hai tỷ lệ. Đã được chứng minh [3, 45, 46] rằng các bộ giải này hội tụ nhanh hơn nhiều so với các bộ giải tiêu chuẩn không nhận biết bản chất phần dư của các nghiệm. Các phương pháp này cho thấy rằng một cách cải tổ hoặc tiền điều kiện hóa tốt có thể đơn giản hóa quá trình tối ưu hóa.
In low-level vision and computer graphics, for solving Partial Differential Equations (PDEs), the widely used Multigrid method [3] reformulates the system as subproblems at multiple scales, where each subproblem is responsible for the residual solution between a coarser and a finer scale. An alternative to Multigrid is hierarchical basis preconditioning [45, 46], which relies on variables that represent residual vectors between two scales. It has been shown [3, 45, 46] that these solvers converge much faster than standard solvers that are unaware of the residual nature of the solutions. These methods suggest that a good reformulation or preconditioning can simplify the optimization.
Kết nối tắt. Các thực hành và lý thuyết dẫn đến các kết nối tắt [2, 34, 49] đã được nghiên cứu trong một thời gian dài. Một thực hành ban đầu trong việc huấn luyện các perceptron nhiều lớp (MLPs) là thêm một lớp tuyến tính được kết nối từ đầu vào mạng đến đầu ra [34, 49]. Trong [44, 24], một vài lớp trung gian được kết nối trực tiếp với các bộ phân loại phụ để xử lý các gradient biến mất/bùng nổ. Các bài báo [39, 38, 31, 47] đề xuất các phương pháp căn giữa các phản hồi của lớp, các gradient và các lỗi được lan truyền, được triển khai bằng các kết nối tắt. Trong [44], một lớp “inception” được cấu thành từ một nhánh tắt và một vài nhánh sâu hơn.
Shortcut Connections. Practices and theories that lead to shortcut connections [2, 34, 49] have been studied for a long time. An early practice of training multi-layer perceptrons (MLPs) is to add a linear layer connected from the network input to the output [34, 49]. In [44, 24], a few intermediate layers are directly connected to auxiliary classifiers for addressing vanishing/exploding gradients. The papers of [39, 38, 31, 47] propose methods for centering layer responses, gradients, and propagated errors, implemented by shortcut connections. In [44], an “inception” layer is composed of a shortcut branch and a few deeper branches.
Đồng thời với công trình của chúng tôi, “mạng đường cao tốc” [42, 43] đưa ra các kết nối tắt với các hàm cổng [15]. Các cổng này phụ thuộc vào dữ liệu và có các tham số, trái ngược với các kết nối tắt ánh xạ đồng nhất của chúng tôi không có tham số. Khi một kết nối tắt có cổng bị “đóng” (tiến gần đến không), các lớp trong mạng đường cao tốc biểu diễn các hàm không phần dư. Ngược lại, công thức của chúng tôi luôn học các hàm phần dư; các kết nối tắt ánh xạ đồng nhất của chúng tôi không bao giờ bị đóng, và mọi thông tin luôn được truyền qua, cùng với các hàm phần dư bổ sung cần được học. Ngoài ra, mạng đường cao tốc chưa chứng minh được sự tăng độ chính xác với độ sâu tăng cực lớn (, trên 100 lớp).
Concurrent with our work, “highway networks” [42, 43] present shortcut connections with gating functions [15]. These gates are data-dependent and have parameters, in contrast to our identity shortcuts that are parameter-free. When a gated shortcut is “closed” (approaching zero), the layers in highway networks represent non-residual functions. On the contrary, our formulation always learns residual functions; our identity shortcuts are never closed, and all information is always passed through, with additional residual functions to be learned. In addition, highway networks have not demonstrated accuracy gains with extremely increased depth (, over 100 layers).
3 Học sâu dư thừa
3 Deep Residual Learning
3.1. Học dư thừa
3.1. Residual Learning
Xét là một ánh xạ nền tảng cần được khớp bởi một vài lớp xếp chồng (không nhất thiết là toàn bộ mạng), với biểu thị các đầu vào của lớp đầu tiên trong số các lớp này. Nếu giả thuyết rằng nhiều lớp phi tuyến có thể xấp xỉ tiệm cận các hàm phức tạp1, thì tương đương với việc giả thuyết rằng chúng có thể xấp xỉ tiệm cận các hàm dư thừa, , (giả sử đầu vào và đầu ra có cùng số chiều). Vì vậy, thay vì kỳ vọng các lớp xếp chồng xấp xỉ , chúng tôi cho phép rõ ràng các lớp này xấp xỉ một hàm dư thừa . Do đó, hàm ban đầu trở thành . Mặc dù cả hai dạng đều có thể xấp xỉ tiệm cận các hàm mong muốn (như đã giả thuyết), mức độ dễ học có thể khác nhau.
Let us consider as an underlying mapping to be fit by a few stacked layers (not necessarily the entire net), with denoting the inputs to the first of these layers. If one hypothesizes that multiple nonlinear layers can asymptotically approximate complicated functions1, then it is equivalent to hypothesize that they can asymptotically approximate the residual functions, , (assuming that the input and output are of the same dimensions). So rather than expect stacked layers to approximate , we explicitly let these layers approximate a residual function . The original function thus becomes . Although both forms should be able to asymptotically approximate the desired functions (as hypothesized), the ease of learning might be different.
Cách cải biến này được thúc đẩy bởi các hiện tượng phản trực giác liên quan đến vấn đề suy giảm (Hình 1, bên trái). Như chúng tôi đã thảo luận trong phần giới thiệu, nếu các lớp được thêm vào có thể được xây dựng dưới dạng các ánh xạ đồng nhất, một mô hình sâu hơn sẽ có lỗi huấn luyện không lớn hơn mô hình tương ứng nông hơn của nó. Vấn đề suy giảm cho thấy các bộ giải có thể gặp khó khăn trong việc xấp xỉ các ánh xạ đồng nhất bằng nhiều lớp phi tuyến. Với cách cải biến học dư thừa, nếu các ánh xạ đồng nhất là tối ưu, các bộ giải có thể đơn giản đưa các trọng số của nhiều lớp phi tuyến về gần bằng không để tiến gần đến các ánh xạ đồng nhất.
This reformulation is motivated by the counterintuitive phenomena about the degradation problem (Fig. 1, left). As we discussed in the introduction, if the added layers can be constructed as identity mappings, a deeper model should have training error no greater than its shallower counterpart. The degradation problem suggests that the solvers might have difficulties in approximating identity mappings by multiple nonlinear layers. With the residual learning reformulation, if identity mappings are optimal, the solvers may simply drive the weights of the multiple nonlinear layers toward zero to approach identity mappings.
Trong các trường hợp thực tế, khó có khả năng các ánh xạ đồng nhất là tối ưu, nhưng cách cải biến của chúng tôi có thể giúp tiền điều kiện hóa vấn đề. Nếu hàm tối ưu gần với một ánh xạ đồng nhất hơn là một ánh xạ không, bộ giải sẽ dễ dàng tìm thấy các nhiễu động có tham chiếu đến một ánh xạ đồng nhất hơn là học hàm đó như một hàm mới. Chúng tôi chỉ ra bằng các thí nghiệm (Hình 7) rằng các hàm dư thừa được học nhìn chung có phản hồi nhỏ, cho thấy các ánh xạ đồng nhất cung cấp sự tiền điều kiện hóa hợp lý.
In real cases, it is unlikely that identity mappings are optimal, but our reformulation may help to precondition the problem. If the optimal function is closer to an identity mapping than to a zero mapping, it should be easier for the solver to find the perturbations with reference to an identity mapping, than to learn the function as a new one. We show by experiments (Fig. 7) that the learned residual functions in general have small responses, suggesting that identity mappings provide reasonable preconditioning.
3.2. Ánh xạ đồng nhất bằng các đường tắt
3.2. Identity Mapping by Shortcuts
Chúng tôi áp dụng học dư thừa cho mỗi vài lớp xếp chồng. Một khối xây dựng được minh họa trong Hình 2. Về mặt hình thức, trong bài báo này chúng tôi xem xét một khối xây dựng được định nghĩa như sau:
We adopt residual learning to every few stacked layers. A building block is shown in Fig. 2. Formally, in this paper we consider a building block defined as:
Ở đây và là các vectơ đầu vào và đầu ra của các lớp được xem xét. Hàm biểu diễn ánh xạ dư thừa cần được học. Đối với ví dụ trong Hình 2 có hai lớp, trong đó biểu thị ReLU [29] và các độ lệch được bỏ qua để đơn giản hóa ký hiệu. Phép toán được thực hiện bởi một kết nối đường tắt và phép cộng theo từng phần tử. Chúng tôi áp dụng tính phi tuyến thứ hai sau phép cộng (, , xem Hình 2).
Here and are the input and output vectors of the layers considered. The function represents the residual mapping to be learned. For the example in Fig. 2 that has two layers, in which denotes ReLU [29] and the biases are omitted for simplifying notations. The operation is performed by a shortcut connection and element-wise addition. We adopt the second nonlinearity after the addition (, , see Fig. 2).
Các kết nối đường tắt trong Eqn.(1) không đưa vào thêm tham số hay độ phức tạp tính toán nào. Điều này không chỉ hấp dẫn trong thực tế mà còn quan trọng trong các so sánh của chúng tôi giữa mạng thông thường và mạng dư thừa. Chúng tôi có thể so sánh công bằng các mạng thông thường/dư thừa đồng thời có cùng số lượng tham số, độ sâu, độ rộng và chi phí tính toán (ngoại trừ phép cộng theo từng phần tử không đáng kể).
The shortcut connections in Eqn.(1) introduce neither extra parameter nor computation complexity. This is not only attractive in practice but also important in our comparisons between plain and residual networks. We can fairly compare plain/residual networks that simultaneously have the same number of parameters, depth, width, and computational cost (except for the negligible element-wise addition).
Các số chiều của và phải bằng nhau trong Eqn.(1). Nếu không phải vậy (, khi thay đổi các kênh đầu vào/đầu ra), chúng tôi có thể thực hiện phép chiếu tuyến tính thông qua các kết nối đường tắt để khớp các số chiều:
The dimensions of and must be equal in Eqn.(1). If this is not the case (, when changing the input/output channels), we can perform a linear projection by the shortcut connections to match the dimensions:
Chúng tôi cũng có thể sử dụng một ma trận vuông trong Eqn.(1). Nhưng chúng tôi sẽ chỉ ra bằng các thí nghiệm rằng ánh xạ đồng nhất là đủ để giải quyết vấn đề suy giảm và mang tính kinh tế, do đó chỉ được sử dụng khi khớp các số chiều.
We can also use a square matrix in Eqn.(1). But we will show by experiments that the identity mapping is sufficient for addressing the degradation problem and is economical, and thus is only used when matching dimensions.
Dạng của hàm dư thừa rất linh hoạt. Các thí nghiệm trong bài báo này liên quan đến một hàm có hai hoặc ba lớp (Hình 5), trong khi có thể có nhiều lớp hơn. Nhưng nếu chỉ có một lớp đơn, Eqn.(1) tương tự như một lớp tuyến tính: , và chúng tôi chưa quan sát thấy ưu điểm nào đối với trường hợp này.
The form of the residual function is flexible. Experiments in this paper involve a function that has two or three layers (Fig. 5), while more layers are possible. But if has only a single layer, Eqn.(1) is similar to a linear layer: , for which we have not observed advantages.
Chúng tôi cũng lưu ý rằng mặc dù các ký hiệu trên nói về các lớp kết nối đầy đủ để đơn giản hóa, chúng vẫn áp dụng được cho các lớp tích chập. Hàm có thể biểu diễn nhiều lớp tích chập. Phép cộng theo từng phần tử được thực hiện trên hai bản đồ đặc trưng, theo từng kênh.
We also note that although the above notations are about fully-connected layers for simplicity, they are applicable to convolutional layers. The function can represent multiple convolutional layers. The element-wise addition is performed on two feature maps, channel by channel.
3.3. Các kiến trúc mạng
3.3. Network Architectures
Chúng tôi đã kiểm thử nhiều mạng thông thường/dư thừa khác nhau và quan sát thấy các hiện tượng nhất quán. Để cung cấp các ví dụ cho việc thảo luận, chúng tôi mô tả hai mô hình cho ImageNet như sau.
We have tested various plain/residual nets, and have observed consistent phenomena. To provide instances for discussion, we describe two models for ImageNet as follows.
Mạng thông thường. Các đường cơ sở thông thường của chúng tôi (Hình 3, giữa) chủ yếu được truyền cảm hứng bởi triết lý của các mạng VGG [41] (Hình 3, trái). Các lớp tích chập chủ yếu có các bộ lọc và tuân theo hai quy tắc thiết kế đơn giản: (i) đối với cùng kích thước bản đồ đặc trưng đầu ra, các lớp có cùng số lượng bộ lọc; và (ii) nếu kích thước bản đồ đặc trưng giảm một nửa, số lượng bộ lọc tăng gấp đôi để duy trì độ phức tạp thời gian trên mỗi lớp. Chúng tôi thực hiện giảm mẫu trực tiếp bằng các lớp tích chập có bước chạy là 2. Mạng kết thúc với một lớp pooling trung bình toàn cục và một lớp kết nối đầy đủ 1000 chiều với softmax. Tổng số lớp có trọng số là 34 trong Hình 3 (giữa).
Plain Network. Our plain baselines (Fig. 3, middle) are mainly inspired by the philosophy of VGG nets [41] (Fig. 3, left). The convolutional layers mostly have filters and follow two simple design rules: (i) for the same output feature map size, the layers have the same number of filters; and (ii) if the feature map size is halved, the number of filters is doubled so as to preserve the time complexity per layer. We perform downsampling directly by convolutional layers that have a stride of 2. The network ends with a global average pooling layer and a 1000-way fully-connected layer with softmax. The total number of weighted layers is 34 in Fig. 3 (middle).
Đáng chú ý là mô hình của chúng tôi có ít bộ lọc hơn và độ phức tạp thấp hơn so với các mạng VGG [41] (Hình 3, trái). Đường cơ sở 34 lớp của chúng tôi có 3.6 tỷ FLOPs (multipy-adds), chỉ bằng 18% của VGG-19 (19.6 tỷ FLOPs).
It is worth noticing that our model has fewer filters and lower complexity than VGG nets [41] (Fig. 3, left). Our 34-layer baseline has 3.6 billion FLOPs (multipy-adds), which is only 18% of VGG-19 (19.6 billion FLOPs).
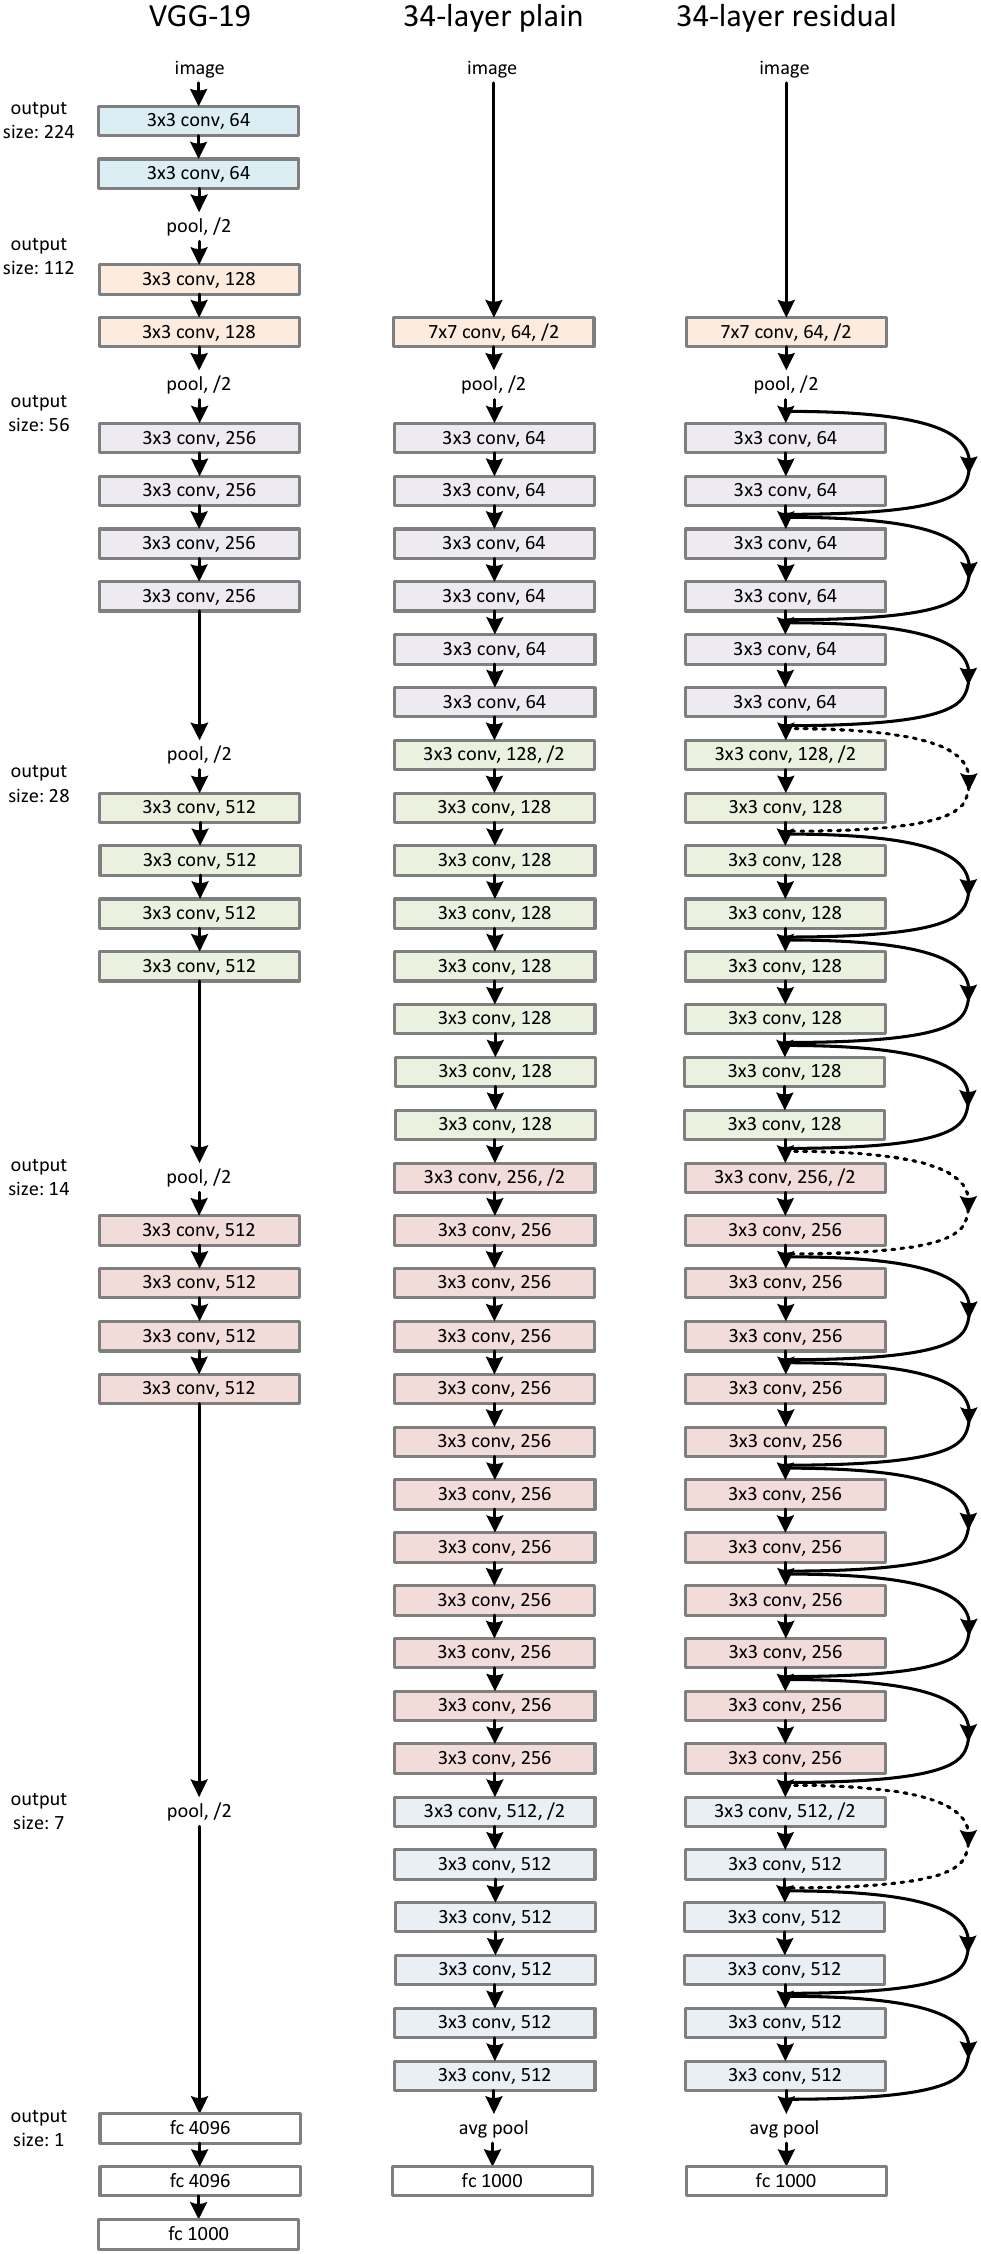
Mạng dư. Dựa trên mạng thường ở trên, chúng tôi chèn các kết nối tắt (Hình 3, bên phải) để biến mạng thành phiên bản dư tương ứng. Các kết nối tắt ánh xạ đồng nhất (Eqn.(1)) có thể được sử dụng trực tiếp khi đầu vào và đầu ra có cùng kích thước (các kết nối tắt đường liền trong Hình 3). Khi kích thước tăng lên (các kết nối tắt đường chấm trong Hình 3), chúng tôi xem xét hai tùy chọn: (A) Kết nối tắt vẫn thực hiện ánh xạ đồng nhất, với các phần tử không bổ sung được đệm thêm để tăng kích thước. Tùy chọn này không đưa thêm tham số nào; (B) Kết nối tắt phép chiếu trong Eqn.(2) được sử dụng để khớp kích thước (thực hiện bằng các tích chập ). Với cả hai tùy chọn, khi các kết nối tắt đi qua các bản đồ đặc trưng có hai kích thước, chúng được thực hiện với bước nhảy bằng 2.
Residual Network. Based on the above plain network, we insert shortcut connections (Fig. 3, right) which turn the network into its counterpart residual version. The identity shortcuts (Eqn.(1)) can be directly used when the input and output are of the same dimensions (solid line shortcuts in Fig. 3). When the dimensions increase (dotted line shortcuts in Fig. 3), we consider two options: (A) The shortcut still performs identity mapping, with extra zero entries padded for increasing dimensions. This option introduces no extra parameter; (B) The projection shortcut in Eqn.(2) is used to match dimensions (done by convolutions). For both options, when the shortcuts go across feature maps of two sizes, they are performed with a stride of 2.
3.4. Triển khai
3.4. Implementation
Triển khai của chúng tôi cho ImageNet tuân theo thực hành trong [21], [41]. Ảnh được thay đổi kích thước với cạnh ngắn hơn được lấy mẫu ngẫu nhiên trong để tăng cường theo tỷ lệ [41]. Một vùng cắt được lấy mẫu ngẫu nhiên từ một ảnh hoặc ảnh lật ngang của nó, với giá trị trung bình trên mỗi điểm ảnh được trừ đi [21]. Phép tăng cường màu chuẩn trong [21] được sử dụng. Chúng tôi áp dụng chuẩn hóa theo lô (BN) [16] ngay sau mỗi phép tích chập và trước khi kích hoạt, theo [16]. Chúng tôi khởi tạo các trọng số như trong [13] và huấn luyện tất cả các mạng thường/dư từ đầu. Chúng tôi sử dụng SGD với kích thước lô nhỏ là 256. Tốc độ học bắt đầu từ 0.1 và được chia cho 10 khi lỗi đạt trạng thái bão hòa, và các mô hình được huấn luyện tối đa lần lặp. Chúng tôi sử dụng suy giảm trọng số là 0.0001 và động lượng là 0.9. Chúng tôi không sử dụng dropout [14], theo thực hành trong [16].
Our implementation for ImageNet follows the practice in [21], [41]. The image is resized with its shorter side randomly sampled in for scale augmentation [41]. A crop is randomly sampled from an image or its horizontal flip, with the per-pixel mean subtracted [21]. The standard color augmentation in [21] is used. We adopt batch normalization (BN) [16] right after each convolution and before activation, following [16]. We initialize the weights as in [13] and train all plain/residual nets from scratch. We use SGD with a mini-batch size of 256. The learning rate starts from 0.1 and is divided by 10 when the error plateaus, and the models are trained for up to iterations. We use a weight decay of 0.0001 and a momentum of 0.9. We do not use dropout [14], following the practice in [16].
Trong kiểm thử, để so sánh các nghiên cứu, chúng tôi áp dụng phép kiểm thử cắt 10 vùng tiêu chuẩn [21]. Để đạt kết quả tốt nhất, chúng tôi áp dụng dạng tích chập đầy đủ như trong [41, 13], và lấy trung bình các điểm số ở nhiều tỷ lệ (các ảnh được thay đổi kích thước sao cho cạnh ngắn hơn nằm trong ).
4 Thí nghiệm
4 Experiments
4.1. Phân loại ImageNet
4.1. ImageNet Classification
Chúng tôi đánh giá phương pháp của mình trên tập dữ liệu phân loại ImageNet 2012 [36] gồm 1000 lớp. Các mô hình được huấn luyện trên 1,28 triệu ảnh huấn luyện, và được đánh giá trên 50k ảnh xác thực. Chúng tôi cũng thu được kết quả cuối cùng trên 100k ảnh kiểm thử, được báo cáo bởi server kiểm thử. Chúng tôi đánh giá cả tỷ lệ lỗi top-1 và top-5.
We evaluate our method on the ImageNet 2012 classification dataset [36] that consists of 1000 classes. The models are trained on the 1.28 million training images, and evaluated on the 50k validation images. We also obtain a final result on the 100k test images, reported by the test server. We evaluate both top-1 and top-5 error rates.
Mạng Thuần. Trước tiên chúng tôi đánh giá các mạng thuần 18 lớp và 34 lớp. Mạng thuần 34 lớp được trình bày trong Hình 3 (giữa). Mạng thuần 18 lớp có dạng tương tự. Xem Bảng 1 để biết các kiến trúc chi tiết.
Plain Networks. We first evaluate 18-layer and 34-layer plain nets. The 34-layer plain net is in Fig. 3 (middle). The 18-layer plain net is of a similar form. See Table 1 for detailed architectures.
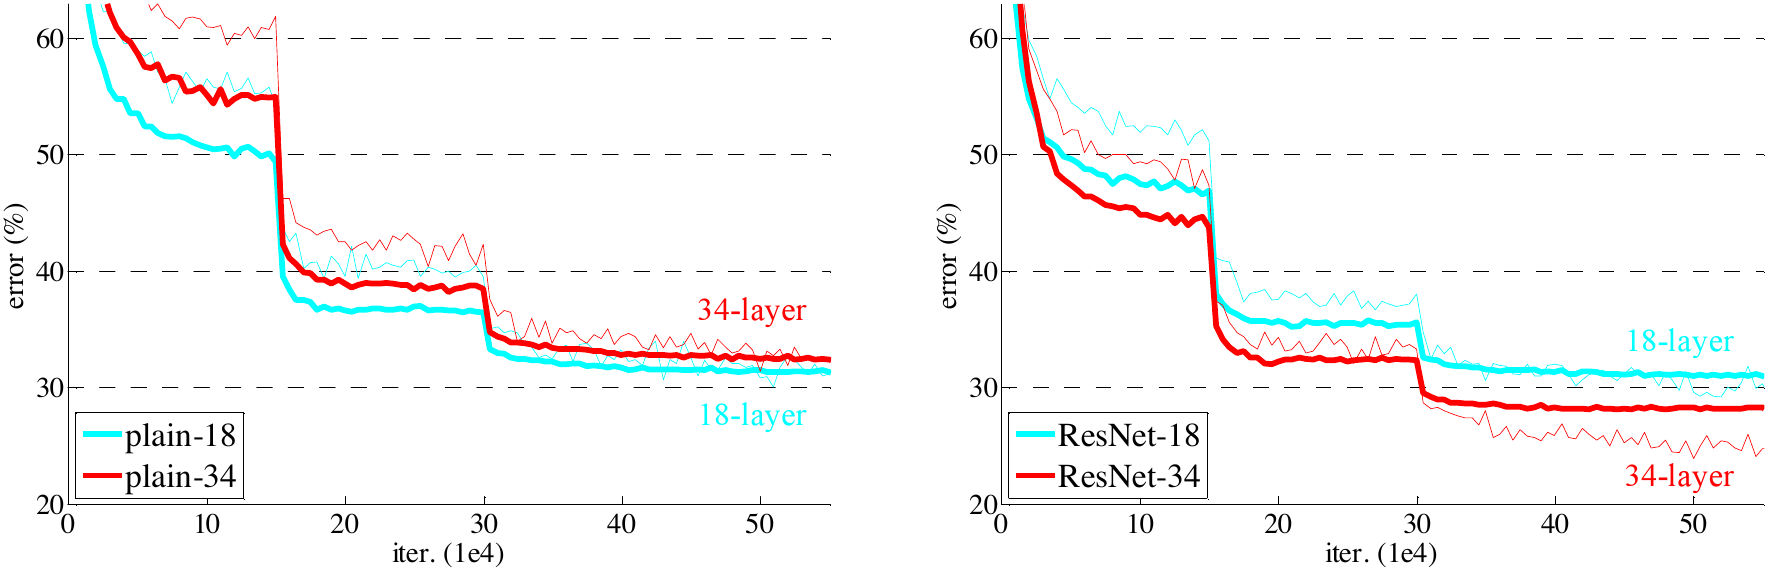
Các kết quả trong Bảng 2 cho thấy mạng thuần 34 lớp sâu hơn có lỗi xác thực cao hơn mạng thuần 18 lớp nông hơn. Để làm rõ nguyên nhân, trong Hình 4 (trái) chúng tôi so sánh lỗi huấn luyện/xác thực của chúng trong suốt quá trình huấn luyện. Chúng tôi đã quan sát thấy vấn đề suy giảm - mạng
The results in Table 2 show that the deeper 34-layer plain net has higher validation error than the shallower 18-layer plain net. To reveal the reasons, in Fig. 4 (left) we compare their training/validation errors during the training procedure. We have observed the degradation problem - the
              layer name     output size     18-layer              34-layer              50-layer                         101-layer                          152-layer
-------------------------------------------------------------------------------------------------------------------------------
conv1          112×112                                7×7, 64, stride 2
                                              3×3 max pool, stride 2
conv2_x        56×56           [3×3, 64            [3×3, 64            [1×1, 64                         [1×1, 64                          [1×1, 64
                                3×3, 64] ×2         3×3, 64] ×3         3×3, 64                          3×3, 64                           3×3, 64
                                                                        1×1, 256] ×3                    1×1, 256] ×3                     1×1, 256] ×3

conv3_x        28×28           [3×3, 128           [3×3, 128           [1×1, 128                        [1×1, 128                         [1×1, 128
                                3×3, 128] ×2        3×3, 128] ×4        3×3, 128                         3×3, 128                          3×3, 128
                                                                        1×1, 512] ×4                    1×1, 512] ×4                     1×1, 512] ×8

conv4_x        14×14           [3×3, 256           [3×3, 256           [1×1, 256                        [1×1, 256                         [1×1, 256
                                3×3, 256] ×2        3×3, 256] ×6        3×3, 256                         3×3, 256                          3×3, 256
                                                                        1×1, 1024] ×6                   1×1, 1024] ×23                   1×1, 1024] ×36

conv5_x        7×7             [3×3, 512           [3×3, 512           [1×1, 512                        [1×1, 512                         [1×1, 512
                                3×3, 512] ×2        3×3, 512] ×3        3×3, 512                         3×3, 512                          3×3, 512
                                                                        1×1, 2048] ×3                   1×1, 2048] ×3                    1×1, 2048] ×3
                1×1                                   average pool, 1000-d fc, softmax
FLOPs                                  1.8×10^9             3.6×10^9             3.8×10^9                         7.6×10^9                         11.3×10^9
              layer name     output size     18-layer              34-layer              50-layer                         101-layer                          152-layer
-------------------------------------------------------------------------------------------------------------------------------
conv1          112×112                                7×7, 64, stride 2
                                              3×3 max pool, stride 2
conv2_x        56×56           [3×3, 64            [3×3, 64            [1×1, 64                         [1×1, 64                          [1×1, 64
                                3×3, 64] ×2         3×3, 64] ×3         3×3, 64                          3×3, 64                           3×3, 64
                                                                        1×1, 256] ×3                    1×1, 256] ×3                     1×1, 256] ×3

conv3_x        28×28           [3×3, 128           [3×3, 128           [1×1, 128                        [1×1, 128                         [1×1, 128
                                3×3, 128] ×2        3×3, 128] ×4        3×3, 128                         3×3, 128                          3×3, 128
                                                                        1×1, 512] ×4                    1×1, 512] ×4                     1×1, 512] ×8

conv4_x        14×14           [3×3, 256           [3×3, 256           [1×1, 256                        [1×1, 256                         [1×1, 256
                                3×3, 256] ×2        3×3, 256] ×6        3×3, 256                         3×3, 256                          3×3, 256
                                                                        1×1, 1024] ×6                   1×1, 1024] ×23                   1×1, 1024] ×36

conv5_x        7×7             [3×3, 512           [3×3, 512           [1×1, 512                        [1×1, 512                         [1×1, 512
                                3×3, 512] ×2        3×3, 512] ×3        3×3, 512                         3×3, 512                          3×3, 512
                                                                        1×1, 2048] ×3                   1×1, 2048] ×3                    1×1, 2048] ×3
                1×1                                   average pool, 1000-d fc, softmax
FLOPs                                  1.8×10^9             3.6×10^9             3.8×10^9                         7.6×10^9                         11.3×10^9
Bảng 1. Các kiến trúc cho ImageNet. Các khối xây dựng được hiển thị trong dấu ngoặc vuông (xem thêm Hình 5), cùng với số lượng khối được xếp chồng. Việc giảm mẫu được thực hiện bởi conv3_1, conv4_1 và conv5_1 với stride bằng 2.
Table 1. Architectures for ImageNet. Building blocks are shown in brackets (see also Fig. 5), with the numbers of blocks stacked. Down-sampling is performed by conv3_1, conv4_1, and conv5_1 with a stride of 2.
| plain | ResNet | |
|---|---|---|
| 18 layers | 27.94 | 27.88 |
| 34 layers | 28.54 | 25.03 |
| plain | ResNet | |
|---|---|---|
| 18 layers | 27.94 | 27.88 |
| 34 layers | 28.54 | 25.03 |
Bảng 2. Lỗi top-1 (%, kiểm thử 10-crop) trên tập xác thực ImageNet. Ở đây các ResNet không có tham số bổ sung so với các mạng thuần tương ứng của chúng. Hình 4 cho thấy các quá trình huấn luyện.
Table 2. Top-1 error (%, 10-crop testing) on ImageNet validation. Here the ResNets have no extra parameter compared to their plain counterparts. Fig. 4 shows the training procedures.
mạng thuần 34 lớp có lỗi huấn luyện cao hơn trong toàn bộ quá trình huấn luyện, mặc dù không gian nghiệm của mạng thuần 18 lớp là một không gian con của mạng 34 lớp.
34-layer plain net has higher training error throughout the whole training procedure, even though the solution space of the 18-layer plain network is a subspace of that of the 34-layer one.
Chúng tôi cho rằng khó khăn tối ưu hóa này không có khả năng là do gradient bị tiêu biến. Các mạng thuần này được huấn luyện với BN [16], điều này bảo đảm các tín hiệu lan truyền thuận có phương sai khác không. Chúng tôi cũng xác nhận rằng các gradient lan truyền ngược thể hiện các chuẩn lành mạnh với BN. Do đó, cả tín hiệu thuận lẫn tín hiệu ngược đều không bị tiêu biến. Trên thực tế, mạng thuần 34 lớp vẫn có thể đạt được độ chính xác cạnh tranh (Bảng 3), cho thấy bộ giải hoạt động ở một mức độ nào đó. Chúng tôi phỏng đoán rằng các mạng thuần sâu có thể có tốc độ hội tụ thấp theo hàm mũ, điều này ảnh hưởng đến việc giảm lỗi huấn luyện1. Nguyên nhân của những khó khăn tối ưu hóa như vậy sẽ được nghiên cứu trong tương lai.
We argue that this optimization difficulty is unlikely to be caused by vanishing gradients. These plain networks are trained with BN [16], which ensures forward propagated signals to have non-zero variances. We also verify that the backward propagated gradients exhibit healthy norms with BN. So neither forward nor backward signals vanish. In fact, the 34-layer plain net is still able to achieve competitive accuracy (Table 3), suggesting that the solver works to some extent. We conjecture that the deep plain nets may have exponentially low convergence rates, which impact the reducing of the training error1. The reason for such optimization difficulties will be studied in the future.
Mạng Dư.
Residual Networks.
Tiếp theo chúng tôi đánh giá các mạng dư (ResNets) 18 lớp và 34 lớp. Các kiến trúc đường cơ sở giống như các mạng thuần ở trên, ngoại trừ việc một kết nối tắt được thêm vào mỗi cặp bộ lọc 3×3 như trong Hình 3 (phải). Trong phép so sánh đầu tiên (Bảng 2 và Hình 4 bên phải), chúng tôi sử dụng ánh xạ đồng nhất cho tất cả các kết nối tắt và đệm bằng số không để tăng số chiều (tùy chọn A). Vì vậy chúng không có tham số bổ sung so với các mạng thuần tương ứng.
Next we evaluate 18-layer and 34-layer residual nets (ResNets). The baseline architectures are the same as the above plain nets, except that a shortcut connection is added to each pair of 3×3 filters as in Fig. 3 (right). In the first comparison (Table 2 and Fig. 4 right), we use identity mapping for all shortcuts and zero-padding for increasing dimensions (option A). So they have no extra parameter compared to the plain counterparts.
Chúng tôi có ba quan sát chính từ Bảng 2 và Hình 4. Thứ nhất, tình huống bị đảo ngược với học phần dư (residual learning) – ResNet 34 lớp tốt hơn ResNet 18 lớp (hơn 2,8%). Quan trọng hơn, ResNet 34 lớp cho thấy lỗi huấn luyện thấp hơn đáng kể và có khả năng khái quát hóa đối với dữ liệu xác thực. Điều này cho thấy vấn đề suy giảm đã được xử lý tốt trong thiết lập này và chúng tôi đạt được mức tăng độ chính xác từ việc tăng độ sâu.
We have three major observations from Table 2 and Fig. 4. First, the situation is reversed with residual learning – the 34-layer ResNet is better than the 18-layer ResNet (by 2.8%). More importantly, the 34-layer ResNet exhibits considerably lower training error and is generalizable to the validation data. This indicates that the degradation problem is well addressed in this setting and we manage to obtain accuracy gains from increased depth.
Thứ hai, so với đối tác thuần túy của nó, mô hình 34 lớp
Second, compared to its plain counterpart, the 34-layer
              model                 top-1 err.   top-5 err.
VGG-16 [41]           28.07        9.33
GoogLeNet [44]        -            9.15
PReLU-net [13]        24.27        7.38
---------------------------------------------
plain-34              28.54        10.02
ResNet-34 A           25.03        7.76
ResNet-34 B           24.52        7.46
ResNet-34 C           24.19        7.40
---------------------------------------------
ResNet-50             22.85        6.71
ResNet-101            21.75        6.05
ResNet-152            21.43        5.71
              model                 top-1 err.   top-5 err.
VGG-16 [41]           28.07        9.33
GoogLeNet [44]        -            9.15
PReLU-net [13]        24.27        7.38
---------------------------------------------
plain-34              28.54        10.02
ResNet-34 A           25.03        7.76
ResNet-34 B           24.52        7.46
ResNet-34 C           24.19        7.40
---------------------------------------------
ResNet-50             22.85        6.71
ResNet-101            21.75        6.05
ResNet-152            21.43        5.71
Bảng 3. Tỷ lệ lỗi (%, kiểm thử 10-crop) trên tập xác thực ImageNet. VGG-16 dựa trên bài kiểm thử của chúng tôi. ResNet-50/101/152 thuộc lựa chọn B chỉ sử dụng phép chiếu để tăng số chiều.
Table 3. Error rates (%, 10-crop testing) on ImageNet validation. VGG-16 is based on our test. ResNet-50/101/152 are of option B that only uses projections for increasing dimensions.
              method                top-1 err.   top-5 err.
VGG [41] (ILSVRC’14)  -            8.43†
GoogLeNet [44] (ILSVRC’14)
                       -            7.89
---------------------------------------------
VGG [41] (v5)         24.4         7.1
PReLU-net [13]        21.59        5.71
BN-inception [16]     21.99        5.81
---------------------------------------------
ResNet-34 B           21.84        5.71
ResNet-34 C           21.53        5.60
ResNet-50             20.74        5.25
ResNet-101            19.87        4.60
ResNet-152            19.38        4.49
              method                top-1 err.   top-5 err.
VGG [41] (ILSVRC’14)  -            8.43†
GoogLeNet [44] (ILSVRC’14)
                       -            7.89
---------------------------------------------
VGG [41] (v5)         24.4         7.1
PReLU-net [13]        21.59        5.71
BN-inception [16]     21.99        5.81
---------------------------------------------
ResNet-34 B           21.84        5.71
ResNet-34 C           21.53        5.60
ResNet-50             20.74        5.25
ResNet-101            19.87        4.60
ResNet-152            19.38        4.49
Bảng 4. Tỷ lệ lỗi (%) của các kết quả mô hình đơn trên tập xác thực ImageNet (ngoại trừ † được báo cáo trên tập kiểm thử).
Table 4. Error rates (%) of single-model results on the ImageNet validation set (except † reported on the test set).
              method                         top-5 err. (test)
VGG [41] (ILSVRC’14)           7.32
GoogLeNet [44] (ILSVRC’14)     6.66
---------------------------------------------
VGG [41] (v5)                  6.8
PReLU-net [13]                4.94
BN-inception [16]             4.82
---------------------------------------------
ResNet (ILSVRC’15)            3.57
              method                         top-5 err. (test)
VGG [41] (ILSVRC’14)           7.32
GoogLeNet [44] (ILSVRC’14)     6.66
---------------------------------------------
VGG [41] (v5)                  6.8
PReLU-net [13]                4.94
BN-inception [16]             4.82
---------------------------------------------
ResNet (ILSVRC’15)            3.57
Bảng 5. Tỷ lệ lỗi (%) của các tổ hợp. Lỗi top-5 được đo trên tập kiểm thử của ImageNet và được báo cáo bởi test server.
Table 5. Error rates (%) of ensembles. The top-5 error is on the test set of ImageNet and reported by the test server.
ResNet làm giảm lỗi top-1 xuống 3,5% (Bảng 2), là kết quả của việc giảm thành công lỗi huấn luyện (Hình 4 bên phải so với bên trái). So sánh này xác minh hiệu quả của học phần dư trên các hệ thống cực sâu.
ResNet reduces the top-1 error by 3.5% (Table 2), resulting from the successfully reduced training error (Fig. 4 right vs. left). This comparison verifies the effectiveness of residual learning on extremely deep systems.
Cuối cùng, chúng tôi cũng lưu ý rằng các mạng thuần túy/phần dư 18 lớp có độ chính xác tương đương (Bảng 2), nhưng ResNet 18 lớp hội tụ nhanh hơn (Hình 4 bên phải so với bên trái). Khi mạng “không quá sâu” (ở đây là 18 lớp), bộ giải SGD hiện tại vẫn có khả năng tìm được các nghiệm tốt cho mạng thuần túy. Trong trường hợp này, ResNet làm cho việc tối ưu hóa dễ dàng hơn bằng cách cung cấp sự hội tụ nhanh hơn ở giai đoạn đầu.
Last, we also note that the 18-layer plain/residual nets are comparably accurate (Table 2), but the 18-layer ResNet converges faster (Fig. 4 right vs. left). When the net is “not overly deep” (18 layers here), the current SGD solver is still able to find good solutions to the plain net. In this case, the ResNet eases the optimization by providing faster convergence at the early stage.
Đường tắt Ánh xạ đồng nhất so với Phép chiếu.
Identity vs. Projection Shortcuts.
Chúng tôi đã chỉ ra rằng các đường tắt ánh xạ đồng nhất không có tham số giúp ích cho việc huấn luyện. Tiếp theo chúng tôi khảo sát các đường tắt phép chiếu (Eqn.(2)). Trong Bảng 3 chúng tôi so sánh ba lựa chọn: (A) các đường tắt zero-padding được sử dụng để tăng số chiều, và tất cả các đường tắt đều không có tham số (giống như Bảng 2 và Hình 4 bên phải); (B) các đường tắt phép chiếu được sử dụng để tăng số chiều, còn các đường tắt khác là ánh xạ đồng nhất; và (C) tất cả các đường tắt đều là phép chiếu.
We have shown that parameter-free, identity shortcuts help with training. Next we investigate projection shortcuts (Eqn.(2)). In Table 3 we compare three options: (A) zero-padding shortcuts are used for increasing dimensions, and all shortcuts are parameter-free (the same as Table 2 and Fig. 4 right); (B) projection shortcuts are used for increasing dimensions, and other shortcuts are identity; and (C) all shortcuts are projections.
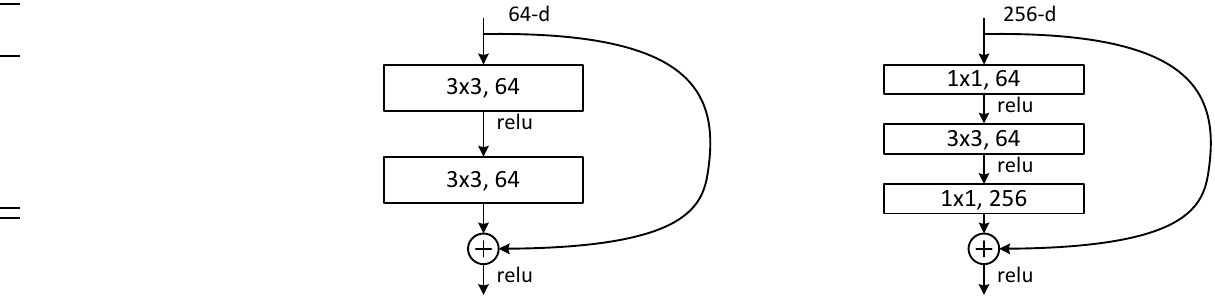
Bảng 3 cho thấy cả ba lựa chọn đều tốt hơn đáng kể so với đối tác thuần túy. B tốt hơn A một chút. Chúng tôi cho rằng điều này là do các chiều được zero-padding trong A thực sự không có học phần dư. C tốt hơn B ở mức rất nhỏ, và chúng tôi quy điều này cho các tham số bổ sung được đưa vào bởi nhiều (mười ba) đường tắt phép chiếu. Nhưng các khác biệt nhỏ giữa A/B/C cho thấy các đường tắt phép chiếu không phải là yếu tố thiết yếu để giải quyết vấn đề suy giảm. Vì vậy chúng tôi không sử dụng lựa chọn C trong phần còn lại của bài báo này, nhằm giảm độ phức tạp bộ nhớ/thời gian và kích thước mô hình. Các đường tắt ánh xạ đồng nhất đặc biệt quan trọng để không làm tăng độ phức tạp của các kiến trúc bottleneck được giới thiệu dưới đây.
Table 3 shows that all three options are considerably better than the plain counterpart. B is slightly better than A. We argue that this is because the zero-padded dimensions in A indeed have no residual learning. C is marginally better than B, and we attribute this to the extra parameters introduced by many (thirteen) projection shortcuts. But the small differences among A/B/C indicate that projection shortcuts are not essential for addressing the degradation problem. So we do not use option C in the rest of this paper, to reduce memory/time complexity and model sizes. Identity shortcuts are particularly important for not increasing the complexity of the bottleneck architectures that are introduced below.
Các Kiến trúc Bottleneck Sâu hơn.
Deeper Bottleneck Architectures.
Tiếp theo chúng tôi mô tả các mạng sâu hơn của mình cho ImageNet. Do những lo ngại về thời gian huấn luyện mà chúng tôi có thể chấp nhận được, chúng tôi sửa đổi khối xây dựng theo thiết kế bottleneck.^4 Với mỗi hàm phần dư , chúng tôi sử dụng một chồng gồm 3 lớp thay vì 2 (Hình 5). Ba lớp này là các tích chập 1×1, 3×3 và 1×1, trong đó các lớp 1×1 chịu trách nhiệm giảm rồi tăng (khôi phục) số chiều, để lại lớp 3×3 như một bottleneck với số chiều đầu vào/đầu ra nhỏ hơn. Hình 5 cho thấy một ví dụ, trong đó cả hai thiết kế có độ phức tạp thời gian tương tự.
Next we describe our deeper nets for ImageNet. Because of concerns on the training time that we can afford, we modify the building block as a bottleneck design.^4 For each residual function , we use a stack of 3 layers instead of 2 (Fig. 5). The three layers are 1×1, 3×3, and 1×1 convolutions, where the 1×1 layers are responsible for reducing and then increasing (restoring) dimensions, leaving the 3×3 layer a bottleneck with smaller input/output dimensions. Fig. 5 shows an example, where both designs have similar time complexity.
Các đường tắt ánh xạ đồng nhất không có tham số đặc biệt quan trọng đối với các kiến trúc bottleneck. Nếu đường tắt ánh xạ đồng nhất trong Hình 5 (bên phải) được thay thế bằng phép chiếu, có thể chỉ ra rằng độ phức tạp thời gian và kích thước mô hình bị tăng gấp đôi, vì đường tắt được kết nối với hai đầu có số chiều cao. Do đó các đường tắt ánh xạ đồng nhất dẫn đến các mô hình hiệu quả hơn cho các thiết kế bottleneck.
The parameter-free identity shortcuts are particularly important for the bottleneck architectures. If the identity shortcut in Fig. 5 (right) is replaced with projection, one can show that the time complexity and model size are doubled, as the shortcut is connected to the two high-dimensional ends. So identity shortcuts lead to more efficient models for the bottleneck designs.
ResNet 50 lớp:
50-layer ResNet:
Chúng tôi thay thế mỗi khối 2 lớp trong
We replace each 2-layer block in the
mạng 34 lớp bằng khối bottleneck 3 lớp này, tạo thành một ResNet 50 lớp (Bảng 1). Chúng tôi sử dụng lựa chọn B để tăng số chiều. Mô hình này có 3,8 tỷ FLOP.
34-layer net with this 3-layer bottleneck block, resulting in a 50-layer ResNet (Table 1). We use option B for increasing dimensions. This model has 3.8 billion FLOPs.
ResNet 101 lớp và 152 lớp: Chúng tôi xây dựng các ResNet 101 lớp và 152 lớp bằng cách sử dụng nhiều khối 3 lớp hơn (Bảng 1). Đáng chú ý là mặc dù độ sâu được tăng lên đáng kể, ResNet 152 lớp (11,3 tỷ FLOP) vẫn có độ phức tạp thấp hơn các mạng VGG-16/19 (15,3/19,6 tỷ FLOP).
101-layer and 152-layer ResNets: We construct 101-layer and 152-layer ResNets by using more 3-layer blocks (Table 1). Remarkably, although the depth is significantly increased, the 152-layer ResNet (11.3 billion FLOPs) still has lower complexity than VGG-16/19 nets (15.3/19.6 billion FLOPs).
Các ResNet 50/101/152 lớp chính xác hơn đáng kể so với phiên bản 34 lớp (Bảng 3 và 4). Chúng tôi không quan sát thấy vấn đề suy giảm và do đó thu được mức tăng độ chính xác đáng kể từ việc tăng mạnh độ sâu. Lợi ích của độ sâu được thể hiện trên mọi thước đo đánh giá (Bảng 3 và 4).
The 50/101/152-layer ResNets are more accurate than the 34-layer ones by considerable margins (Table 3 and 4). We do not observe the degradation problem and thus enjoy significant accuracy gains from considerably increased depth. The benefits of depth are witnessed for all evaluation metrics (Table 3 and 4).
So sánh với các phương pháp tiên tiến nhất. Trong Bảng 4, chúng tôi so sánh với các kết quả mô hình đơn tốt nhất trước đó. Các ResNet 34 lớp đường cơ sở của chúng tôi đã đạt được độ chính xác rất cạnh tranh. ResNet 152 lớp của chúng tôi có lỗi kiểm định top-5 của một mô hình đơn là 4,49%. Kết quả mô hình đơn này vượt qua mọi kết quả tổ hợp trước đó (Bảng 5). Chúng tôi kết hợp sáu mô hình có độ sâu khác nhau để tạo thành một tổ hợp (chỉ có hai mô hình 152 lớp vào thời điểm nộp bài). Điều này dẫn đến lỗi top-5 3,57% trên tập kiểm thử (Bảng 5). Mục này đã giành vị trí thứ nhất trong ILSVRC 2015.
Comparisons with State-of-the-art Methods. In Table 4 we compare with the previous best single-model results. Our baseline 34-layer ResNets have achieved very competitive accuracy. Our 152-layer ResNet has a single-model top-5 validation error of 4.49%. This single-model result outperforms all previous ensemble results (Table 5). We combine six models of different depth to form an ensemble (only with two 152-layer ones at the time of submitting). This leads to 3.57% top-5 error on the test set (Table 5). This entry won the 1st place in ILSVRC 2015.
4.2. CIFAR-10 và Phân tích
4.2. CIFAR-10 and Analysis
Chúng tôi tiến hành thêm các nghiên cứu trên tập dữ liệu (dataset) CIFAR-10 [20], bao gồm 50k ảnh huấn luyện và 10k ảnh kiểm thử thuộc 10 lớp. Chúng tôi trình bày các thí nghiệm được huấn luyện trên tập huấn luyện và đánh giá trên tập kiểm thử. Trọng tâm của chúng tôi là hành vi của các mạng cực sâu, chứ không phải nhằm đẩy kết quả tiên tiến nhất lên cao hơn, vì vậy chúng tôi chủ ý sử dụng các kiến trúc đơn giản như sau.
We conducted more studies on the CIFAR-10 dataset [20], which consists of 50k training images and 10k testing images in 10 classes. We present experiments trained on the training set and evaluated on the test set. Our focus is on the behaviors of extremely deep networks, but not on pushing the state-of-the-art results, so we intentionally use simple architectures as follows.
Các kiến trúc thuần túy/phần dư tuân theo dạng trong Hình 3 (giữa/phải). Đầu vào của mạng là các ảnh 32×32, với giá trị trung bình theo từng pixel đã được trừ đi. Lớp đầu tiên là các tích chập (convolution) 3×3. Sau đó chúng tôi sử dụng một chồng gồm lớp với các tích chập 3×3 trên các bản đồ đặc trưng có kích thước lần lượt là {32, 16, 8}, với lớp cho mỗi kích thước bản đồ đặc trưng. Số lượng bộ lọc lần lượt là {16, 32, 64}. Việc lấy mẫu xuống được thực hiện bằng các tích chập có bước nhảy bằng 2. Mạng kết thúc bằng một lớp gộp trung bình toàn cục, một lớp kết nối đầy đủ 10 đầu ra, và softmax. Tổng cộng có lớp có trọng số được xếp chồng. Bảng sau tóm tắt kiến trúc:
The plain/residual architectures follow the form in Fig. 3 (middle/right). The network inputs are 32×32 images, with the per-pixel mean subtracted. The first layer is 3×3 convolutions. Then we use a stack of layers with 3×3 convolutions on the feature maps of sizes {32, 16, 8} respectively, with layers for each feature map size. The numbers of filters are {16, 32, 64} respectively. The subsampling is performed by convolutions with a stride of 2. The network ends with a global average pooling, a 10-way fully-connected layer, and softmax. There are totally stacked weighted layers. The following table summarizes the architecture:
| kích thước bản đồ đầu ra | 32×32 | 16×16 | 8×8 |
|---|---|---|---|
| số lớp | 1+2n | 2n | 2n |
| số bộ lọc | 16 | 32 | 64 |
| output map size | 32×32 | 16×16 | 8×8 |
|---|---|---|---|
| # layers | 1+2n | 2n | 2n |
| # filters | 16 | 32 | 64 |
Khi các kết nối tắt được sử dụng, chúng được nối tới các cặp lớp 3×3 (tổng cộng 3 kết nối tắt). Trên tập dữ liệu này chúng tôi sử dụng các kết nối tắt ánh xạ đồng nhất (identity) trong mọi trường hợp (tức là, lựa chọn A),
When shortcut connections are used, they are connected to the pairs of 3×3 layers (totally 3 shortcuts). On this dataset we use identity shortcuts in all cases (i.e., option A),
                                       method                 error (%)
                         Maxout [10]            9.38
                         NIN [25]               8.81
                         DSN [24]               8.22

                         # layers   # params
FitNet [35]                 19        2.5M      8.39
Highway [42, 43]            19        2.3M      7.54 (7.72±0.16)
Highway [42, 43]            32        1.25M     8.80
ResNet                      20        0.27M     8.75
ResNet                      32        0.46M     7.51
ResNet                      44        0.66M     7.17
ResNet                      56        0.85M     6.97
ResNet                     110        1.7M      6.43 (6.61±0.16)
ResNet                    1202       19.4M      7.93
                                       method                 error (%)
                         Maxout [10]            9.38
                         NIN [25]               8.81
                         DSN [24]               8.22

                         # layers   # params
FitNet [35]                 19        2.5M      8.39
Highway [42, 43]            19        2.3M      7.54 (7.72±0.16)
Highway [42, 43]            32        1.25M     8.80
ResNet                      20        0.27M     8.75
ResNet                      32        0.46M     7.51
ResNet                      44        0.66M     7.17
ResNet                      56        0.85M     6.97
ResNet                     110        1.7M      6.43 (6.61±0.16)
ResNet                    1202       19.4M      7.93
Bảng 6. Lỗi phân loại trên tập kiểm thử CIFAR-10. Tất cả các phương pháp đều sử dụng tăng cường dữ liệu. Đối với ResNet-110, chúng tôi chạy 5 lần và hiển thị “tốt nhất (trung bình±độ lệch chuẩn)” như trong [43].
Table 6. Classification error on the CIFAR-10 test set. All methods are with data augmentation. For ResNet-110, we run it 5 times and show “best (mean±std)” as in [43].
vì vậy các mô hình phần dư của chúng tôi có chính xác cùng độ sâu, độ rộng và số lượng tham số như các đối tác thuần túy.
so our residual models have exactly the same depth, width, and number of parameters as the plain counterparts.
Chúng tôi sử dụng weight decay bằng 0,0001 và momentum bằng 0,9, đồng thời áp dụng khởi tạo trọng số trong [13] và BN [16] nhưng không dùng dropout. Các mô hình này được huấn luyện với kích thước mini-batch là 128 trên hai GPU. Chúng tôi bắt đầu với tốc độ học là 0,1, chia nó cho 10 tại các vòng lặp 32k và 48k, và kết thúc huấn luyện tại 64k vòng lặp, được xác định trên phép chia train/val 45k/5k. Chúng tôi tuân theo phương pháp tăng cường dữ liệu đơn giản trong [24] để huấn luyện: đệm thêm 4 pixel ở mỗi phía, và lấy ngẫu nhiên một vùng cắt 32×32 từ ảnh đã được đệm hoặc ảnh lật ngang của nó. Đối với kiểm thử, chúng tôi chỉ đánh giá một góc nhìn duy nhất của ảnh gốc 32×32.
We use a weight decay of 0.0001 and momentum of 0.9, and adopt the weight initialization in [13] and BN [16] but with no dropout. These models are trained with a mini-batch size of 128 on two GPUs. We start with a learning rate of 0.1, divide it by 10 at 32k and 48k iterations, and terminate training at 64k iterations, which is determined on a 45k/5k train/val split. We follow the simple data augmentation in [24] for training: 4 pixels are padded on each side, and a 32×32 crop is randomly sampled from the padded image or its horizontal flip. For testing, we only evaluate the single view of the original 32×32 image.
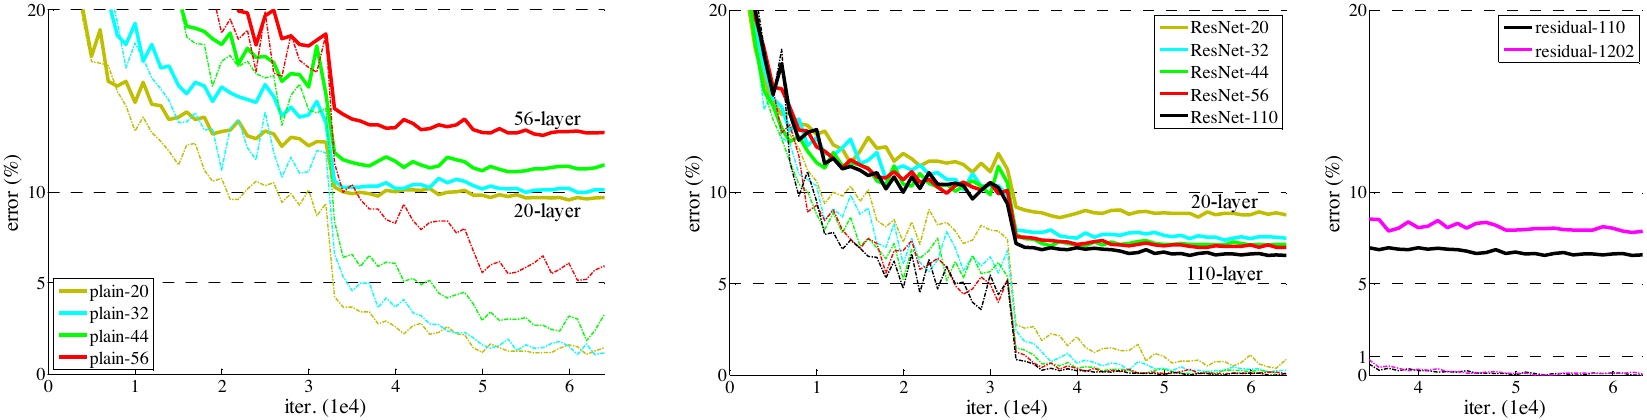
Chúng tôi so sánh , tương ứng tạo ra các mạng 20, 32, 44 và 56 lớp. Hình 6 (trái) cho thấy hành vi của các mạng thuần túy. Các mạng thuần túy sâu bị ảnh hưởng bất lợi khi độ sâu tăng lên, và biểu hiện lỗi huấn luyện cao hơn khi trở nên sâu hơn. Hiện tượng này tương tự như trên ImageNet (Hình 4, trái) và trên MNIST (xem [42]), cho thấy rằng khó khăn tối ưu hóa như vậy là một vấn đề cơ bản.
We compare , leading to 20, 32, 44, and 56-layer networks. Fig. 6 (left) shows the behaviors of the plain nets. The deep plain nets suffer from increased depth, and exhibit higher training error when going deeper. This phenomenon is similar to that on ImageNet (Fig. 4, left) and on MNIST (see [42]), suggesting that such an optimization difficulty is a fundamental problem.
Hình 6 (giữa) cho thấy hành vi của các ResNet. Tương tự như các trường hợp trên ImageNet (Hình 4, phải), các ResNet của chúng tôi vượt qua được khó khăn tối ưu hóa và thể hiện mức tăng độ chính xác khi độ sâu tăng lên.
Fig. 6 (middle) shows the behaviors of ResNets. Also similar to the ImageNet cases (Fig. 4, right), our ResNets manage to overcome the optimization difficulty and demonstrate accuracy gains when the depth increases.
Chúng tôi tiếp tục khảo sát , dẫn đến một ResNet 110 lớp. Trong trường hợp này, chúng tôi nhận thấy rằng tốc độ học ban đầu 0.1 hơi quá lớn để bắt đầu hội tụ1. Vì vậy, chúng tôi sử dụng 0.01 để khởi động quá trình huấn luyện cho đến khi lỗi huấn luyện nhỏ hơn 80% (khoảng 400 lần lặp), sau đó quay lại 0.1 và tiếp tục huấn luyện. Phần còn lại của lịch huấn luyện được thực hiện như trước đây. Mạng 110 lớp này hội tụ tốt (Fig. 6, giữa). Nó có ít hơn tham số so với các mạng sâu và mỏng khác
We further explore that leads to a 110-layer ResNet. In this case, we find that the initial learning rate of 0.1 is slightly too large to start converging1. So we use 0.01 to warm up the training until the training error is below 80% (about 400 iterations), and then go back to 0.1 and continue training. The rest of the learning schedule is as done previously. This 110-layer network converges well (Fig. 6, middle). It has fewer parameters than other deep and thin
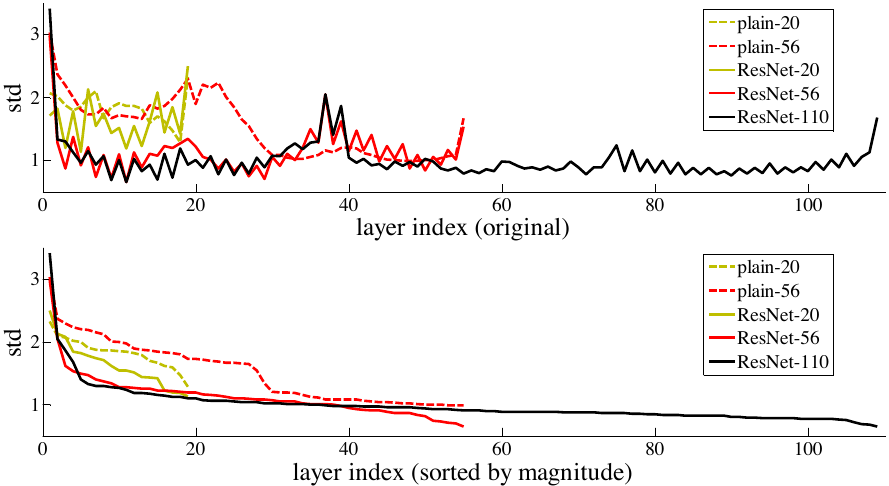
Phân tích các phản hồi lớp. Fig. 7 hiển thị độ lệch chuẩn (std) của các phản hồi lớp. Các phản hồi là đầu ra của mỗi lớp , sau BN và trước tính phi tuyến khác (ReLU/addition). Đối với ResNets, phân tích này cho thấy cường độ phản hồi của các hàm dư. Fig. 7 cho thấy ResNets nhìn chung có các phản hồi nhỏ hơn so với các mạng thông thường tương ứng. Các kết quả này ủng hộ động lực cơ bản của chúng tôi (Sec.3.1) rằng các hàm dư có thể thường gần bằng không hơn các hàm không dư. Chúng tôi cũng nhận thấy rằng ResNet sâu hơn có độ lớn phản hồi nhỏ hơn, được chứng minh qua các so sánh giữa ResNet-20, 56 và 110 trong Fig. 7. Khi có nhiều lớp hơn, một lớp riêng lẻ của ResNets có xu hướng thay đổi tín hiệu ít hơn.
Analysis of Layer Responses. Fig. 7 shows the standard deviations (std) of the layer responses. The responses are the outputs of each layer, after BN and before other nonlinearity (ReLU/addition). For ResNets, this analysis reveals the response strength of the residual functions. Fig. 7 shows that ResNets have generally smaller responses than their plain counterparts. These results support our basic motivation (Sec.3.1) that the residual functions might be generally closer to zero than the non-residual functions. We also notice that the deeper ResNet has smaller magnitudes of responses, as evidenced by the comparisons among ResNet-20, 56, and 110 in Fig. 7. When there are more layers, an individual layer of ResNets tends to modify the signal less.
Khảo sát trên 1000 lớp. Chúng tôi khảo sát một mô hình sâu mạnh mẽ có hơn 1000 lớp. Chúng tôi đặt , dẫn đến một mạng 1202 lớp, được huấn luyện như mô tả ở trên. Phương pháp của chúng tôi cho thấy không có khó khăn trong tối ưu hóa, và mạng lớp này có thể đạt được lỗi huấn luyện (Fig. 6, phải). Lỗi kiểm thử của nó vẫn khá tốt (7.93%, Table 6).
Exploring Over 1000 layers. We explore an aggressively deep model of over 1000 layers. We set that leads to a 1202-layer network, which is trained as described above. Our method shows no optimization difficulty, and this -layer network is able to achieve training error (Fig. 6, right). Its test error is still fairly good (7.93%, Table 6).
Tuy nhiên, vẫn còn các vấn đề mở đối với những mô hình sâu mạnh mẽ như vậy. Kết quả kiểm thử của mạng 1202 lớp này kém hơn so với mạng 110 lớp của chúng tôi, mặc dù cả hai
But there are still open problems on such aggressively deep models. The testing result of this 1202-layer network is worse than that of our 110-layer network, although both
| dữ liệu huấn luyện | 07+12 | 07++12 |
|---|---|---|
| dữ liệu kiểm thử | VOC 07 test | VOC 12 test |
| VGG-16 | 73.2 | 70.4 |
| ResNet-101 | 76.4 | 73.8 |
| training data | 07+12 | 07++12 |
|---|---|---|
| test data | VOC 07 test | VOC 12 test |
| VGG-16 | 73.2 | 70.4 |
| ResNet-101 | 76.4 | 73.8 |
Table 7. mAP (%) phát hiện đối tượng trên các tập kiểm thử PASCAL VOC 2007/2012 sử dụng đường cơ sở Faster R-CNN. Xem thêm Table 10 và 11 để có các kết quả tốt hơn.
Table 7. Object detection mAP (%) on the PASCAL VOC 2007/2012 test sets using baseline Faster R-CNN. See also Table 10 and 11 for better results.
| chỉ số | mAP@.5 | mAP@[.5, .95] |
|---|---|---|
| VGG-16 | 41.5 | 21.2 |
| ResNet-101 | 48.4 | 27.2 |
| metric | mAP@.5 | mAP@[.5, .95] |
|---|---|---|
| VGG-16 | 41.5 | 21.2 |
| ResNet-101 | 48.4 | 27.2 |
Table 8. mAP (%) phát hiện đối tượng trên tập xác thực COCO sử dụng đường cơ sở Faster R-CNN. Xem thêm Table 9 để có các kết quả tốt hơn.
Table 8. Object detection mAP (%) on the COCO validation set using baseline Faster R-CNN. See also Table 9 for better results.
có lỗi huấn luyện tương tự. Chúng tôi cho rằng điều này là do quá khớp. Mạng 1202 lớp có thể lớn không cần thiết (19.4M) đối với tập dữ liệu nhỏ này. Các kỹ thuật điều chuẩn mạnh như maxout [10] hoặc dropout [14] được áp dụng để thu được các kết quả tốt nhất ([10, 25, 24, 35]) trên tập dữ liệu này. Trong bài báo này, chúng tôi không sử dụng maxout/dropout và chỉ đơn giản áp đặt điều chuẩn thông qua các kiến trúc sâu và mỏng theo thiết kế, mà không làm phân tán trọng tâm khỏi những khó khăn trong tối ưu hóa. Tuy nhiên, việc kết hợp với điều chuẩn mạnh hơn có thể cải thiện kết quả, điều mà chúng tôi sẽ nghiên cứu trong tương lai.
have similar training error. We argue that this is because of overfitting. The 1202-layer network may be unnecessarily large (19.4M) for this small dataset. Strong regularization such as maxout [10] or dropout [14] is applied to obtain the best results ([10, 25, 24, 35]) on this dataset. In this paper, we use no maxout/dropout and just simply impose regularization via deep and thin architectures by design, without distracting from the focus on the difficulties of optimization. But combining with stronger regularization may improve results, which we will study in the future.
4.3. Phát hiện đối tượng trên PASCAL và MS COCO
4.3. Object Detection on PASCAL and MS COCO
Phương pháp của chúng tôi có hiệu năng tổng quát hóa tốt trên các tác vụ nhận dạng khác. Table 7 và 8 cho thấy các kết quả đường cơ sở phát hiện đối tượng trên PASCAL VOC 2007 và 2012 [5] và COCO [26]. Chúng tôi sử dụng Faster R-CNN [32] làm phương pháp phát hiện. Ở đây chúng tôi quan tâm đến những cải thiện khi thay thế VGG-16 [41] bằng ResNet-101. Cách triển khai phát hiện (xem phụ lục) khi sử dụng cả hai mô hình là giống nhau, do đó các cải thiện chỉ có thể được quy cho các mạng tốt hơn. Đáng chú ý nhất, trên tập dữ liệu COCO đầy thách thức, chúng tôi thu được mức tăng 6.0% trong chỉ số tiêu chuẩn của COCO (mAP@[.5, .95]), tương đương với cải thiện tương đối 28%. Sự cải thiện này hoàn toàn nhờ vào các biểu diễn đã học.
Our method has good generalization performance on other recognition tasks. Table 7 and 8 show the object detection baseline results on PASCAL VOC 2007 and 2012 [5] and COCO [26]. We adopt Faster R-CNN [32] as the detection method. Here we are interested in the improvements of replacing VGG-16 [41] with ResNet-101. The detection implementation (see appendix) of using both models is the same, so the gains can only be attributed to better networks. Most remarkably, on the challenging COCO dataset we obtain a 6.0% increase in COCO’s standard metric (mAP@[.5, .95]), which is a 28% relative improvement. This gain is solely due to the learned representations.
Dựa trên các mạng dư sâu, chúng tôi đã giành vị trí thứ 1 trong một số hạng mục tại các cuộc thi ILSVRC & COCO 2015: ImageNet detection, ImageNet localization, COCO detection, và COCO segmentation. Các chi tiết nằm trong phụ lục.
Based on deep residual nets, we won the 1st places in several tracks in ILSVRC & COCO 2015 competitions: ImageNet detection, ImageNet localization, COCO detection, and COCO segmentation. The details are in the appendix.
A Các đường cơ sở phát hiện đối tượng
A Object Detection Baselines
Trong phần này, chúng tôi giới thiệu phương pháp phát hiện dựa trên hệ thống đường cơ sở Faster R-CNN [32]. Các mô hình được khởi tạo bởi các mô hình phân loại ImageNet, sau đó được tinh chỉnh trên dữ liệu phát hiện đối tượng. Chúng tôi đã thử nghiệm với ResNet-50/101 vào thời điểm diễn ra các cuộc thi phát hiện ILSVRC & COCO 2015.
In this section we introduce our detection method based on the baseline Faster R-CNN [32] system. The models are initialized by the ImageNet classification models, and then fine-tuned on the object detection data. We have experimented with ResNet-50/101 at the time of the ILSVRC & COCO 2015 detection competitions.
Khác với VGG-16 được sử dụng trong [32], ResNet của chúng tôi không có các lớp fc ẩn. Chúng tôi áp dụng ý tưởng “Networks on Conv feature maps” (NoC) [33] để giải quyết vấn đề này. Chúng tôi tính toán các bản đồ đặc trưng conv được chia sẻ trên toàn ảnh bằng cách sử dụng các lớp có stride trên ảnh không lớn hơn 16 pixel (tức là conv1, conv2_x, conv3_x, và conv4_x, tổng cộng 91 lớp conv trong ResNet-101; Bảng 1). Chúng tôi xem các lớp này tương tự như 13 lớp conv trong VGG-16, và bằng cách này, cả ResNet và VGG-16 đều có các bản đồ đặc trưng conv với cùng stride tổng (16 pixel). Các lớp này được chia sẻ bởi một mạng đề xuất vùng (RPN, tạo ra 300 đề xuất) [32] và một mạng phát hiện Fast R-CNN [7]. RoI pooling [7] được thực hiện trước conv5_1. Trên đặc trưng được RoI-pooled này, tất cả các lớp của conv5_x trở lên được áp dụng cho từng vùng, đóng vai trò của các lớp fc của VGG-16. Lớp phân loại cuối cùng được thay thế bằng hai lớp song song (phân loại và hồi quy hộp [7]).
Unlike VGG-16 used in [32], our ResNet has no hidden fc layers. We adopt the idea of “Networks on Conv feature maps” (NoC) [33] to address this issue. We compute the full-image shared conv feature maps using those layers whose strides on the image are no greater than 16 pixels (i.e., conv1, conv2_x, conv3_x, and conv4_x, totally 91 conv layers in ResNet-101; Table 1). We consider these layers as analogous to the 13 conv layers in VGG-16, and by doing so, both ResNet and VGG-16 have conv feature maps of the same total stride (16 pixels). These layers are shared by a region proposal network (RPN, generating 300 proposals) [32] and a Fast R-CNN detection network [7]. RoI pooling [7] is performed before conv5_1. On this RoI-pooled feature, all layers of conv5_x and up are adopted for each region, playing the roles of VGG-16’s fc layers. The final classification layer is replaced by two sibling layers (classification and box regression [7]).
Đối với việc sử dụng các lớp BN, sau khi tiền huấn luyện, chúng tôi tính toán các thống kê BN (trung bình và phương sai) cho mỗi lớp trên tập huấn luyện ImageNet. Sau đó, các lớp BN được cố định trong quá trình tinh chỉnh cho phát hiện đối tượng. Như vậy, các lớp BN trở thành các kích hoạt tuyến tính với các độ lệch và tỷ lệ không đổi, và các thống kê BN không được cập nhật bởi quá trình tinh chỉnh. Chúng tôi cố định các lớp BN chủ yếu để giảm mức tiêu thụ bộ nhớ trong quá trình huấn luyện Faster R-CNN.
For the usage of BN layers, after pre-training, we compute the BN statistics (means and variances) for each layer on the ImageNet training set. Then the BN layers are fixed during fine-tuning for object detection. As such, the BN layers become linear activations with constant offsets and scales, and BN statistics are not updated by fine-tuning. We fix the BN layers mainly for reducing memory consumption in Faster R-CNN training.
PASCAL VOC
PASCAL VOC
Theo [7, 32], đối với tập test PASCAL VOC 2007, chúng tôi sử dụng 5k ảnh trainval trong VOC 2007 và 16k ảnh trainval trong VOC 2012 để huấn luyện (“07+12”). Đối với tập test PASCAL VOC 2012, chúng tôi sử dụng 10k ảnh trainval+test trong VOC 2007 và 16k ảnh trainval trong VOC 2012 để huấn luyện (“07++12”). Các siêu tham số cho việc huấn luyện Faster R-CNN giống như trong [32]. Bảng 7 cho thấy các kết quả. ResNet-101 cải thiện mAP hơn >3% so với VGG-16. Sự cải thiện này hoàn toàn là do các đặc trưng được cải thiện được học bởi ResNet.
Following [7, 32], for the PASCAL VOC 2007 test set, we use the 5k trainval images in VOC 2007 and 16k trainval images in VOC 2012 for training (“07+12”). For the PASCAL VOC 2012 test set, we use the 10k trainval+test images in VOC 2007 and 16k trainval images in VOC 2012 for training (“07++12”). The hyper-parameters for training Faster R-CNN are the same as in [32]. Table 7 shows the results. ResNet-101 improves the mAP by >3% over VGG-16. This gain is solely because of the improved features learned by ResNet.
MS COCO
MS COCO
Tập dữ liệu MS COCO [26] bao gồm 80 loại đối tượng. Chúng tôi đánh giá theo độ đo PASCAL VOC (mAP @ IoU = 0.5) và độ đo COCO tiêu chuẩn (mAP @ IoU = .5:.05:.95). Chúng tôi sử dụng 80k ảnh trong tập train để huấn luyện và 40k ảnh trong tập val để đánh giá. Hệ thống phát hiện của chúng tôi cho COCO tương tự như hệ thống cho PASCAL VOC. Chúng tôi huấn luyện các mô hình COCO bằng một triển khai 8-GPU, do đó bước RPN có kích thước mini-batch là 8 ảnh (i.e., 1 trên mỗi GPU) và bước Fast R-CNN có kích thước mini-batch là 16 ảnh. Bước RPN và bước Fast R-CNN đều được huấn luyện trong 240k vòng lặp với tốc độ học là 0.001 và sau đó trong 80k vòng lặp với 0.0001.
The MS COCO dataset [26] involves 80 object categories. We evaluate the PASCAL VOC metric (mAP @ IoU = 0.5) and the standard COCO metric (mAP @ IoU = .5:.05:.95). We use the 80k images on the train set for training and the 40k images on the val set for evaluation. Our detection system for COCO is similar to that for PASCAL VOC. We train the COCO models with an 8-GPU implementation, and thus the RPN step has a mini-batch size of 8 images (i.e., 1 per GPU) and the Fast R-CNN step has a mini-batch size of 16 images. The RPN step and Fast R-CNN step are both trained for 240k iterations with a learning rate of 0.001 and then for 80k iterations with 0.0001.
Bảng 8 cho thấy các kết quả trên tập kiểm thử MS COCO. ResNet-101 có mức tăng 6% của mAP@[.5, .95] so với VGG-16, tương đương với cải thiện tương đối 28%, hoàn toàn do các đặc trưng được học bởi mạng tốt hơn đóng góp. Đáng chú ý, mức tăng tuyệt đối của mAP@I.5, .95] (6.0%) gần lớn bằng mức tăng của mAP@.5 (6.9%). Điều này cho thấy một mạng sâu hơn có thể cải thiện cả nhận dạng và định vị.
Table 8 shows the results on the MS COCO validation set. ResNet-101 has a 6% increase of mAP@[.5, .95] over VGG-16, which is a 28% relative improvement, solely contributed by the features learned by the better network. Remarkably, the mAP@I.5, .95]’s absolute increase (6.0%) is nearly as big as mAP@.5’s (6.9%). This suggests that a deeper network can improve both recognition and localization.
B Cải thiện phát hiện đối tượng
B Object Detection Improvements
Để hoàn thiện, chúng tôi báo cáo các cải tiến được thực hiện cho các cuộc thi. Những cải tiến này dựa trên các đặc trưng sâu và do đó nên được hưởng lợi từ học dư.
For completeness, we report the improvements made for the competitions. These improvements are based on deep features and thus should benefit from residual learning.
MS COCO
MS COCO
\Tinh chỉnh hộp.\ Việc tinh chỉnh hộp của chúng tôi phần nào tuân theo định vị lặp trong [6]. Trong Faster R-CNN, đầu ra cuối cùng là một hộp được hồi quy, khác với hộp đề xuất của nó. Vì vậy, đối với suy luận, chúng tôi gom nhóm một đặc trưng mới từ hộp được hồi quy và thu được một điểm số phân loại mới cùng một hộp được hồi quy mới. Chúng tôi kết hợp 300 dự đoán mới này với 300 dự đoán ban đầu. Non-maximum suppression (NMS) được áp dụng trên tập hợp hợp nhất của các hộp được dự đoán bằng cách sử dụng ngưỡng IoU là 0.3 [8], tiếp theo là bỏ phiếu hộp [6]. Tinh chỉnh hộp cải thiện mAP khoảng 2 điểm (Bảng 9).
Box refinement. Our box refinement partially follows the iterative localization in [6]. In Faster R-CNN, the final output is a regressed box that is different from its proposal box. So for inference, we pool a new feature from the regressed box and obtain a new classification score and a new regressed box. We combine these 300 new predictions with the original 300 predictions. Non-maximum suppression (NMS) is applied on the union set of predicted boxes using an IoU threshold of 0.3 [8], followed by box voting [6]. Box refinement improves mAP by about 2 points (Table 9).
\Ngữ cảnh toàn cục.\ Chúng tôi kết hợp ngữ cảnh toàn cục trong bước Fast R-CNN. Với bản đồ đặc trưng conv của toàn bộ ảnh, chúng tôi gom nhóm một đặc trưng bằng Spatial Pyramid Pooling toàn cục [12] (với kim tự tháp “một mức”) có thể được triển khai như gom nhóm “RoI” bằng cách sử dụng hộp bao của toàn bộ ảnh làm RoI. Đặc trưng được gom nhóm này được đưa vào các lớp sau RoI để thu được một đặc trưng ngữ cảnh toàn cục. Đặc trưng toàn cục này được nối với đặc trưng ban đầu theo từng vùng, tiếp theo là các lớp phân loại song sinh và hồi quy hộp. Cấu trúc mới này được huấn luyện end-to-end. Ngữ cảnh toàn cục cải thiện mAP\@.5 khoảng 1 điểm (Bảng 9).
Global context. We combine global context in the Fast R-CNN step. Given the full-image conv feature map, we pool a feature by global Spatial Pyramid Pooling [12] (with a “single-level” pyramid) which can be implemented as “RoI” pooling using the entire image’s bounding box as the RoI. This pooled feature is fed into the post-RoI layers to obtain a global context feature. This global feature is concatenated with the original per-region feature, followed by the sibling classification and box regression layers. This new structure is trained end-to-end. Global context improves mAP@.5 by about 1 point (Table 9).
\Kiểm thử đa tỷ lệ.\ Trong phần trên, tất cả kết quả thu được bằng huấn luyện/kiểm thử đơn tỷ lệ như trong [32], trong đó cạnh ngắn hơn của ảnh là pixel. Huấn luyện/kiểm thử đa tỷ lệ đã được phát triển trong [12, 7] bằng cách chọn một tỷ lệ từ một kim tự tháp đặc trưng, và trong [33] bằng cách sử dụng các lớp maxout. Trong triển khai hiện tại, chúng tôi đã thực hiện \kiểm thử\ đa tỷ lệ theo [33]; chúng tôi chưa thực hiện huấn luyện đa tỷ lệ vì thời gian hạn chế. Ngoài ra, chúng tôi chỉ thực hiện kiểm thử đa tỷ lệ cho bước Fast R-CNN (nhưng chưa cho bước RPN). Với một mô hình đã được huấn luyện, chúng tôi tính toán các bản đồ đặc trưng conv trên một kim tự tháp ảnh, trong đó các cạnh ngắn hơn của ảnh là .
Multi-scale testing. In the above, all results are obtained by single-scale training/testing as in [32], where the image’s shorter side pixels. Multi-scale training/testing has been developed in [12, 7] by selecting a scale from a feature pyramid, and in [33] by using maxout layers. In our current implementation, we have performed multi-scale testing following [33]; we have not performed multi-scale training because of limited time. In addition, we have performed multi-scale testing only for the Fast R-CNN step (but not yet for the RPN step). With a trained model, we compute conv feature maps on an image pyramid, where the image’s shorter sides are .
              training data                           COCO train                COCO trainval
test data                               COCO val                  COCO test-dev
mAP                                     @.5      @[.5, .95]       @.5      @[.5, .95]
baseline Faster R-CNN (VGG-16)          41.5     21.2
baseline Faster R-CNN (ResNet-101)      48.4     27.2
+box refinement                         49.9     29.9
+context                                51.1     30.0             53.3     32.2
+multi-scale testing                    53.8     32.5             55.7     34.9
ensemble                                                     59.0     37.4
              training data                           COCO train                COCO trainval
test data                               COCO val                  COCO test-dev
mAP                                     @.5      @[.5, .95]       @.5      @[.5, .95]
baseline Faster R-CNN (VGG-16)          41.5     21.2
baseline Faster R-CNN (ResNet-101)      48.4     27.2
+box refinement                         49.9     29.9
+context                                51.1     30.0             53.3     32.2
+multi-scale testing                    53.8     32.5             55.7     34.9
ensemble                                                     59.0     37.4
Bảng 9. Các cải thiện phát hiện đối tượng trên MS COCO sử dụng Faster R-CNN và ResNet-101.
Table 9. Object detection improvements on MS COCO using Faster R-CNN and ResNet-101.
              system      net         data         mAP  areo  bike  bird  boat  bottle  bus  car  cat  chair  cow  table  dog  horse  mbike  person  plant  sheep  sofa  train  tv
baseline    VGG-16      07+12        73.2 76.5  79.0  70.9  65.5  52.1    83.1 84.7 86.4 52.0   81.9 65.7   84.8 84.6   77.5   76.7    38.8   73.6   73.9  83.0   72.6
baseline    ResNet-101  07+12        76.4 79.8  80.7  76.2  68.3  55.9    85.1 85.3 89.8 56.7   87.8 69.4   88.3 88.9   80.9   78.4    41.7   78.6   79.8  85.3   72.0
baseline+++ ResNet-101  COCO+07+12   85.6 90.0  89.6  87.8  80.8  76.1    89.9 89.9 89.6 75.5   90.0 80.7   89.6 90.3   89.1   88.7    65.4   88.1   85.6  89.0   86.8
              system      net         data         mAP  areo  bike  bird  boat  bottle  bus  car  cat  chair  cow  table  dog  horse  mbike  person  plant  sheep  sofa  train  tv
baseline    VGG-16      07+12        73.2 76.5  79.0  70.9  65.5  52.1    83.1 84.7 86.4 52.0   81.9 65.7   84.8 84.6   77.5   76.7    38.8   73.6   73.9  83.0   72.6
baseline    ResNet-101  07+12        76.4 79.8  80.7  76.2  68.3  55.9    85.1 85.3 89.8 56.7   87.8 69.4   88.3 88.9   80.9   78.4    41.7   78.6   79.8  85.3   72.0
baseline+++ ResNet-101  COCO+07+12   85.6 90.0  89.6  87.8  80.8  76.1    89.9 89.9 89.6 75.5   90.0 80.7   89.6 90.3   89.1   88.7    65.4   88.1   85.6  89.0   86.8
Bảng 10. Các kết quả phát hiện trên tập kiểm thử PASCAL VOC 2007. Đường cơ sở là hệ thống Faster R-CNN. Hệ thống “baseline+++” bao gồm tinh chỉnh hộp, ngữ cảnh và kiểm thử đa tỷ lệ trong Bảng 9.
Table 10. Detection results on the PASCAL VOC 2007 test set. The baseline is the Faster R-CNN system. The system “baseline+++” include box refinement, context, and multi-scale testing in Table 9.
              system      net         data         mAP  areo  bike  bird  boat  bottle  bus  car  cat  chair  cow  table  dog  horse  mbike  person  plant  sheep  sofa  train  tv
baseline    VGG-16      07++12       70.4 84.9  79.8  74.3  53.9  49.8    77.5 75.9 88.5 45.6   77.1 55.3   86.9 81.7   80.9   79.6    40.1   72.6   60.9  81.2   61.5
baseline    ResNet-101  07++12       73.8 86.5  81.6  77.2  58.0  51.0    78.6 76.6 93.2 48.6   80.4 59.0   92.1 85.3   84.8   80.7    48.1   77.3   66.5  84.7   65.6
baseline+++ ResNet-101  COCO+07++12  83.8 92.1  88.4  84.8  75.9  71.4    86.3 87.8 94.2 66.8   89.4 69.2   93.9 91.9   90.9   89.6    67.9   88.2   76.8  90.3   80.0
              system      net         data         mAP  areo  bike  bird  boat  bottle  bus  car  cat  chair  cow  table  dog  horse  mbike  person  plant  sheep  sofa  train  tv
baseline    VGG-16      07++12       70.4 84.9  79.8  74.3  53.9  49.8    77.5 75.9 88.5 45.6   77.1 55.3   86.9 81.7   80.9   79.6    40.1   72.6   60.9  81.2   61.5
baseline    ResNet-101  07++12       73.8 86.5  81.6  77.2  58.0  51.0    78.6 76.6 93.2 48.6   80.4 59.0   92.1 85.3   84.8   80.7    48.1   77.3   66.5  84.7   65.6
baseline+++ ResNet-101  COCO+07++12  83.8 92.1  88.4  84.8  75.9  71.4    86.3 87.8 94.2 66.8   89.4 69.2   93.9 91.9   90.9   89.6    67.9   88.2   76.8  90.3   80.0
Bảng 11. Các kết quả phát hiện trên tập kiểm thử PASCAL VOC 2012 (http://host.robots.ox.ac.uk:8080/leaderboard/displaylb.php?challengeid=11&compid=4). Đường cơ sở là hệ thống Faster R-CNN. Hệ thống “baseline+++” bao gồm tinh chỉnh hộp, ngữ cảnh và kiểm thử đa tỷ lệ trong Bảng 9.
Table 11. Detection results on the PASCAL VOC 2012 test set (http://host.robots.ox.ac.uk:8080/leaderboard/displaylb.php?challengeid=11&compid=4). The baseline is the Faster R-CNN system. The system “baseline+++” include box refinement, context, and multi-scale testing in Table 9.
\Sử dụng dữ liệu xác thực.\ Tiếp theo, chúng tôi sử dụng tập trainval 80k+40k để huấn luyện và tập test-dev 20k để đánh giá. Tập test-dev không có ground truth công khai và kết quả được báo cáo bởi server đánh giá. Trong thiết lập này, các kết quả là mAP\@.5 là 55.7% và mAP@[.5, .95] là 34.9% (Bảng 9). Đây là kết quả của mô hình đơn của chúng tôi.
Using validation data. Next we use the 80k+40k trainval set for training and the 20k test-dev set for evaluation. The test-dev set has no publicly available ground truth and the result is reported by the evaluation server. Under this setting, the results are an mAP@.5 of 55.7% and an mAP@[.5, .95] of 34.9% (Table 9). This is our single-model result.
\Tổ hợp.\ Trong Faster R-CNN, hệ thống được thiết kế để học các đề xuất vùng và cả các bộ phân loại đối tượng, vì vậy một tổ hợp có thể được sử dụng để tăng cường cả hai tác vụ. Chúng tôi sử dụng một tổ hợp để đề xuất vùng, và tập hợp hợp nhất của các đề xuất được xử lý bởi một tổ hợp các bộ phân loại theo từng vùng. Bảng 9 cho thấy kết quả của chúng tôi dựa trên một tổ hợp gồm 3 mạng. mAP là 59.0% và 37.4% trên tập test-dev. \Kết quả này giành vị trí thứ 1 trong tác vụ phát hiện trong COCO 2015.\
Ensemble. In Faster R-CNN, the system is designed to learn region proposals and also object classifiers, so an ensemble can be used to boost both tasks. We use an ensemble for proposing regions, and the union set of proposals are processed by an ensemble of per-region classifiers. Table 9 shows our result based on an ensemble of 3 networks. The mAP is 59.0% and 37.4% on the test-dev set. This result won the 1st place in the detection task in COCO 2015.
PASCAL VOC
PASCAL VOC
Chúng tôi xem xét lại tập dữ liệu PASCAL VOC dựa trên mô hình ở trên. Với mô hình đơn trên tập dữ liệu COCO (55.7% mAP\@.5 trong Table 9), chúng tôi tinh chỉnh mô hình này trên các tập PASCAL VOC. Các cải tiến về tinh chỉnh hộp, ngữ cảnh và kiểm thử đa tỷ lệ cũng được áp dụng. Bằng cách này
We revisit the PASCAL VOC dataset based on the above model. With the single model on the COCO dataset (55.7% mAP@.5 in Table 9), we fine-tune this model on the PASCAL VOC sets. The improvements of box refinement, context, and multi-scale testing are also adopted. By doing so
                                                 val2   test
GoogLeNet [44] (ILSVRC’14)         -      43.9
our single model (ILSVRC’15)       60.5   58.8
our ensemble (ILSVRC’15)           63.6   62.1
                                                 val2   test
GoogLeNet [44] (ILSVRC’14)         -      43.9
our single model (ILSVRC’15)       60.5   58.8
our ensemble (ILSVRC’15)           63.6   62.1
Table 12. Các kết quả của chúng tôi (mAP, %) trên tập dữ liệu phát hiện ImageNet. Hệ thống phát hiện của chúng tôi là Faster R-CNN [32] với các cải tiến trong Table 9, sử dụng ResNet-101.
Table 12. Our results (mAP, %) on the ImageNet detection dataset. Our detection system is Faster R-CNN [32] with the improvements in Table 9, using ResNet-101.
Phát hiện ImageNet
ImageNet Detection
Tác vụ Phát hiện ImageNet (DET) bao gồm 200 loại đối tượng. Độ chính xác được đánh giá bằng mAP\@.5. Thuật toán phát hiện đối tượng ImageNet DET của chúng tôi giống với thuật toán dành cho MS COCO trong Table 9. Các mạng được huấn luyện trước trên tập phân loại ImageNet 1000 lớp, và được tinh chỉnh trên dữ liệu DET. Chúng tôi chia tập xác thực thành hai phần (val1/val2) theo [8]. Chúng tôi tinh chỉnh các mô hình phát hiện bằng cách sử dụng tập huấn luyện DET và tập val1. Tập val2 được sử dụng để xác thực. Chúng tôi không sử dụng dữ liệu ILSVRC 2015 khác. Mô hình đơn của chúng tôi với ResNet-101 có
The ImageNet Detection (DET) task involves 200 object categories. The accuracy is evaluated by mAP@.5. Our object detection algorithm for ImageNet DET is the same as that for MS COCO in Table 9. The networks are pre-trained on the 1000-class ImageNet classification set, and are fine-tuned on the DET data. We split the validation set into two parts (val1/val2) following [8]. We fine-tune the detection models using the DET training set and the val1 set. The val2 set is used for validation. We do not use other ILSVRC 2015 data. Our single model with ResNet-101 has
              LOC         LOC         testing   LOC error   classification   top-5 LOC error
method      network               on GT CLS   network          on predicted CLS

VGG’s [41]  VGG-16      1-crop    33.1 [41]
RPN         ResNet-101  1-crop    13.3
RPN         ResNet-101  dense     11.7

RPN         ResNet-101  dense                  ResNet-101      14.4
RPN+RCNN    ResNet-101  dense                  ResNet-101      10.6
RPN+RCNN    ensemble    dense                  ensemble        8.9
              LOC         LOC         testing   LOC error   classification   top-5 LOC error
method      network               on GT CLS   network          on predicted CLS

VGG’s [41]  VGG-16      1-crop    33.1 [41]
RPN         ResNet-101  1-crop    13.3
RPN         ResNet-101  dense     11.7

RPN         ResNet-101  dense                  ResNet-101      14.4
RPN+RCNN    ResNet-101  dense                  ResNet-101      10.6
RPN+RCNN    ensemble    dense                  ensemble        8.9
Table 13. Lỗi định vị (%) trên tập xác thực ImageNet. Trong cột “LOC error on GT class” ([41]), lớp chân lý thực được sử dụng. Trong cột “testing”, “1-crop” biểu thị kiểm thử trên một crop trung tâm gồm 224×224 pixel, “dense” biểu thị kiểm thử dày đặc (hoàn toàn tích chập) và đa tỷ lệ.
Table 13. Localization error (%) on the ImageNet validation. In the column of “LOC error on GT class” ([41]), the ground truth class is used. In the “testing” column, “1-crop” denotes testing on a center crop of 224×224 pixels, “dense” denotes dense (fully convolutional) and multi-scale testing.
58.8% mAP và tổ hợp của 3 mô hình của chúng tôi có 62.1% mAP trên tập kiểm thử DET (Table 12). Kết quả này giành vị trí thứ 1 trong tác vụ phát hiện ImageNet tại ILSVRC 2015, vượt qua vị trí thứ hai 8.5 điểm (tuyệt đối).
58.8% mAP and our ensemble of 3 models has 62.1% mAP on the DET test set (Table 12). This result won the 1st place in the ImageNet detection task in ILSVRC 2015, surpassing the second place by 8.5 points (absolute).
C Bản địa hóa ImageNet
C ImageNet Localization
Nhiệm vụ Bản địa hóa ImageNet (LOC) [36] yêu cầu phân loại và định vị các đối tượng. Theo [40, 41], chúng tôi giả định rằng các bộ phân loại ở mức ảnh trước tiên được sử dụng để dự đoán các nhãn lớp của một ảnh, và thuật toán bản địa hóa chỉ chịu trách nhiệm dự đoán các hộp bao quanh dựa trên các lớp đã dự đoán. Chúng tôi áp dụng chiến lược “hồi quy theo từng lớp” (PCR) [40, 41], học một bộ hồi quy hộp bao quanh cho mỗi lớp. Chúng tôi huấn luyện trước các mạng cho phân loại ImageNet rồi tinh chỉnh chúng cho bản địa hóa. Chúng tôi huấn luyện các mạng trên tập huấn luyện ImageNet 1000 lớp được cung cấp.
The ImageNet Localization (LOC) task [36] requires to classify and localize the objects. Following [40, 41], we assume that the image-level classifiers are first adopted for predicting the class labels of an image, and the localization algorithm only accounts for predicting bounding boxes based on the predicted classes. We adopt the “per-class regression” (PCR) strategy [40, 41], learning a bounding box regressor for each class. We pre-train the networks for ImageNet classification and then fine-tune them for localization. We train networks on the provided 1000-class ImageNet training set.
Thuật toán bản địa hóa của chúng tôi dựa trên khung RPN của [32] với một vài sửa đổi. Khác với cách trong [32] vốn không phụ thuộc danh mục, RPN của chúng tôi cho bản địa hóa được thiết kế dưới dạng theo từng lớp. RPN này kết thúc bằng hai lớp tích chập 1×1 song sinh cho phân loại nhị phân (cls) và hồi quy hộp (reg), như trong [32]. Các lớp cls và reg đều ở dạng theo từng lớp, trái ngược với [32]. Cụ thể, lớp cls có đầu ra 1000-d, và mỗi chiều là hồi quy logistic nhị phân để dự đoán có phải là một lớp đối tượng hay không; lớp reg có đầu ra 1000×4-d bao gồm các bộ hồi quy hộp cho 1000 lớp. Như trong [32], hồi quy hộp bao quanh của chúng tôi tham chiếu đến nhiều hộp “neo” bất biến theo phép dịch tại mỗi vị trí.
Our localization algorithm is based on the RPN framework of [32] with a few modifications. Unlike the way in [32] that is category-agnostic, our RPN for localization is designed in a per-class form. This RPN ends with two sibling 1×1 convolutional layers for binary classification (cls) and box regression (reg), as in [32]. The cls and reg layers are both in a per-class from, in contrast to [32]. Specifically, the cls layer has a 1000-d output, and each dimension is binary logistic regression for predicting being or not being an object class; the reg layer has a 1000×4-d output consisting of box regressors for 1000 classes. As in [32], our bounding box regression is with reference to multiple translation-invariant “anchor” boxes at each position.
Giống như quá trình huấn luyện phân loại ImageNet của chúng tôi (Sec. 3.4), chúng tôi lấy mẫu ngẫu nhiên các vùng cắt 224×224 để tăng cường dữ liệu. Chúng tôi sử dụng kích thước lô nhỏ 256 ảnh để tinh chỉnh. Để tránh các mẫu âm chiếm ưu thế, 8 neo được lấy mẫu ngẫu nhiên cho mỗi ảnh, trong đó các neo dương và âm được lấy mẫu có tỷ lệ 1:1 [32]. Để kiểm thử, mạng được áp dụng trên toàn bộ ảnh theo cách tích chập đầy đủ.
As in our ImageNet classification training (Sec. 3.4), we randomly sample 224×224 crops for data augmentation. We use a mini-batch size of 256 images for fine-tuning. To avoid negative samples being dominate, 8 anchors are randomly sampled for each image, where the sampled positive and negative anchors have a ratio of 1:1 [32]. For testing, the network is applied on the image fully-convolutionally.
Bảng 13 so sánh các kết quả bản địa hóa. Theo [41], trước tiên chúng tôi thực hiện kiểm thử “oracle” bằng cách sử dụng lớp đúng theo thực tế làm dự đoán phân loại. Bài báo của VGG [41] báo cáo lỗi cắt trung tâm là 33.1% (Bảng 13) khi sử dụng các lớp đúng theo thực tế. Với cùng thiết lập, phương pháp RPN của chúng tôi sử dụng mạng ResNet-101 giảm đáng kể lỗi cắt trung tâm xuống còn 13.3%. So sánh này chứng minh hiệu năng xuất sắc của khung của chúng tôi. Với kiểm thử dày đặc (tích chập đầy đủ) và đa tỷ lệ, ResNet-101 của chúng tôi có lỗi 11.7% khi sử dụng các lớp đúng theo thực tế. Sử dụng ResNet-101 để dự đoán các lớp (lỗi phân loại top-5 4.6%, Bảng 4), lỗi bản địa hóa top-5 là 14.4%.
Table 13 compares the localization results. Following [41], we first perform “oracle” testing using the ground truth class as the classification prediction. VGG’s paper [41] reports a center-crop error of 33.1% (Table 13) using ground truth classes. Under the same setting, our RPN method using ResNet-101 net significantly reduces the center-crop error to 13.3%. This comparison demonstrates the excellent performance of our framework. With dense (fully convolutional) and multi-scale testing, our ResNet-101 has an error of 11.7% using ground truth classes. Using ResNet-101 for predicting classes (4.6% top-5 classification error, Table 4), the top-5 localization error is 14.4%.
              method                         top-5 localization err
                               val     test
OverFeat [40] (ILSVRC’13)      30.0    29.9
GoogLeNet [44] (ILSVRC’14)     -       26.7
VGG [41] (ILSVRC’14)           26.9    25.3
ours (ILSVRC’15)               8.9     9.0
              method                         top-5 localization err
                               val     test
OverFeat [40] (ILSVRC’13)      30.0    29.9
GoogLeNet [44] (ILSVRC’14)     -       26.7
VGG [41] (ILSVRC’14)           26.9    25.3
ours (ILSVRC’15)               8.9     9.0
Bảng 14. So sánh lỗi bản địa hóa (%) trên tập dữ liệu ImageNet với các phương pháp hiện đại nhất.
Table 14. Comparisons of localization error (%) on the ImageNet dataset with state-of-the-art methods.
Các kết quả trên chỉ dựa trên mạng đề xuất (RPN) trong Faster R-CNN [32]. Có thể sử dụng mạng phát hiện (Fast R-CNN [7]) trong Faster R-CNN để cải thiện kết quả. Tuy nhiên, chúng tôi nhận thấy rằng trên tập dữ liệu này, một ảnh thường chứa một đối tượng chi phối duy nhất, và các vùng đề xuất chồng lấn nhiều với nhau nên có các đặc trưng RoI-pooled rất tương tự. Do đó, việc huấn luyện lấy ảnh làm trung tâm của Fast R-CNN [7] tạo ra các mẫu có biến thiên nhỏ, điều này có thể không mong muốn đối với huấn luyện ngẫu nhiên. Dựa trên động lực này, trong thí nghiệm hiện tại, chúng tôi sử dụng R-CNN gốc [8] vốn lấy RoI làm trung tâm, thay cho Fast R-CNN.
The above results are only based on the proposal network (RPN) in Faster R-CNN [32]. One may use the detection network (Fast R-CNN [7]) in Faster R-CNN to improve the results. But we notice that on this dataset, one image usually contains a single dominate object, and the proposal regions highly overlap with each other and thus have very similar RoI-pooled features. As a result, the image-centric training of Fast R-CNN [7] generates samples of small variations, which may not be desired for stochastic training. Motivated by this, in our current experiment we use the original R-CNN [8] that is RoI-centric, in place of Fast R-CNN.
Cài đặt R-CNN của chúng tôi như sau. Chúng tôi áp dụng RPN theo từng lớp được huấn luyện như trên vào các ảnh huấn luyện để dự đoán các hộp bao quanh cho lớp đúng theo thực tế. Các hộp được dự đoán này đóng vai trò là các đề xuất phụ thuộc lớp. Với mỗi ảnh huấn luyện, 200 đề xuất có điểm số cao nhất được trích xuất làm các mẫu huấn luyện để huấn luyện bộ phân loại R-CNN. Vùng ảnh được cắt từ một đề xuất, biến dạng thành 224×224 pixel, và đưa vào mạng phân loại như trong R-CNN [8]. Các đầu ra của mạng này bao gồm hai lớp fc song sinh cho cls và reg, cũng ở dạng theo từng lớp. Mạng R-CNN này được tinh chỉnh trên tập huấn luyện bằng cách sử dụng kích thước lô nhỏ 256 theo cách lấy RoI làm trung tâm. Để kiểm thử, RPN tạo ra 200 đề xuất có điểm số cao nhất cho mỗi lớp được dự đoán, và mạng R-CNN được sử dụng để cập nhật điểm số và vị trí hộp của các đề xuất này.
Our R-CNN implementation is as follows. We apply the per-class RPN trained as above on the training images to predict bounding boxes for the ground truth class. These predicted boxes play a role of class-dependent proposals. For each training image, the highest scored 200 proposals are extracted as training samples to train an R-CNN classifier. The image region is cropped from a proposal, warped to 224×224 pixels, and fed into the classification network as in R-CNN [8]. The outputs of this network consist of two sibling fc layers for cls and reg, also in a per-class form. This R-CNN network is fine-tuned on the training set using a mini-batch size of 256 in the RoI-centric fashion. For testing, the RPN generates the highest scored 200 proposals for each predicted class, and the R-CNN network is used to update these proposals’ scores and box positions.
Phương pháp này giảm lỗi bản địa hóa top-5 xuống còn 10.6% (Bảng 13). Đây là kết quả của mô hình đơn lẻ của chúng tôi trên tập xác thực. Sử dụng một tổ hợp các mạng cho cả phân loại và bản địa hóa, chúng tôi đạt được lỗi bản địa hóa top-5 là 9.0% trên tập kiểm thử. Con số này vượt trội đáng kể so với các kết quả ILSVRC 14 (Bảng 14), cho thấy mức giảm lỗi tương đối 64%. Kết quả này giành vị trí thứ 1 trong nhiệm vụ bản địa hóa ImageNet tại ILSVRC 2015.
This method reduces the top-5 localization error to 10.6% (Table 13). This is our single-model result on the validation set. Using an ensemble of networks for both classification and localization, we achieve a top-5 localization error of 9.0% on the test set. This number significantly outperforms the ILSVRC 14 results (Table 14), showing a 64% relative reduction of error. This result won the 1st place in the ImageNet localization task in ILSVRC 2015.
Notes
- http://host.robots.ox.ac.uk:8080/anonymous/3OJ4OJ.html, được gửi vào ngày 2015-11-26.
References
- Y. Bengio, P. Simard, and P. Frasconi. Learning long-term dependencies with gradient descent is difficult. *IEEE Transactions on Neural Networks*, 5(2):157–166, 1994.
- C. M. Bishop. *Neural networks for pattern recognition*. Oxford university press, 1995.
- W. L. Briggs, S. F. McCormick, et al. *A Multigrid Tutorial*. Siam, 2000.
- K. Chatfield, V. Lempitsky, A. Vedaldi, and A. Zisserman. The devil is in the details: an evaluation of recent feature encoding methods. In *BMVC*, 2011.
- M. Everingham, L. Van Gool, C. K. Williams, J. Winn, and A. Zisserman. The Pascal Visual Object Classes (VOC) Challenge. *IJCV*, pages 303–338, 2010.
- S. Gidaris and N. Komodakis. Object detection via a multi-region & semantic segmentation-aware cnn model. In *ICCV*, 2015.
- R. Girshick. Fast R-CNN. In *ICCV*, 2015.
- R. Girshick, J. Donahue, T. Darrell, and J. Malik. Rich feature hierarchies for accurate object detection and semantic segmentation. In *CVPR*, 2014.
- X. Glorot and Y. Bengio. Understanding the difficulty of training deep feedforward neural networks. In *AISTATS*, 2010.
- I. J. Goodfellow, D. Warde-Farley, M. Mirza, A. Courville, and Y. Bengio. Maxout networks. *arXiv:1302.4389*, 2013.
- K. He and J. Sun. Convolutional neural networks at constrained time cost. In *CVPR*, 2015.
- K. He, X. Zhang, S. Ren, and J. Sun. Spatial pyramid pooling in deep convolutional networks for visual recognition. In *ECCV*, 2014.
- K. He, X. Zhang, S. Ren, and J. Sun. Delving deep into rectifiers: Surpassing human-level performance on imagenet classification. In *ICCV*, 2015.
- G. E. Hinton, N. Srivastava, A. Krizhevsky, I. Sutskever, and R. R. Salakhutdinov. Improving neural networks by preventing co-adaptation of feature detectors. *arXiv:1207.0580*, 2012.
- S. Hochreiter and J. Schmidhuber. Long short-term memory. *Neural computation*, 9(8):1735–1780, 1997. Read it here
- S. Ioffe and C. Szegedy. Batch normalization: Accelerating deep network training by reducing internal covariate shift. In *ICML*, 2015.
- H. Jegou, M. Douze, and C. Schmid. Product quantization for nearest neighbor search. *TPAMI*, 33, 2011.
- H. Jegou, F. Perronnin, M. Douze, J. Sanchez, P. Perez, and C. Schmid. Aggregating local image descriptors into compact codes. *TPAMI*, 2012.
- Y. Jia, E. Shelhamer, J. Donahue, S. Karayev, J. Long, R. Girshick, S. Guadarrama, and T. Darrell. Caffe: Convolutional architecture for fast feature embedding. *arXiv:1408.5093*, 2014.
- A. Krizhevsky. Learning multiple layers of features from tiny images. *Tech Report*, 2009.
- A. Krizhevsky, I. Sutskever, and G. Hinton. Imagenet classification with deep convolutional neural networks. In *NIPS*, 2012. Read it here
- Y. LeCun, B. Boser, J. S. Denker, D. Henderson, R. E. Howard, W. Hubbard, and L. D. Jackel. Backpropagation applied to handwritten zip code recognition. *Neural computation*, 1989.
- Y. LeCun, L. Bottou, G. B. Orr, and K.-R. Müller. Efficient backprop. In *Neural Networks: Tricks of the Trade*, pages 9–50. Springer, 1998.
- C.-Y. Lee, S. Xie, P. Gallagher, Z. Zhang, and Z. Tu. Deeply-supervised nets. *arXiv:1409.5185*, 2014.
- M. Lin, Q. Chen, and S. Yan. Network in network. *arXiv:1312.4400*, 2013.
- T.-Y. Lin, M. Maire, S. Belongie, J. Hays, P. Perona, D. Ramanan, P. Dollár, and C. L. Zitnick. Microsoft COCO: Common objects in context. In *ECCV*. 2014.
- J. Long, E. Shelhamer, and T. Darrell. Fully convolutional networks for semantic segmentation. In *CVPR*, 2015.
- G. Montúfar, R. Pascanu, K. Cho, and Y. Bengio. On the number of linear regions of deep neural networks. In *NIPS*, 2014.
- V. Nair and G. E. Hinton. Rectified linear units improve restricted boltzmann machines. In *ICML*, 2010.
- F. Perronnin and C. Dance. Fisher kernels on visual vocabularies for image categorization. In *CVPR*, 2007.
- T. Raiko, H. Valpola, and Y. LeCun. Deep learning made easier by linear transformations in perceptrons. In *AISTATS*, 2012.
- S. Ren, K. He, R. Girshick, and J. Sun. Faster R-CNN: Towards real-time object detection with region proposal networks. In *NIPS*, 2015.
- S. Ren, K. He, R. Girshick, X. Zhang, and J. Sun. Object detection networks on convolutional feature maps. *arXiv:1504.06066*, 2015.
- B. D. Ripley. *Pattern recognition and neural networks*. Cambridge university press, 1996.
- A. Romero, N. Ballas, S. E. Kahou, A. Chassang, C. Gatta, and Y. Bengio. Fitnets: Hints for thin deep nets. In *ICLR*, 2015.
- O. Russakovsky, J. Deng, H. Su, J. Krause, S. Satheesh, S. Ma, Z. Huang, A. Karpathy, A. Khosla, M. Bernstein, et al. Imagenet large scale visual recognition challenge. *arXiv:1409.0575*, 2014.
- A. M. Saxe, J. L. McClelland, and S. Ganguli. Exact solutions to the nonlinear dynamics of learning in deep linear neural networks. *arXiv:1312.6120*, 2013.
- N. N. Schraudolph. Accelerated gradient descent by factor-centering decomposition. Technical report, 1998.
- N. N. Schraudolph. Centering neural network gradient factors. In *Neural Networks: Tricks of the Trade*, pages 207–226. Springer, 1998.
- P. Sermanet, D. Eigen, X. Zhang, M. Mathieu, R. Fergus, and Y. LeCun. Overfeat: Integrated recognition, localization and detection using convolutional networks. In *ICLR*, 2014.
- K. Simonyan and A. Zisserman. Very deep convolutional networks for large-scale image recognition. In *ICLR*, 2015.
- R. K. Srivastava, K. Greff, and J. Schmidhuber. Highway networks. *arXiv:1505.00387*, 2015.
- R. K. Srivastava, K. Greff, and J. Schmidhuber. Training very deep networks. *1507.06228*, 2015.
- C. Szegedy, W. Liu, Y. Jia, P. Sermanet, S. Reed, D. Anguelov, D. Erhan, V. Vanhoucke, and A. Rabinovich. Going deeper with convolutions. In *CVPR*, 2015.
- R. Szeliski. Fast surface interpolation using hierarchical basis functions. *TPAMI*, 1990.
- R. Szeliski. Locally adapted hierarchical basis preconditioning. In *SIGGRAPH*, 2006.
- T. Vatanen, T. Raiko, H. Valpola, and Y. LeCun. Pushing stochastic gradient towards second-order methods-backpropagation learning with transformations in nonlinearities. In *Neural Information Processing*, 2013.
- A. Vedaldi and B. Fulkerson. VLFeat: An open and portable library of computer vision algorithms, 2008.
- W. Venables and B. Ripley. Modern applied statistics with s-plus. 1999.
- M. D. Zeiler and R. Fergus. Visualizing and understanding convolutional neural networks. In *ECCV*, 2014.
Read off the page by a vision model reading the page images using gpt-5. Translated into Tiếng Việt by gpt-5, against glossary version 6. Translated from the English.
Read off the page by a vision model reading the page images using gpt-5.