Học từ chuỗi sang chuỗi với mạng nơ-ron (neural network)
Ilya Sutskever Google ilyasu@google.com
Oriol Vinyals Google vinyals@google.com
Quoc V. Le Google qvl@google.com
Tóm tắt
Mạng nơ-ron sâu (Deep Neural Networks, DNNs) là những mô hình mạnh đã đạt hiệu năng xuất sắc trên các tác vụ học khó. Mặc dù DNN hoạt động tốt khi có sẵn các tập huấn luyện lớn đã được gán nhãn, chúng không thể được dùng để ánh xạ chuỗi sang chuỗi. Trong bài báo này, chúng tôi trình bày một cách tiếp cận đầu cuối (end-to-end) tổng quát cho việc học chuỗi, với rất ít giả định về cấu trúc chuỗi. Phương pháp của chúng tôi sử dụng một mạng bộ nhớ dài-ngắn hạn (Long Short-Term Memory, LSTM) nhiều lớp để ánh xạ chuỗi đầu vào thành một vectơ có số chiều cố định, rồi dùng một LSTM sâu khác để giải mã chuỗi đích từ vectơ đó. Kết quả chính của chúng tôi là trên tác vụ dịch từ tiếng Anh sang tiếng Pháp của tập dữ liệu WMT’14, các bản dịch do LSTM tạo ra đạt điểm số BLEU là 34.8 trên toàn bộ tập kiểm thử, trong đó điểm số BLEU của LSTM bị trừ đối với các từ ngoài từ vựng. Ngoài ra, LSTM không gặp khó khăn với các câu dài. Để so sánh, một hệ thống dịch máy thống kê dựa trên cụm từ (SMT) đạt điểm số BLEU là 33.3 trên cùng tập dữ liệu. Khi chúng tôi dùng LSTM để xếp hạng lại 1000 giả thuyết do hệ thống SMT nói trên tạo ra, điểm số BLEU của hệ thống tăng lên 36.5, gần với kết quả tốt nhất trước đó trên tác vụ này. LSTM cũng học được các biểu diễn cụm từ và câu hợp lý, nhạy với thứ tự từ và tương đối bất biến đối với thể chủ động và thể bị động. Cuối cùng, chúng tôi nhận thấy rằng việc đảo ngược thứ tự từ trong tất cả các câu nguồn (nhưng không đảo trong các câu đích) cải thiện rõ rệt hiệu năng của LSTM, vì thao tác này tạo ra nhiều phụ thuộc ngắn hạn giữa câu nguồn và câu đích, giúp bài toán tối ưu hóa trở nên dễ hơn.
1 Giới thiệu
Mạng nơ-ron sâu (DNN) là các mô hình học máy cực kỳ mạnh mẽ đạt được hiệu năng xuất sắc trên các bài toán khó như nhận dạng giọng nói [13, 7] và nhận dạng đối tượng trực quan [19], [6], [21], [20]. DNN mạnh mẽ bởi vì chúng có thể thực hiện tính toán song song tùy ý trong một số lượng bước vừa phải. Một ví dụ đáng ngạc nhiên về sức mạnh của DNN là khả năng sắp xếp số -bit chỉ sử dụng 2 lớp ẩn có kích thước bậc hai [27]. Vì vậy, mặc dù mạng nơ-ron có liên quan đến các mô hình thống kê thông thường, chúng học một phép tính phức tạp. Hơn nữa, các DNN lớn có thể được huấn luyện bằng lan truyền ngược có giám sát bất cứ khi nào tập huấn luyện được gán nhãn có đủ thông tin để đặc tả các tham số của mạng. Do đó, nếu tồn tại một thiết lập tham số của một DNN lớn đạt được kết quả tốt (ví dụ, bởi vì con người có thể giải quyết nhiệm vụ rất nhanh), lan truyền ngược có giám sát sẽ tìm ra các tham số này và giải quyết bài toán.
Mặc dù có tính linh hoạt và sức mạnh, DNN chỉ có thể được áp dụng cho các bài toán mà đầu vào và mục tiêu có thể được mã hóa hợp lý bằng các vectơ có số chiều cố định. Đây là một hạn chế đáng kể, vì nhiều bài toán quan trọng được biểu diễn tốt nhất bằng các chuỗi có độ dài không được biết trước. Ví dụ, nhận dạng giọng nói và dịch máy là các bài toán tuần tự. Tương tự, hỏi đáp cũng có thể được xem như ánh xạ một chuỗi các từ biểu diễn câu hỏi thành một chuỗi các từ biểu diễn câu trả lời. Vì vậy, rõ ràng rằng một phương pháp độc lập với miền học cách ánh xạ chuỗi sang chuỗi sẽ hữu ích.
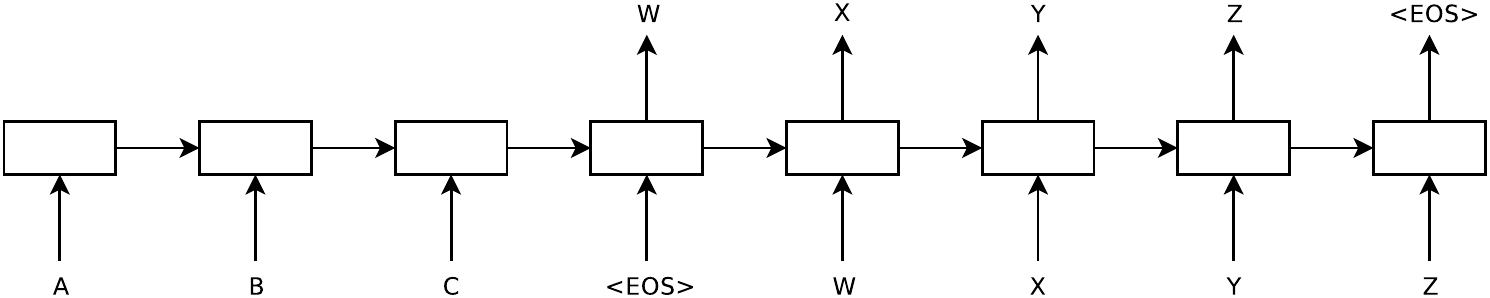
Các chuỗi đặt ra một thách thức cho DNN vì chúng yêu cầu số chiều của đầu vào và đầu ra phải được biết và cố định. Trong bài báo này, chúng tôi chỉ ra rằng việc áp dụng trực tiếp kiến trúc Long Short-Term Memory (LSTM) [16] có thể giải quyết các bài toán chuỗi sang chuỗi tổng quát. Ý tưởng là sử dụng một LSTM để đọc chuỗi đầu vào, từng bước thời gian một, để thu được biểu diễn vectơ có số chiều cố định lớn, sau đó sử dụng một LSTM khác để trích xuất chuỗi đầu ra từ vectơ đó (hình 1). LSTM thứ hai về cơ bản là một mô hình ngôn ngữ mạng nơ-ron hồi quy [28], [23], [30] ngoại trừ việc nó được điều kiện hóa trên chuỗi đầu vào. Khả năng của LSTM trong việc học thành công trên dữ liệu có các phụ thuộc thời gian phạm vi dài khiến nó trở thành lựa chọn tự nhiên cho ứng dụng này do độ trễ thời gian đáng kể giữa các đầu vào và các đầu ra tương ứng của chúng (hình 1).
Đã có một số nỗ lực liên quan nhằm giải quyết bài toán học chuỗi sang chuỗi tổng quát bằng mạng nơ-ron. Phương pháp của chúng tôi có liên hệ chặt chẽ với Kalchbrenner và Blunsom [18], những người đầu tiên ánh xạ toàn bộ câu đầu vào thành vectơ, và có liên hệ với Cho et al. [5] mặc dù phương pháp sau chỉ được sử dụng để chấm điểm lại các giả thuyết do một hệ thống dựa trên cụm từ tạo ra. Graves [10] giới thiệu một cơ chế attention khả vi mới cho phép mạng nơ-ron tập trung vào các phần khác nhau của đầu vào, và một biến thể thanh lịch của ý tưởng này đã được áp dụng thành công cho dịch máy bởi Bahdanau et al. [2]. Connectionist Sequence Classification là một kỹ thuật phổ biến khác để ánh xạ chuỗi sang chuỗi bằng mạng nơ-ron, nhưng nó giả định sự căn chỉnh đơn điệu giữa các đầu vào và đầu ra [11].
Hình.
Kết quả chính của công trình này là như sau. Trong nhiệm vụ dịch từ tiếng Anh sang tiếng Pháp của WMT’14, chúng tôi thu được điểm BLEU là 34.81 bằng cách trực tiếp trích xuất các bản dịch từ một tổ hợp gồm 5 LSTM sâu (với 384M tham số và trạng thái có 8,000 chiều mỗi cái) sử dụng một bộ giải mã tìm kiếm chùm đơn giản từ trái sang phải. Đây là kết quả tốt nhất đạt được bằng dịch trực tiếp với các mạng nơ-ron lớn cho đến nay. Để so sánh, điểm BLEU của một đường cơ sở SMT trên tập dữ liệu này là 33.30 [29]. Điểm BLEU 34.81 đạt được bởi một LSTM với từ vựng gồm 80k từ, vì vậy điểm số bị phạt bất cứ khi nào bản dịch tham chiếu chứa một từ không được bao phủ bởi 80k từ này. Kết quả này cho thấy một kiến trúc mạng nơ-ron với từ vựng nhỏ, tương đối chưa được tối ưu hóa và còn nhiều khả năng cải thiện, vượt trội hơn một hệ thống SMT dựa trên cụm từ.
Cuối cùng, chúng tôi sử dụng LSTM để chấm điểm lại các danh sách 1000-best được công khai của đường cơ sở SMT trên cùng nhiệm vụ [29]. Bằng cách đó, chúng tôi thu được điểm BLEU là 36.5, cải thiện đường cơ sở thêm 3.2 điểm BLEU và gần với kết quả tốt nhất đã được công bố trước đó trên nhiệm vụ này (là 37.0 [9]).
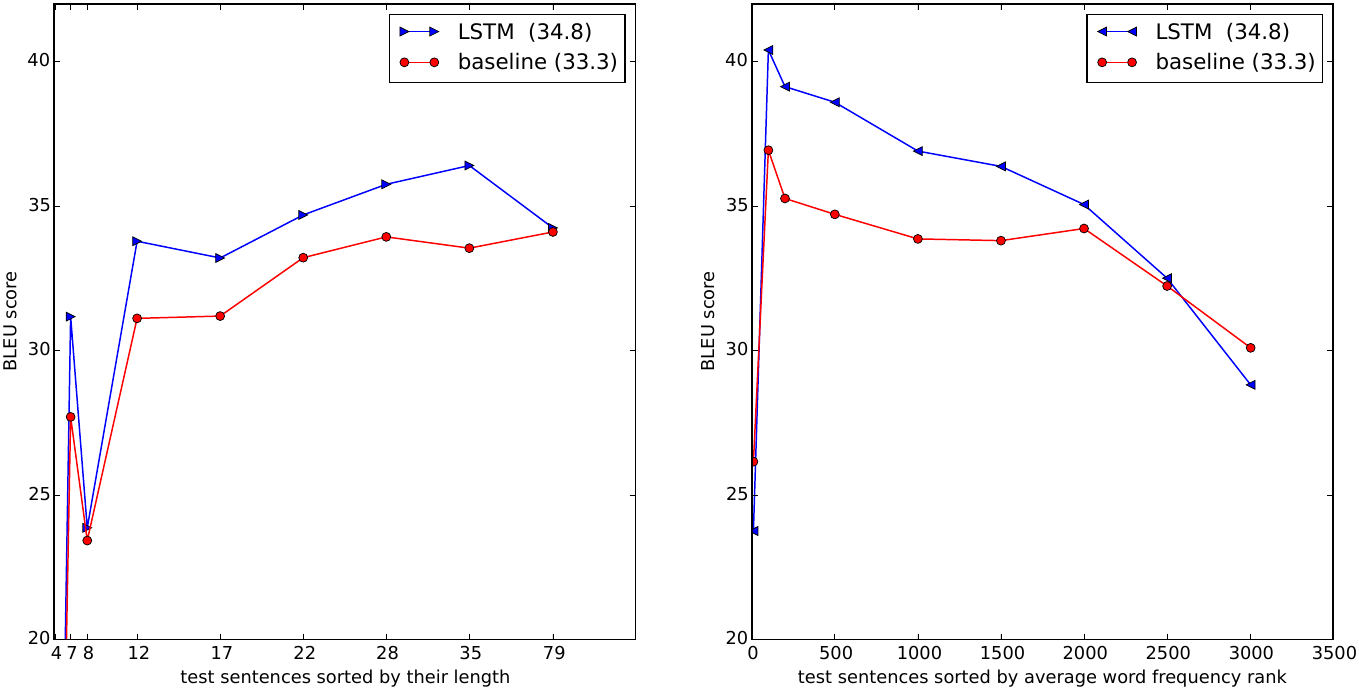
Đáng ngạc nhiên là LSTM không gặp suy giảm trên các câu rất dài, mặc dù kinh nghiệm gần đây của các nhà nghiên cứu khác với các kiến trúc liên quan [26]. Chúng tôi có thể đạt kết quả tốt trên các câu dài bởi vì chúng tôi đảo ngược thứ tự các từ trong câu nguồn nhưng không đảo ngược các câu đích trong tập huấn luyện và tập kiểm thử. Bằng cách đó, chúng tôi đưa vào nhiều phụ thuộc ngắn hạn khiến bài toán tối ưu hóa đơn giản hơn nhiều (xem sec. 2 và 3.3). Kết quả là, SGD có thể học các LSTM không gặp khó khăn với các câu dài. Mẹo đơn giản là đảo ngược các từ trong câu nguồn là một trong những đóng góp kỹ thuật then chốt của công trình này.
Một tính chất hữu ích của LSTM là nó học cách ánh xạ một câu đầu vào có độ dài biến đổi thành một biểu diễn vectơ có số chiều cố định. Do các bản dịch có xu hướng là các cách diễn đạt lại của các câu nguồn, mục tiêu dịch khuyến khích LSTM tìm ra các biểu diễn câu nắm bắt được ý nghĩa của chúng, vì các câu có ý nghĩa tương tự sẽ gần nhau trong khi các câu có ý nghĩa khác nhau sẽ cách xa nhau. Một đánh giá định tính ủng hộ nhận định này, cho thấy mô hình của chúng tôi nhận biết được thứ tự từ và khá bất biến đối với thể chủ động và thể bị động.
2 Mô hình
Mạng nơ-ron hồi quy (Recurrent Neural Network - RNN) (RNN) [31], [28] là một sự khái quát hóa tự nhiên của các mạng nơ-ron truyền thẳng cho các chuỗi. Cho một chuỗi các đầu vào , một RNN tiêu chuẩn tính toán một chuỗi các đầu ra bằng cách lặp lại phương trình sau:
RNN có thể dễ dàng ánh xạ các chuỗi sang các chuỗi bất cứ khi nào sự căn chỉnh giữa các đầu vào và đầu ra được biết trước. Tuy nhiên, chưa rõ cách áp dụng RNN cho các bài toán mà chuỗi đầu vào và đầu ra có độ dài khác nhau với các mối quan hệ phức tạp và không đơn điệu.
Chiến lược đơn giản nhất cho việc học chuỗi tổng quát là ánh xạ chuỗi đầu vào tới một vectơ có kích thước cố định bằng cách sử dụng một RNN, sau đó ánh xạ vectơ tới chuỗi mục tiêu bằng một RNN khác (cách tiếp cận này cũng đã được Cho và cộng sự sử dụng [5]). Mặc dù về nguyên tắc nó có thể hoạt động vì RNN được cung cấp tất cả thông tin liên quan, việc huấn luyện các RNN sẽ khó khăn do các phụ thuộc dài hạn phát sinh (hình 1) [14], [4], [16], [15]. Tuy nhiên, Long Short-Term Memory (LSTM) [16] được biết đến với khả năng học các bài toán có phụ thuộc thời gian tầm xa, vì vậy một LSTM có thể thành công trong thiết lập này.
Mục tiêu của LSTM là ước lượng xác suất có điều kiện trong đó là một chuỗi đầu vào và là chuỗi đầu ra tương ứng của nó, với độ dài có thể khác . LSTM tính toán xác suất có điều kiện này bằng cách trước tiên thu được biểu diễn có số chiều cố định của chuỗi đầu vào được cho bởi trạng thái ẩn cuối cùng của LSTM, sau đó tính toán xác suất của bằng một công thức LSTM-LM tiêu chuẩn có trạng thái ẩn ban đầu được đặt thành biểu diễn của :
Trong phương trình này, mỗi phân phối được biểu diễn bằng một softmax trên tất cả các từ trong từ vựng. Chúng tôi sử dụng công thức LSTM từ Graves [10]. Lưu ý rằng chúng tôi yêu cầu mỗi câu kết thúc bằng một ký hiệu kết thúc câu đặc biệt “<EOS>”, cho phép mô hình xác định một phân phối trên các chuỗi có mọi độ dài có thể. Lược đồ tổng thể được trình bày trong hình 1, trong đó LSTM được minh họa tính toán biểu diễn của “A”, “B”, “C”, “<EOS>” và sau đó sử dụng biểu diễn này để tính toán xác suất của “W”, “X”, “Y”, “Z”, “<EOS>”.
Các mô hình thực tế của chúng tôi khác với mô tả trên theo ba cách quan trọng. Thứ nhất, chúng tôi sử dụng hai LSTM khác nhau: một cho chuỗi đầu vào và một cho chuỗi đầu ra, bởi vì việc này làm tăng số lượng tham số mô hình với chi phí tính toán không đáng kể và giúp việc huấn luyện LSTM trên nhiều cặp ngôn ngữ đồng thời trở nên tự nhiên [18]. Thứ hai, chúng tôi nhận thấy rằng các LSTM sâu vượt trội đáng kể so với các LSTM nông, vì vậy chúng tôi chọn một LSTM có bốn lớp. Thứ ba, chúng tôi nhận thấy rằng việc đảo ngược thứ tự các từ của câu đầu vào có giá trị rất lớn. Ví dụ, thay vì ánh xạ câu sang câu , LSTM được yêu cầu ánh xạ sang , trong đó là bản dịch của . Theo cách này, ở gần , khá gần với , và cứ tiếp tục như vậy, một thực tế giúp SGD dễ dàng “thiết lập liên lạc” giữa đầu vào và đầu ra. Chúng tôi nhận thấy phép biến đổi dữ liệu đơn giản này cải thiện đáng kể hiệu năng của LSTM.
3 Thực nghiệm
Chúng tôi áp dụng phương pháp của mình cho tác vụ dịch máy (machine translation) từ tiếng Anh sang tiếng Pháp của WMT’14 theo hai cách. Chúng tôi dùng phương pháp này để dịch trực tiếp câu đầu vào mà không sử dụng hệ thống dịch máy thống kê (SMT) tham chiếu, đồng thời dùng nó để chấm lại điểm số cho các danh sách n bản dịch tốt nhất của một hệ thống SMT đường cơ sở. Chúng tôi báo cáo độ chính xác của các phương pháp dịch này, trình bày các bản dịch mẫu và trực quan hóa biểu diễn câu thu được.
3.1 Chi tiết về tập dữ liệu
Chúng tôi sử dụng tập dữ liệu tiếng Anh sang tiếng Pháp của WMT’14. Chúng tôi huấn luyện các mô hình trên một tập con gồm 12M câu, chứa 348M từ tiếng Pháp và 304M từ tiếng Anh, là một tập con sạch được “chọn lọc” từ [29]. Chúng tôi chọn tác vụ dịch này và tập con huấn luyện cụ thể này vì tập huấn luyện và tập kiểm thử đã được tách token, cùng với các danh sách 1000 bản dịch tốt nhất từ hệ thống SMT đường cơ sở [29], đều được công bố công khai.
Vì các mô hình ngôn ngữ nơ-ron thông thường dựa vào một biểu diễn vectơ cho mỗi từ, chúng tôi sử dụng một bộ từ vựng cố định cho cả hai ngôn ngữ. Chúng tôi dùng 160,000 từ xuất hiện thường xuyên nhất cho ngôn ngữ nguồn và 80,000 từ xuất hiện thường xuyên nhất cho ngôn ngữ đích. Mỗi từ ngoài bộ từ vựng được thay bằng một token đặc biệt “UNK”.
3.2 Giải mã và chấm lại điểm số
Phần cốt lõi của các thực nghiệm là huấn luyện một LSTM sâu, lớn trên nhiều cặp câu. Chúng tôi huấn luyện nó bằng cách cực đại hóa log xác suất của một bản dịch đúng khi biết câu nguồn , do đó mục tiêu huấn luyện là
trong đó là tập huấn luyện. Sau khi hoàn tất huấn luyện, chúng tôi tạo ra các bản dịch bằng cách tìm bản dịch có xác suất cao nhất theo LSTM:
Chúng tôi tìm bản dịch có xác suất cao nhất bằng một bộ giải mã tìm kiếm chùm (beam search) đơn giản từ trái sang phải, duy trì một số lượng nhỏ giả thuyết chưa hoàn chỉnh, trong đó một giả thuyết chưa hoàn chỉnh là tiền tố của một bản dịch nào đó. Ở mỗi bước thời gian, chúng tôi mở rộng từng giả thuyết chưa hoàn chỉnh trong chùm bằng từng từ có thể có trong bộ từ vựng. Điều này làm tăng mạnh số lượng giả thuyết, nên chúng tôi loại bỏ tất cả, chỉ giữ lại giả thuyết có xác suất cao nhất theo log xác suất của mô hình. Ngay khi ký hiệu “<EOS>” được nối vào một giả thuyết, giả thuyết đó được lấy ra khỏi chùm và thêm vào tập các giả thuyết hoàn chỉnh. Mặc dù bộ giải mã này mang tính xấp xỉ, nó dễ triển khai. Điều thú vị là hệ thống của chúng tôi hoạt động tốt ngay cả với kích thước chùm bằng 1, và chùm có kích thước bằng 2 mang lại phần lớn lợi ích của tìm kiếm chùm (Bảng 1).
Chúng tôi cũng dùng LSTM để chấm lại điểm số cho các danh sách 1000 bản dịch tốt nhất do hệ thống đường cơ sở [29] tạo ra. Để chấm lại điểm số cho một danh sách n bản dịch tốt nhất, chúng tôi tính log xác suất của từng giả thuyết bằng LSTM và lấy trung bình cộng của điểm số từ hệ thống đó và điểm số của LSTM.
3.3 Đảo ngược các câu nguồn
Mặc dù LSTM có khả năng giải quyết các bài toán có phụ thuộc dài hạn, chúng tôi phát hiện rằng LSTM học tốt hơn nhiều khi các câu nguồn được đảo ngược (các câu đích không được đảo ngược). Khi làm như vậy, độ bối rối (perplexity) của LSTM trên tập kiểm thử giảm từ 5.8 xuống 4.7, và điểm số BLEU trên tập kiểm thử của các bản dịch được giải mã tăng từ 25.9 lên 30.6.
Mặc dù chưa có lời giải thích đầy đủ cho hiện tượng này, chúng tôi cho rằng nguyên nhân là do việc đưa nhiều phụ thuộc ngắn hạn vào tập dữ liệu. Thông thường, khi nối một câu nguồn với một câu đích, mỗi từ trong câu nguồn đều ở xa từ tương ứng trong câu đích. Do đó, bài toán có “độ trễ thời gian tối thiểu” lớn [17]. Khi đảo ngược các từ trong câu nguồn, khoảng cách trung bình giữa các từ tương ứng trong ngôn ngữ nguồn và ngôn ngữ đích không thay đổi. Tuy nhiên, vài từ đầu tiên trong ngôn ngữ nguồn lúc này ở rất gần vài từ đầu tiên trong ngôn ngữ đích, nên độ trễ thời gian tối thiểu của bài toán giảm đáng kể. Vì vậy, lan truyền ngược (backpropagation) dễ “thiết lập liên lạc” giữa câu nguồn và câu đích hơn, từ đó cải thiện đáng kể hiệu năng tổng thể.
Ban đầu, chúng tôi cho rằng việc đảo ngược các câu đầu vào chỉ dẫn đến các dự đoán tự tin hơn ở phần đầu của câu đích và các dự đoán kém tự tin hơn ở phần sau. Tuy nhiên, các LSTM được huấn luyện trên các câu nguồn đảo ngược hoạt động tốt hơn nhiều trên các câu dài so với các LSTM được huấn luyện trên các câu nguồn nguyên bản (xem mục 3.7), cho thấy việc đảo ngược các câu đầu vào giúp LSTM sử dụng bộ nhớ tốt hơn.
3.4 Chi tiết huấn luyện
Chúng tôi nhận thấy các mô hình LSTM khá dễ huấn luyện. Chúng tôi sử dụng các LSTM sâu có 4 lớp, với 1000 ô ở mỗi lớp và các embedding từ 1000 chiều, cùng bộ từ vựng đầu vào gồm 160,000 từ và bộ từ vựng đầu ra gồm 80,000 từ. Như vậy, LSTM sâu dùng 8000 số thực để biểu diễn một câu. Chúng tôi nhận thấy các LSTM sâu có hiệu năng vượt trội đáng kể so với các LSTM nông, trong đó mỗi lớp bổ sung làm giảm độ bối rối gần 10%, có thể là do trạng thái ẩn lớn hơn nhiều của chúng. Chúng tôi dùng softmax theo cách trực tiếp trên 80,000 từ tại mỗi đầu ra. LSTM thu được có 384M tham số, trong đó 64M là các kết nối hồi quy thuần túy (32M cho LSTM “bộ mã hóa” và 32M cho LSTM “bộ giải mã”). Chi tiết huấn luyện đầy đủ được trình bày dưới đây:
• Chúng tôi khởi tạo tất cả các tham số của LSTM theo phân phối đều trong khoảng từ -0.08 đến 0.08 • Chúng tôi sử dụng phương pháp hạ gradient ngẫu nhiên (stochastic gradient descent) không có động lượng, với tốc độ học cố định là 0.7. Sau 5 lượt huấn luyện, chúng tôi bắt đầu giảm tốc độ học đi một nửa sau mỗi nửa lượt huấn luyện. Chúng tôi huấn luyện các mô hình trong tổng cộng 7.5 lượt. • Chúng tôi sử dụng các lô gồm 128 chuỗi để tính gradient và chia gradient cho kích thước lô (tức là 128). • Mặc dù LSTM thường không gặp vấn đề tiêu biến gradient, chúng có thể gặp hiện tượng bùng nổ gradient. Vì vậy, chúng tôi áp đặt một ràng buộc cứng lên chuẩn của gradient [10, 25] bằng cách co giãn gradient khi chuẩn của nó vượt quá một ngưỡng. Với mỗi lô huấn luyện, chúng tôi tính , trong đó là gradient đã chia cho 128. Nếu , chúng tôi đặt . • Các câu khác nhau có độ dài khác nhau. Phần lớn các câu đều ngắn (ví dụ, độ dài 20-30), nhưng một số câu lại dài (ví dụ, độ dài ), do đó một lô nhỏ gồm 128 câu huấn luyện được chọn ngẫu nhiên sẽ có nhiều câu ngắn và ít câu dài, khiến phần lớn tính toán trong lô nhỏ bị lãng phí. Để giải quyết vấn đề này, chúng tôi bảo đảm rằng tất cả các câu trong một lô nhỏ có độ dài gần bằng nhau, nhờ đó tăng tốc gấp 2 lần.
3.5 Song song hóa
Một bản triển khai LSTM sâu bằng C++ với cấu hình từ mục trước trên một GPU duy nhất xử lý với tốc độ khoảng 1,700 từ mỗi giây. Tốc độ này quá chậm đối với mục đích của chúng tôi, nên chúng tôi song song hóa mô hình bằng một máy có 8 GPU. Mỗi lớp của LSTM được thực thi trên một GPU khác nhau và truyền các giá trị kích hoạt của nó sang GPU / lớp tiếp theo ngay khi chúng được tính xong. Các mô hình của chúng tôi có 4 lớp LSTM, mỗi lớp nằm trên một GPU riêng. 4 GPU còn lại được dùng để song song hóa softmax, nên mỗi GPU phụ trách phép nhân với một ma trận . Bản triển khai thu được đạt tốc độ 6,300 từ (gồm cả tiếng Anh và tiếng Pháp) mỗi giây với kích thước lô nhỏ là 128. Quá trình huấn luyện với bản triển khai này mất khoảng mười ngày.
3.6 Kết quả thực nghiệm
Chúng tôi sử dụng điểm số BLEU có phân biệt chữ hoa và chữ thường [24] để đánh giá chất lượng các bản dịch. Chúng tôi tính các điểm số BLEU bằng multi-bleu.pl trên các dự đoán và bản dịch chuẩn đã được tách token. Cách đánh giá điểm số BELU này nhất quán với [5] và [2], đồng thời tái lập điểm số 33.3 của [29]. Tuy nhiên, nếu đánh giá hệ thống WMT’14 tốt nhất [9] (có thể tải các dự đoán của hệ thống này từ statmt.org\matrix) theo cách này, chúng tôi thu được 37.0, cao hơn mức 35.8 được báo cáo trên statmt.org\matrix.
Các kết quả được trình bày trong bảng 1 và 2. Chúng tôi thu được kết quả tốt nhất với một tổ hợp (ensemble) các LSTM khác nhau về cách khởi tạo ngẫu nhiên và thứ tự ngẫu nhiên của các lô nhỏ. Mặc dù các bản dịch được giải mã từ tổ hợp LSTM không vượt qua hệ thống WMT’14 tốt nhất, đây là lần đầu tiên một hệ thống dịch thuần nơ-ron vượt qua đường cơ sở SMT dựa trên cụm từ trên một tác vụ dịch máy quy mô lớn
Có một số biến thể của điểm số BLEU, và mỗi biến thể được định nghĩa bằng một script perl.
| Phương pháp | Điểm số BLEU trên tập kiểm thử (ntst14) |
|---|---|
| Bahdanau và cộng sự [2] | 28.45 |
| Hệ thống đường cơ sở [29] | 33.30 |
| Một LSTM xuôi, kích thước chùm 12 | 26.17 |
| Một LSTM đảo ngược, kích thước chùm 12 | 30.59 |
| Tổ hợp 5 LSTM đảo ngược, kích thước chùm 1 | 33.00 |
| Tổ hợp 2 LSTM đảo ngược, kích thước chùm 12 | 33.27 |
| Tổ hợp 5 LSTM đảo ngược, kích thước chùm 2 | 34.50 |
| Tổ hợp 5 LSTM đảo ngược, kích thước chùm 12 | 34.81 |
Bảng 1: Hiệu năng của LSTM trên tập kiểm thử dịch từ tiếng Anh sang tiếng Pháp WMT’14 (ntst14). Lưu ý rằng một tổ hợp 5 LSTM với chùm có kích thước 2 có chi phí thấp hơn một LSTM duy nhất với chùm có kích thước 12.
| Phương pháp | Điểm số BLEU trên tập kiểm thử (ntst14) |
|---|---|
| Hệ thống đường cơ sở [29] | 33.30 |
| Cho và cộng sự [5] | 34.54 |
| Kết quả WMT’14 tốt nhất [9] | 37.0 |
| Chấm điểm lại 1000 bản dịch tốt nhất của đường cơ sở bằng một LSTM xuôi | 35.61 |
| Chấm điểm lại 1000 bản dịch tốt nhất của đường cơ sở bằng một LSTM đảo ngược | 35.85 |
| Chấm điểm lại 1000 bản dịch tốt nhất của đường cơ sở bằng một tổ hợp 5 LSTM đảo ngược | 36.5 |
| Chấm điểm lại bằng oracle các danh sách 1000 bản dịch tốt nhất của đường cơ sở | ~45 |
Bảng 2: Các phương pháp sử dụng mạng nơ-ron (neural network) cùng với một hệ thống SMT trên tập kiểm thử dịch từ tiếng Anh sang tiếng Pháp WMT’14 (ntst14).
với khoảng cách đáng kể, mặc dù không thể xử lý các từ ngoài từ vựng. LSTM chỉ kém kết quả WMT’14 tốt nhất trong khoảng 0.5 điểm BLEU nếu được dùng để chấm điểm lại danh sách 1000 bản dịch tốt nhất của hệ thống đường cơ sở.
3.7 Hiệu năng trên các câu dài
Chúng tôi ngạc nhiên khi phát hiện rằng LSTM xử lý tốt các câu dài, như được thể hiện định lượng trong hình 3. Bảng 3 trình bày một số ví dụ về các câu dài và bản dịch của chúng.
3.8 Phân tích mô hình
Hình.
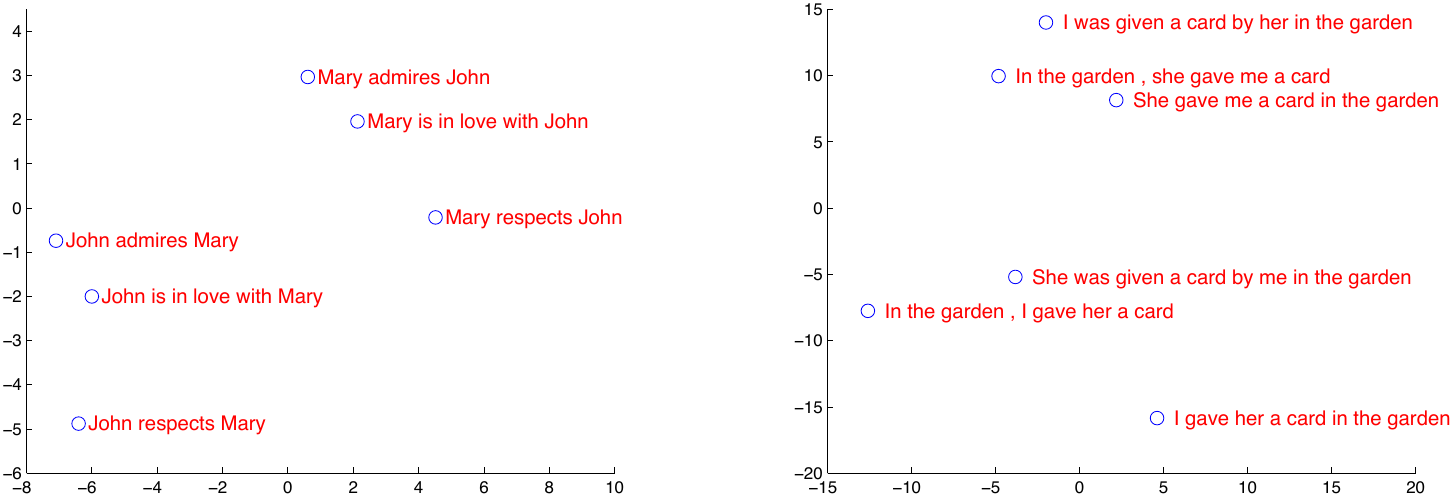
Một trong những đặc trưng hấp dẫn của mô hình chúng tôi là khả năng biến một chuỗi từ thành một vectơ có số chiều cố định. Hình 2 trực quan hóa một số biểu diễn đã học được. Hình này cho thấy rõ rằng các biểu diễn nhạy với thứ tự từ, đồng thời khá ít nhạy với
| Kiểu | Câu |
|---|---|
| Mô hình của chúng tôi | Ulrich UNK, thành viên hội đồng quản trị của hãng sản xuất ô tô Audi, khẳng định rằng việc thu gom điện thoại di động trước các cuộc họp hội đồng quản trị để chúng không bị sử dụng làm thiết bị nghe lén từ xa đã là thông lệ trong nhiều năm. |
| Bản dịch chuẩn | Ulrich Hackenberg, thành viên hội đồng quản trị của hãng sản xuất ô tô Audi, cho biết việc thu gom điện thoại di động trước các cuộc họp hội đồng quản trị, để chúng không thể bị sử dụng làm thiết bị nghe lén từ xa, đã là thông lệ trong nhiều năm. |
| Mô hình của chúng tôi | “Điện thoại di động thực sự là một vấn đề, không chỉ vì chúng có khả năng gây nhiễu các thiết bị dẫn đường, mà chúng tôi còn biết, theo FCC, rằng chúng có thể gây nhiễu các trạm thu phát sóng di động khi ở trên không”, UNK nói. |
| Bản dịch chuẩn | “Điện thoại di động thực sự là một vấn đề, không chỉ vì chúng có thể gây nhiễu các thiết bị dẫn đường, mà còn vì chúng tôi biết, theo FCC, rằng chúng có thể gây nhiễu các trạm thu phát sóng di động nếu được sử dụng trên máy bay”, Rosenker cho biết. |
| Mô hình của chúng tôi | Với việc hỏa táng, có một “cảm giác bạo lực đối với thi thể của người thân yêu”, vốn sẽ bị “biến thành một đống tro” trong thời gian rất ngắn thay vì trải qua một quá trình phân hủy “đồng hành cùng các giai đoạn đau buồn”. |
| Bản dịch chuẩn | Với việc hỏa táng, có “sự bạo lực đối với thi thể người thân yêu”, vốn sẽ bị “biến thành một đống tro” trong thời gian rất ngắn, chứ không phải sau một quá trình phân hủy, vốn “sẽ đồng hành cùng các giai đoạn đau buồn”. |
Bảng 3: Một vài ví dụ về các bản dịch dài do LSTM tạo ra, đặt cạnh các bản dịch chuẩn (ground truth). Có thể dùng Google translate để kiểm tra rằng các bản dịch này hợp lý.
Hình.
việc thay thế thể chủ động bằng thể bị động. Các phép chiếu hai chiều được thu được bằng phân tích thành phần chính (PCA).
4 Công trình liên quan
Có một lượng lớn các công trình nghiên cứu về các ứng dụng của mạng nơ-ron vào dịch máy. Cho đến nay, cách đơn giản nhất và hiệu quả nhất để áp dụng Mô hình Ngôn ngữ RNN (RNNLM) [23] hoặc
Mô hình Ngôn ngữ Mạng Nơ-ron Truyền thẳng (NNLM) [3] vào một tác vụ MT là chấm điểm lại các danh sách n-best của một đường cơ sở MT mạnh [22], điều này cải thiện đáng tin cậy chất lượng dịch.
Gần đây hơn, các nhà nghiên cứu đã bắt đầu tìm hiểu các phương pháp đưa thông tin về ngôn ngữ nguồn vào NNLM. Các ví dụ của hướng nghiên cứu này bao gồm Auli et al. [1], những người kết hợp một NNLM với một mô hình chủ đề của câu đầu vào, qua đó cải thiện hiệu năng chấm điểm lại. Devlin et al. [8] đã theo một cách tiếp cận tương tự, nhưng họ tích hợp NNLM của mình vào bộ giải mã của một hệ thống MT và sử dụng thông tin căn chỉnh của bộ giải mã để cung cấp cho NNLM những từ hữu ích nhất trong câu đầu vào. Cách tiếp cận của họ đạt thành công lớn và đem lại những cải thiện đáng kể so với đường cơ sở của họ.
Công trình của chúng tôi có liên hệ chặt chẽ với Kalchbrenner và Blunsom [18], những người đầu tiên ánh xạ câu đầu vào thành một vectơ rồi ánh xạ ngược trở lại thành một câu, mặc dù họ ánh xạ các câu thành các vectơ bằng cách sử dụng mạng nơ-ron tích chập, vốn làm mất thứ tự của các từ. Tương tự như công trình này, Cho et al. [5] đã sử dụng một kiến trúc RNN giống LSTM để ánh xạ các câu thành các vectơ và ngược lại, mặc dù trọng tâm chính của họ là tích hợp mạng nơ-ron của mình vào một hệ thống SMT. Bahdanau et al. [2] cũng thử nghiệm các bản dịch trực tiếp bằng một mạng nơ-ron sử dụng cơ chế attention để khắc phục hiệu năng kém trên các câu dài mà Cho et al. [5] gặp phải và đạt được các kết quả đáng khích lệ. Tương tự, Pouget-Abadie et al. [26] đã cố gắng giải quyết vấn đề bộ nhớ của Cho et al. [5] bằng cách dịch các phần của câu nguồn theo cách tạo ra các bản dịch mượt mà, tương tự như một cách tiếp cận dựa trên cụm từ. Chúng tôi nghi ngờ rằng họ có thể đạt được những cải thiện tương tự chỉ bằng cách huấn luyện các mạng của mình trên các câu nguồn đã được đảo ngược.
Huấn luyện end-to-end cũng là trọng tâm của Hermann et al. [12], có mô hình biểu diễn các đầu vào và đầu ra bằng các mạng truyền thẳng, và ánh xạ chúng tới các điểm tương tự trong không gian. Tuy nhiên, cách tiếp cận của họ không thể tạo ra các bản dịch trực tiếp: để có được một bản dịch, họ cần thực hiện tra cứu vectơ gần nhất trong cơ sở dữ liệu các câu đã được tính toán trước, hoặc chấm điểm lại một câu.
5 Kết luận
Trong công trình này, chúng tôi đã chỉ ra rằng một LSTM sâu lớn, có từ vựng hạn chế và hầu như không đưa ra giả định nào về cấu trúc bài toán, có thể vượt trội hơn một hệ thống dựa trên SMT tiêu chuẩn có từ vựng không giới hạn trong một tác vụ MT quy mô lớn. Thành công của phương pháp đơn giản dựa trên LSTM của chúng tôi trên MT cho thấy nó có thể hoạt động tốt trên nhiều bài toán học chuỗi khác, với điều kiện chúng có đủ dữ liệu huấn luyện.
Chúng tôi ngạc nhiên trước mức độ cải thiện đạt được bằng cách đảo ngược các từ trong các câu nguồn. Chúng tôi kết luận rằng điều quan trọng là tìm ra một cách mã hóa bài toán có số lượng phụ thuộc ngắn hạn lớn nhất, vì chúng làm cho bài toán học đơn giản hơn nhiều. Cụ thể, trong khi chúng tôi không thể huấn luyện một RNN tiêu chuẩn trên bài toán dịch không đảo ngược (được minh họa trong hình 1), chúng tôi tin rằng một RNN tiêu chuẩn có thể dễ dàng được huấn luyện khi các câu nguồn được đảo ngược (mặc dù chúng tôi chưa xác minh điều này bằng thực nghiệm).
Chúng tôi cũng ngạc nhiên trước khả năng của LSTM trong việc dịch chính xác các câu rất dài. Ban đầu chúng tôi tin rằng LSTM sẽ thất bại trên các câu dài do bộ nhớ hạn chế của nó, và các nhà nghiên cứu khác đã báo cáo hiệu năng kém trên các câu dài với một mô hình tương tự của chúng tôi [5, 2, 26]. Tuy nhiên, các LSTM được huấn luyện trên tập dữ liệu đã đảo ngược gặp rất ít khó khăn khi dịch các câu dài.
Quan trọng nhất, chúng tôi đã chứng minh rằng một phương pháp đơn giản, trực tiếp và tương đối chưa được tối ưu hóa có thể vượt trội hơn một hệ thống SMT, vì vậy các nghiên cứu tiếp theo có khả năng sẽ dẫn đến độ chính xác dịch thuật còn cao hơn nữa. Những kết quả này cho thấy phương pháp của chúng tôi có khả năng sẽ hoạt động tốt trên các bài toán chuỗi sang chuỗi đầy thách thức khác.
6 Lời cảm ơn
Chúng tôi cảm ơn Samy Bengio, Jeff Dean, Matthieu Devin, Geoffrey Hinton, Nal Kalchbrenner, Thang Luong, Wolfgang Macherey, Rajat Monga, Vincent Vanhoucke, Peng Xu, Wojciech Zaremba, và nhóm Google Brain vì những nhận xét và thảo luận hữu ích.