Mạng đối kháng sinh (Generative Adversarial Nets)
Ian J. Goodfellow, Jean Pouget-Abadie1, Mehdi Mirza, Bing Xu, David Warde-Farley, Sherjil Ozair2, Aaron Courville, Yoshua Bengio3
Département d’informatique et de recherche opérationnelle Université de Montréal Montréal, QC H3C 3J7 arXiv:1406.2661v1 [stat.ML] 10 Jun 2014
Tóm tắt
Chúng tôi đề xuất một khung mới để ước lượng các mô hình sinh thông qua một quá trình đối kháng, trong đó chúng tôi đồng thời huấn luyện hai mô hình: một mô hình sinh nắm bắt phân phối dữ liệu, và một mô hình phân biệt ước lượng xác suất rằng một mẫu đến từ dữ liệu huấn luyện thay vì từ . Thủ tục huấn luyện cho là cực đại hóa xác suất mắc lỗi. Khung này tương ứng với một trò chơi minimax hai người chơi. Trong không gian của các hàm tùy ý và , tồn tại một nghiệm duy nhất, với khôi phục phân phối dữ liệu huấn luyện và bằng ở mọi nơi. Trong trường hợp và được định nghĩa bởi các perceptron đa lớp, toàn bộ hệ thống có thể được huấn luyện bằng lan truyền ngược. Không cần bất kỳ chuỗi Markov nào hoặc các mạng suy luận xấp xỉ được cuộn lại trong quá trình huấn luyện hoặc sinh mẫu. Các thí nghiệm chứng minh tiềm năng của khung này thông qua đánh giá định tính và định lượng các mẫu được sinh ra.
1 Giới thiệu
Triển vọng của học sâu (deep learning) là khám phá các mô hình phân cấp phong phú [2] biểu diễn các phân phối xác suất trên những loại dữ liệu gặp trong các ứng dụng trí tuệ nhân tạo, như ảnh tự nhiên, dạng sóng âm thanh chứa tiếng nói và các ký hiệu trong ngữ liệu ngôn ngữ tự nhiên. Cho đến nay, những thành công nổi bật nhất của học sâu gắn với các mô hình phân biệt, thường là những mô hình ánh xạ đầu vào cảm giác phong phú, có số chiều cao sang một nhãn lớp [14], [22]. Những thành công nổi bật này chủ yếu dựa trên các thuật toán lan truyền ngược (backpropagation) và dropout, sử dụng các đơn vị tuyến tính từng khúc [19, 9, 10] có gradient với tính chất đặc biệt thuận lợi. Các mô hình sinh sâu có ít ảnh hưởng hơn, do khó xấp xỉ nhiều phép tính xác suất không khả thi về mặt tính toán xuất hiện trong ước lượng hợp lý cực đại và các chiến lược liên quan, cũng như do khó khai thác lợi ích của các đơn vị tuyến tính từng khúc trong bối cảnh sinh dữ liệu. Chúng tôi đề xuất một thủ tục ước lượng mô hình sinh mới tránh được những khó khăn này.4
Trong khung mạng đối kháng (adversarial nets) được đề xuất, mô hình sinh được đặt vào thế đối đầu với một đối thủ: một mô hình phân biệt học cách xác định một mẫu đến từ phân phối của mô hình hay phân phối dữ liệu. Có thể hình dung mô hình sinh tương tự như một nhóm làm tiền giả, cố gắng tạo ra tiền giả và sử dụng mà không bị phát hiện, trong khi mô hình phân biệt tương tự như cảnh sát, cố gắng phát hiện tiền giả. Sự cạnh tranh trong trò chơi này thúc đẩy cả hai nhóm cải tiến phương pháp của mình cho đến khi không thể phân biệt tiền giả với tiền thật.
Khung này có thể tạo ra các thuật toán huấn luyện cụ thể cho nhiều loại mô hình và thuật toán tối ưu hóa. Trong bài báo này, chúng tôi khảo sát trường hợp đặc biệt khi mô hình sinh tạo các mẫu bằng cách truyền nhiễu ngẫu nhiên qua một perceptron nhiều lớp, và mô hình phân biệt cũng là một perceptron nhiều lớp. Chúng tôi gọi trường hợp đặc biệt này là mạng đối kháng. Trong trường hợp này, chúng tôi có thể huấn luyện cả hai mô hình chỉ bằng các thuật toán lan truyền ngược và dropout vốn rất thành công [17], đồng thời lấy mẫu từ mô hình sinh chỉ bằng lan truyền xuôi. Không cần suy luận xấp xỉ hay chuỗi Markov.
2 Công trình liên quan
Một phương án thay thế cho các mô hình đồ thị có hướng với các biến ẩn là các mô hình đồ thị vô hướng với các biến ẩn, chẳng hạn như restricted Boltzmann machines (RBMs) [27, 16], deep Boltzmann machines (DBMs) [26] và nhiều biến thể của chúng. Các tương tác bên trong những mô hình như vậy được biểu diễn dưới dạng tích của các hàm thế chưa chuẩn hóa, được chuẩn hóa bởi một phép tổng/tích phân toàn cục trên tất cả các trạng thái của các biến ngẫu nhiên. Đại lượng này (hàm phân hoạch) và gradient của nó là không thể tính toán được đối với tất cả các trường hợp ngoài những trường hợp tầm thường nhất, mặc dù chúng có thể được ước lượng bằng các phương pháp Markov chain Monte Carlo (MCMC). Việc trộn tạo ra một vấn đề đáng kể đối với các thuật toán học dựa vào MCMC [3, 5].
Deep belief networks (DBNs) [16] là các mô hình lai chứa một lớp vô hướng duy nhất và một số lớp có hướng. Mặc dù tồn tại một tiêu chuẩn huấn luyện xấp xỉ nhanh theo từng lớp, DBNs phải chịu các khó khăn về tính toán liên quan đến cả mô hình vô hướng và mô hình có hướng.
Các tiêu chuẩn thay thế không xấp xỉ hoặc chặn log-likelihood cũng đã được đề xuất, chẳng hạn như score matching [18] và noise-contrastive estimation (NCE) [13]. Cả hai phương pháp này đều yêu cầu mật độ xác suất đã học được đặc tả về mặt giải tích đến một hằng số chuẩn hóa. Lưu ý rằng trong nhiều mô hình sinh thú vị với nhiều lớp biến ẩn (chẳng hạn như DBNs và DBMs), thậm chí không thể suy ra một mật độ xác suất chưa chuẩn hóa có thể tính toán được. Một số mô hình như denoising auto-encoders [30] và contractive autoencoders có các quy tắc học rất giống với score matching được áp dụng cho RBMs. Trong NCE, cũng như trong công trình này, một tiêu chuẩn huấn luyện phân biệt được sử dụng để khớp một mô hình sinh. Tuy nhiên, thay vì khớp một mô hình phân biệt riêng biệt, chính mô hình sinh được dùng để phân biệt dữ liệu được sinh ra với các mẫu từ một phân phối nhiễu cố định. Vì NCE sử dụng một phân phối nhiễu cố định, việc học chậm đi đáng kể sau khi mô hình đã học được ngay cả một phân phối gần đúng chính xác trên một tập con nhỏ của các biến quan sát.
Cuối cùng, một số kỹ thuật không liên quan đến việc định nghĩa rõ ràng một phân phối xác suất, mà thay vào đó huấn luyện một máy sinh để lấy các mẫu từ phân phối mong muốn. Phương pháp này có ưu điểm là các máy như vậy có thể được thiết kế để được huấn luyện bằng back-propagation. Các công trình gần đây nổi bật trong lĩnh vực này bao gồm khung generative stochastic network (GSN) [5], mở rộng các denoising auto-encoders tổng quát [4]: cả hai có thể được xem như định nghĩa một chuỗi Markov được tham số hóa, tức là người ta học các tham số của một máy thực hiện một bước của một chuỗi Markov sinh. So với GSN, khung adversarial nets không yêu cầu một chuỗi Markov để lấy mẫu. Vì adversarial nets không yêu cầu các vòng lặp phản hồi trong quá trình sinh, chúng có khả năng tận dụng tốt hơn các đơn vị tuyến tính từng phần [19, 9, 10], vốn cải thiện hiệu năng của backpropagation nhưng gặp vấn đề với kích hoạt không bị chặn khi được sử dụng trong một vòng lặp phản hồi. Các ví dụ gần đây hơn về việc huấn luyện một máy sinh bằng cách lan truyền ngược vào nó bao gồm các công trình gần đây về auto-encoding variational Bayes [20] và stochastic backpropagation [24].
3 Mạng đối kháng
Khung mô hình hóa đối kháng (adversarial modeling) dễ áp dụng nhất khi cả hai mô hình đều là perceptron đa lớp (multilayer perceptron). Để học phân phối của bộ sinh trên dữ liệu , chúng tôi định nghĩa một phân phối tiên nghiệm trên các biến nhiễu đầu vào , sau đó biểu diễn một ánh xạ tới không gian dữ liệu dưới dạng , trong đó là một hàm khả vi được biểu diễn bằng một perceptron đa lớp có các tham số . Chúng tôi cũng định nghĩa một perceptron đa lớp thứ hai xuất ra một giá trị vô hướng duy nhất. biểu diễn xác suất đến từ dữ liệu thay vì từ . Chúng tôi huấn luyện để tối đa hóa xác suất gán nhãn đúng cho cả các ví dụ huấn luyện lẫn các mẫu từ . Đồng thời, chúng tôi huấn luyện để tối thiểu hóa :
Nói cách khác, và tham gia trò chơi minimax hai người chơi sau đây với hàm giá trị :
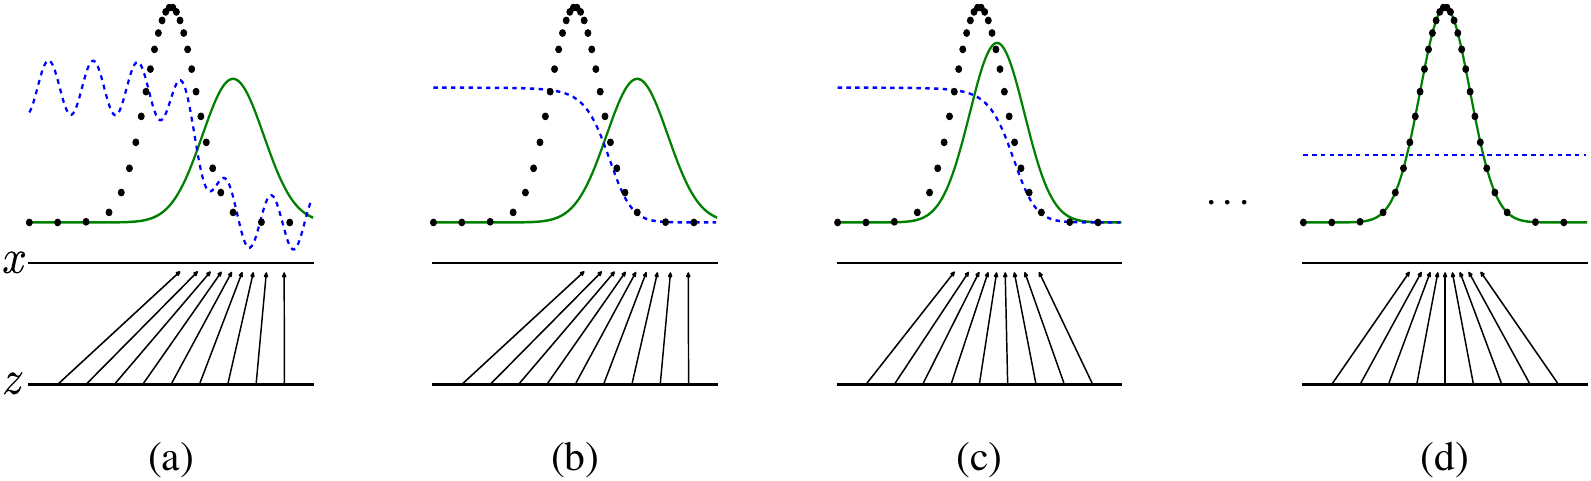
Trong phần tiếp theo, chúng tôi trình bày một phân tích lý thuyết về mạng đối kháng, về cơ bản cho thấy tiêu chí huấn luyện cho phép khôi phục phân phối sinh dữ liệu khi và có đủ năng lực biểu diễn, tức là trong giới hạn phi tham số. Xem Hình 1 để có cách giải thích ít hình thức hơn và mang tính sư phạm hơn về phương pháp này. Trong thực tế, chúng tôi phải triển khai trò chơi bằng một phương pháp số có tính lặp. Việc tối ưu hóa đến khi hoàn tất trong vòng lặp bên trong của quá trình huấn luyện đòi hỏi chi phí tính toán quá lớn, và trên các tập dữ liệu hữu hạn sẽ dẫn đến quá khớp (overfitting). Thay vào đó, chúng tôi luân phiên thực hiện bước tối ưu hóa và một bước tối ưu hóa . Nhờ vậy, được duy trì gần nghiệm tối ưu của nó, miễn là thay đổi đủ chậm. Chiến lược này tương tự cách quá trình huấn luyện SML/PCD [31, 29] duy trì các mẫu từ một chuỗi Markov từ bước học này sang bước học tiếp theo nhằm tránh phải thực hiện giai đoạn khởi động của chuỗi Markov trong vòng lặp bên trong của quá trình học. Thủ tục này được trình bày một cách hình thức trong Thuật toán 1.
Trong thực tế, phương trình 1 có thể không cung cấp đủ gradient để học tốt. Ở giai đoạn đầu của quá trình học, khi còn kém, có thể bác bỏ các mẫu với độ tin cậy cao vì chúng rõ ràng khác với dữ liệu huấn luyện. Trong trường hợp này, bão hòa. Thay vì huấn luyện để tối thiểu hóa , chúng tôi có thể huấn luyện để tối đa hóa . Hàm mục tiêu này dẫn đến cùng một điểm bất động của động lực học của và nhưng cung cấp các gradient mạnh hơn nhiều ở giai đoạn đầu của quá trình học.
4 Các kết quả lý thuyết
Bộ sinh định nghĩa một cách ngầm định một phân phối xác suất như là phân phối của các mẫu thu được khi . Do đó, chúng tôi muốn Algorithm 1 hội tụ đến một bộ ước lượng tốt của , nếu được cung cấp đủ năng lực và thời gian huấn luyện. Các kết quả của phần này được thực hiện trong thiết lập phi tham số, ví dụ, chúng tôi biểu diễn một mô hình với năng lực vô hạn bằng cách nghiên cứu sự hội tụ trong không gian của các hàm mật độ xác suất.
Chúng tôi sẽ chỉ ra trong phần 4.1 rằng trò chơi minimax này có một cực trị toàn cục cho . Sau đó, chúng tôi sẽ chỉ ra trong phần 4.2 rằng Algorithm 1 tối ưu hóa Eq 1, do đó thu được kết quả mong muốn.
Algorithm 1 Huấn luyện giảm gradient ngẫu nhiên theo lô nhỏ của các mạng đối kháng sinh. Số bước áp dụng cho bộ phân biệt, , là một siêu tham số. Chúng tôi sử dụng , tùy chọn ít tốn kém nhất trong các thí nghiệm của mình.
for số lần lặp huấn luyện do
for bước do
- Lấy mẫu lô nhỏ gồm mẫu nhiễu từ tiên nghiệm nhiễu .
- Lấy mẫu lô nhỏ gồm ví dụ từ phân phối sinh dữ liệu .
- Cập nhật bộ phân biệt bằng cách tăng gradient ngẫu nhiên của nó:
end for
- Lấy mẫu lô nhỏ gồm mẫu nhiễu từ tiên nghiệm nhiễu .
- Cập nhật bộ sinh bằng cách giảm gradient ngẫu nhiên của nó:
end for
Các cập nhật dựa trên gradient có thể sử dụng bất kỳ quy tắc học dựa trên gradient tiêu chuẩn nào. Chúng tôi đã sử dụng động lượng trong các thí nghiệm của mình.
4.1 Tính tối ưu toàn cục của
Trước tiên chúng tôi xét bộ phân biệt tối ưu đối với bất kỳ bộ sinh đã cho nào.
Proposition 1. Với cố định, bộ phân biệt tối ưu là
Proof. Tiêu chuẩn huấn luyện cho bộ phân biệt D, với bất kỳ bộ sinh G nào, là cực đại hóa đại lượng
Với mọi , hàm đạt giá trị cực đại trong tại . Bộ phân biệt không cần được định nghĩa bên ngoài , hoàn tất chứng minh.
Lưu ý rằng mục tiêu huấn luyện cho có thể được diễn giải như việc cực đại hóa log-likelihood để ước lượng xác suất có điều kiện , trong đó chỉ ra liệu đến từ (với ) hay từ (với ). Trò chơi minimax trong Eq. 1 giờ đây có thể được viết lại thành:
Theorem 1. Cực tiểu toàn cục của tiêu chuẩn huấn luyện ảo đạt được khi và chỉ khi . Tại điểm đó, đạt giá trị .
Proof. Với , , (xét Eq. 2). Do đó, bằng cách kiểm tra Eq. 4 tại , chúng ta nhận thấy . Để thấy rằng đây là giá trị tốt nhất có thể của , chỉ đạt được khi , hãy quan sát rằng
và bằng cách trừ biểu thức này khỏi , ta thu được:
trong đó KL là độ phân kỳ Kullback–Leibler. Chúng ta nhận ra trong biểu thức trước đó độ phân kỳ Jensen–Shannon giữa phân phối của mô hình và quá trình sinh dữ liệu:
Vì độ phân kỳ Jensen–Shannon giữa hai phân phối luôn không âm và bằng không chỉ khi chúng bằng nhau, chúng ta đã chứng minh rằng là cực tiểu toàn cục của và nghiệm duy nhất là , tức là mô hình sinh sao chép hoàn hảo quá trình sinh dữ liệu.
4.2 Sự hội tụ của Thuật toán 1
Mệnh đề 2. Nếu và có đủ năng lực, và tại mỗi bước của Thuật toán 1, bộ phân biệt được phép đạt đến tối ưu của nó với đã cho, và được cập nhật để cải thiện tiêu chí
thì hội tụ về
Chứng minh. Xét như một hàm của giống như đã thực hiện trong tiêu chí ở trên. Lưu ý rằng là lồi theo . Các đạo hàm con của một supremum của các hàm lồi bao gồm đạo hàm của hàm tại điểm đạt được giá trị cực đại. Nói cách khác, nếu và là lồi theo với mọi , thì nếu . Điều này tương đương với việc tính một cập nhật gradient descent cho tại tối ưu ứng với tương ứng. là lồi theo với một tối ưu toàn cục duy nhất như đã được chứng minh trong Định lý 1, do đó với các cập nhật đủ nhỏ, hội tụ về , hoàn tất chứng minh.
Trong thực tế, các mạng đối nghịch biểu diễn một họ giới hạn các phân phối thông qua hàm , và chúng tôi tối ưu hóa thay vì bản thân . Việc sử dụng một perceptron đa lớp để định nghĩa đưa vào nhiều điểm tới hạn trong không gian tham số. Tuy nhiên, hiệu năng xuất sắc của các perceptron đa lớp trong thực tế cho thấy chúng là một mô hình hợp lý để sử dụng mặc dù thiếu các đảm bảo lý thuyết.
5 Thực nghiệm
Chúng tôi đã huấn luyện các mạng đối kháng (adversarial nets) trên nhiều tập dữ liệu, bao gồm MNIST[23], Toronto Face Database (TFD) [28] và CIFAR-10 [21]. Các mạng sinh sử dụng kết hợp các hàm kích hoạt tuyến tính chỉnh lưu [19, 9] và các hàm kích hoạt sigmoid, trong khi mạng phân biệt sử dụng các hàm kích hoạt maxout [10]. Dropout [17] được áp dụng khi huấn luyện mạng phân biệt. Mặc dù khung lý thuyết của chúng tôi cho phép sử dụng dropout và các dạng nhiễu khác tại các lớp trung gian của bộ sinh, chúng tôi chỉ đưa nhiễu vào lớp dưới cùng của mạng sinh.
Chúng tôi ước lượng xác suất của dữ liệu tập kiểm thử theo bằng cách khớp một cửa sổ Parzen Gauss với các mẫu được sinh bằng và báo cáo log hợp lý (log-likelihood) theo phân phối này. Tham số
Bảng 1: Các ước lượng log hợp lý dựa trên cửa sổ Parzen. Các số được báo cáo trên MNIST là log hợp lý trung bình của các mẫu trong tập kiểm thử, với sai số chuẩn của trung bình được tính trên các mẫu. Trên TFD, chúng tôi tính sai số chuẩn trên các phần chia của tập dữ liệu, với một khác nhau được chọn bằng tập thẩm định của từng phần chia. Trên TFD, được thẩm định chéo trên từng phần chia và log hợp lý trung bình trên từng phần chia được tính toán. Với MNIST, chúng tôi so sánh với các mô hình khác trên phiên bản có giá trị thực (thay vì nhị phân) của tập dữ liệu.
của các phân phối Gauss được xác định bằng thẩm định chéo trên tập thẩm định. Thủ tục này được giới thiệu bởi Breuleux và cộng sự [8] và được sử dụng cho nhiều mô hình sinh mà việc tính chính xác hợp lý là bất khả thi [25, 3, 5]. Kết quả được báo cáo trong Bảng 1. Phương pháp ước lượng hợp lý này có phương sai tương đối cao và hoạt động không tốt trong các không gian nhiều chiều, nhưng theo hiểu biết của chúng tôi, đây là phương pháp tốt nhất hiện có. Những tiến bộ trong các mô hình sinh có thể lấy mẫu nhưng không thể trực tiếp ước lượng hợp lý thúc đẩy việc nghiên cứu thêm về cách đánh giá các mô hình như vậy.
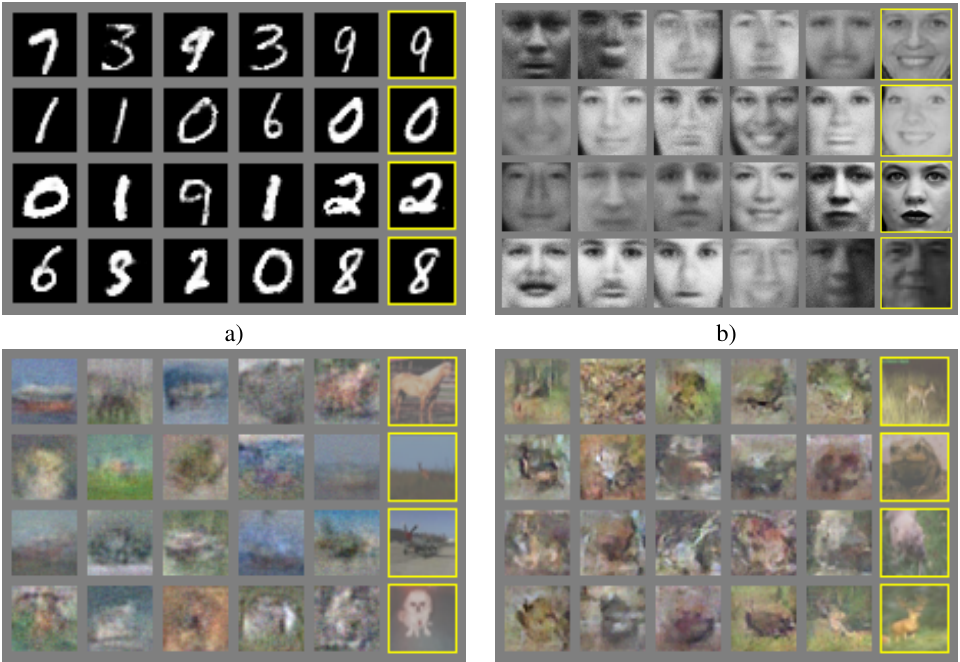
Trong Hình 2 và 3, chúng tôi trình bày các mẫu được lấy từ mạng sinh sau khi huấn luyện. Mặc dù chúng tôi không khẳng định rằng các mẫu này tốt hơn các mẫu được sinh bằng những phương pháp hiện có, chúng tôi tin rằng các mẫu này ít nhất có thể cạnh tranh với các mô hình sinh tốt hơn trong tài liệu nghiên cứu và cho thấy tiềm năng của khung đối kháng.
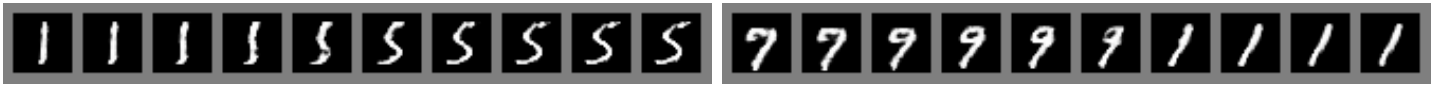
| Mô hình đồ thị có hướng sâu | Mô hình đồ thị vô hướng sâu | Bộ tự mã hóa sinh | Mô hình đối kháng | |
|---|---|---|---|---|
| Huấn luyện | Cần suy luận trong quá trình huấn luyện. | Cần suy luận trong quá trình huấn luyện. Cần MCMC để xấp xỉ gradient của hàm phân hoạch. | Buộc phải đánh đổi giữa sự trộn và khả năng sinh tái tạo | Đồng bộ hóa bộ phân biệt với bộ sinh. Helvetica. |
| Suy luận | Suy luận xấp xỉ được học | Suy luận biến phân | Suy luận dựa trên MCMC | Suy luận xấp xỉ được học |
| Lấy mẫu | Không có khó khăn | Cần chuỗi Markov | Cần chuỗi Markov | Không có khó khăn |
| Đánh giá | Không thể tính toán khả thi, có thể xấp xỉ bằng AIS | Không thể tính toán khả thi, có thể xấp xỉ bằng AIS | Không được biểu diễn tường minh, có thể xấp xỉ bằng ước lượng mật độ Parzen | Không được biểu diễn tường minh, có thể xấp xỉ bằng ước lượng mật độ Parzen |
| Thiết kế mô hình | Gần như mọi mô hình đều gặp khó khăn cực lớn | Cần thiết kế cẩn thận để bảo đảm nhiều tính chất | Về lý thuyết, cho phép mọi hàm khả vi | Về lý thuyết, cho phép mọi hàm khả vi |
Bảng 2: Những thách thức trong mô hình hóa sinh: tóm tắt các khó khăn mà những cách tiếp cận khác nhau đối với mô hình hóa sinh sâu gặp phải trong từng thao tác chính liên quan đến một mô hình.
6 Ưu điểm và nhược điểm
Khung mới này đi kèm với các ưu điểm và nhược điểm so với các khung mô hình hóa trước đây. Các nhược điểm chủ yếu là không có biểu diễn tường minh của , và phải được đồng bộ tốt với trong quá trình huấn luyện (đặc biệt, không được huấn luyện quá nhiều mà không cập nhật , nhằm tránh “kịch bản Helvetica”, trong đó thu gọn quá nhiều giá trị của thành cùng một giá trị của đến mức không có đủ tính đa dạng để mô hình hóa ), tương tự như các chuỗi âm của máy Boltzmann phải được cập nhật kịp thời giữa các bước học. Các ưu điểm là không bao giờ cần đến các chuỗi Markov, chỉ sử dụng backprop để thu được các gradient, không cần suy luận trong quá trình học, và có thể tích hợp nhiều loại hàm vào mô hình. Bảng 2 tóm tắt sự so sánh giữa các mạng đối nghịch sinh và các phương pháp mô hình hóa sinh khác.
Các ưu điểm nêu trên chủ yếu mang tính toán học. Các mô hình đối nghịch cũng có thể đạt được một số lợi thế thống kê từ việc mạng sinh không được cập nhật trực tiếp bằng các ví dụ dữ liệu, mà chỉ bằng các gradient truyền qua bộ phân biệt. Điều này có nghĩa là các thành phần của đầu vào không được sao chép trực tiếp vào các tham số của bộ sinh. Một ưu điểm khác của các mạng đối nghịch là chúng có thể biểu diễn các phân phối rất sắc nét, thậm chí suy biến, trong khi các phương pháp dựa trên chuỗi Markov yêu cầu phân phối phải hơi mờ để các chuỗi có thể trộn giữa các mode.
7 Kết luận và hướng nghiên cứu tương lai
Khung này cho phép nhiều mở rộng trực tiếp:
- Có thể thu được mô hình sinh có điều kiện (conditional generative model) bằng cách thêm làm đầu vào cho cả và .
- Có thể thực hiện suy luận xấp xỉ thông qua học (learned approximate inference) bằng cách huấn luyện một mạng phụ để dự đoán khi biết . Cách này tương tự mạng suy luận được huấn luyện bằng thuật toán wake-sleep [15] nhưng có ưu điểm là mạng suy luận có thể được huấn luyện với một mạng sinh cố định sau khi mạng sinh đã hoàn tất huấn luyện.
- Có thể mô hình hóa xấp xỉ tất cả các phân phối có điều kiện , trong đó là một tập con của tập chỉ số của , bằng cách huấn luyện một họ mô hình có điều kiện dùng chung tham số. Về bản chất, có thể dùng các mạng đối kháng để triển khai một mở rộng ngẫu nhiên của MP-DBM tất định [11].
- Học bán giám sát (semi-supervised learning): các đặc trưng từ mạng phân biệt hoặc mạng suy luận có thể cải thiện hiệu năng của các bộ phân loại khi dữ liệu có nhãn còn hạn chế.
- Cải thiện hiệu quả: có thể tăng tốc đáng kể quá trình huấn luyện bằng cách xây dựng các phương pháp tốt hơn để phối hợp và hoặc xác định các phân phối tốt hơn để lấy mẫu trong quá trình huấn luyện.
Bài báo này đã chứng minh tính khả thi của khung mô hình hóa đối kháng, cho thấy những hướng nghiên cứu này có thể mang lại lợi ích.
Lời cảm ơn
Chúng tôi xin cảm ơn Patrice Marcotte, Olivier Delalleau, Kyunghyun Cho, Guillaume Alain và Jason Yosinski vì những trao đổi hữu ích. Yann Dauphin đã chia sẻ với chúng tôi mã đánh giá bằng cửa sổ Parzen (Parzen window). Chúng tôi xin cảm ơn các nhà phát triển Pylearn2 [12] và Theano [7, 1], đặc biệt là Frédéric Bastien, người đã chia sẻ một đặc trưng của Theano dành riêng cho dự án này. Arnaud Bergeron đã hỗ trợ rất cần thiết trong việc dàn trang bằng . Chúng tôi cũng xin cảm ơn CIFAR và Canada Research Chairs đã tài trợ, cùng Compute Canada và Calcul Québec đã cung cấp tài nguyên tính toán. Ian Goodfellow nhận được hỗ trợ từ học bổng Google năm 2013 về học sâu (Deep Learning). Cuối cùng, chúng tôi xin cảm ơn Les Trois Brasseurs đã khơi gợi sự sáng tạo của chúng tôi.