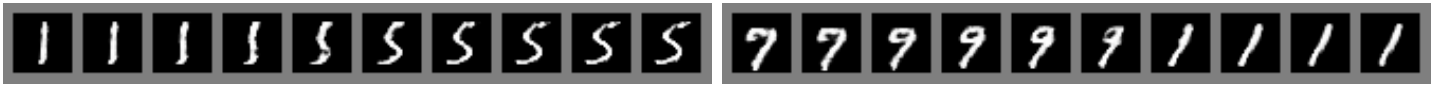Generative Adversarial Nets

About this paperEnglishTiếng Việt日本語beside Englishbeside Tiếng Việtbeside 日本語

生成对抗网络

Ian J. Goodfellow, Jean Pouget-Abadie1, Mehdi Mirza, Bing Xu, David Warde-Farley, Sherjil Ozair2, Aaron Courville, Yoshua Bengio3

Département d’informatique et de recherche opérationnelle Université de Montréal Montréal, QC H3C 3J7

arXiv:1406.2661v1 [stat.ML] 10 Jun 2014

摘要

我们提出了一种通过对抗过程估计生成模型的新框架,在该过程中,我们同时训练两个模型:一个捕获数据分布的生成模型GG,以及一个判别模型DD,用于估计样本来自训练数据而非GG的概率。GG的训练过程是最大化DD出错的概率。该框架对应于一个极小极大双人博弈。在任意函数GG和DD的空间中,存在唯一解,其中GG恢复训练数据分布,而DD处处等于12\frac12。当GG和DD由多层感知机定义时,整个系统可以通过反向传播进行训练。在训练或生成样本的过程中,都不需要任何马尔可夫链或展开的近似推理网络。实验通过对生成样本进行定性和定量评估,展示了该框架的潜力。

1 引言

深度学习的前景在于发现丰富的、层次化的模型[2],这些模型表示人工智能应用中遇到的各类数据上的概率分布,例如自然图像、包含语音的音频波形以及自然语言语料中的符号。到目前为止,深度学习最引人注目的成功主要来自判别模型,通常是那些将高维、丰富的感知输入映射到类别标签的模型[14],[22]。这些显著成功主要建立在反向传播和Dropout算法之上,使用分段线性单元[19, 9, 10],其梯度具有特别良好的性质。深度生成模型的影响则较小,这是由于难以近似最大似然估计及相关策略中出现的许多难以处理的概率计算,也由于难以在生成场景中利用分段线性单元的优势。我们提出一种新的生成模型估计过程,绕开了这些困难。4

在所提出的对抗网络框架中,生成模型与一个对手相对抗:一个学习判定样本来自模型分布还是数据分布的判别模型。生成模型可以被看作一群造假者,试图制造并使用假币而不被发现;而判别模型则类似于警察,试图识别假币。这场博弈中的竞争推动双方不断改进各自的方法,直到伪造品与真品无法区分。

该框架能够为多种类型的模型和优化算法导出具体的训练算法。本文探索一种特殊情形:生成模型通过将随机噪声传入多层感知机来生成样本,而判别模型也是一个多层感知机。我们将这一特殊情形称为对抗网络。在这种情况下,我们只需使用极其成功的反向传播和Dropout算法[17]即可训练两个模型,并且只需前向传播即可从生成模型中采样。不需要近似推理或马尔可夫链。

2 相关工作

有潜变量的有向图模型的一种替代方案是有潜变量的无向图模型,例如受限玻尔兹曼机(RBM)[27, 16]、深度玻尔兹曼机(DBM)[26]及其众多变体。这类模型中的相互作用被表示为未归一化势函数乘积的形式,并通过对随机变量所有状态进行全局求和/积分来归一化。这一量(即配分函数)及其梯度除最平凡的情形外都难以处理,不过可以通过马尔可夫链蒙特卡罗(MCMC)方法进行估计。混合问题给依赖MCMC的学习算法带来了显著困难[3, 5]。

深度信念网络(DBN)[16]是包含一个无向层和若干有向层的混合模型。尽管存在一种快速的近似逐层训练准则,但DBN同时承担了无向模型和有向模型相关的计算困难。

也有人提出了不对对数似然进行近似或求界的替代准则,例如分数匹配(score matching)[18]和噪声对比估计(NCE)[13]。这两种方法都要求所学习的概率密度在解析形式上可表示到一个归一化常数为止。需要指出的是,在许多包含多层潜变量的有趣生成模型中(例如DBN和DBM),甚至无法导出一个可处理的未归一化概率密度。一些模型,如去噪自编码器[30]和收缩自编码器,其学习规则与应用于RBM的分数匹配非常相似。在NCE中,与本文一样,采用判别式训练准则来拟合生成模型。然而,它不是拟合一个独立的判别模型,而是利用生成模型本身来区分生成数据与来自固定噪声分布的样本。由于NCE使用固定的噪声分布,当模型已经在观测变量的一个小子集上学到哪怕近似正确的分布之后,学习速度也会显著下降。

最后,一些技术并不显式定义概率分布,而是训练一个生成机器从目标分布中抽取样本。这种方法的优点在于,此类机器可以被设计为通过反向传播进行训练。该方向近期的重要工作包括生成随机网络(GSN)框架[5],它扩展了广义去噪自编码器[4]:两者都可以看作定义了一个参数化的马尔可夫链,即学习一个机器的参数,使其执行生成马尔可夫链中的一步。与GSN相比,对抗网络框架在采样时不需要马尔可夫链。由于对抗网络在生成过程中不需要反馈环路,因此能够更好地利用分段线性单元[19, 9, 10];这类单元能够提升反向传播的性能,但在反馈环路中使用时会面临激活值无界的问题。通过向生成机器内部反向传播来训练生成机器的更近期例子,包括关于自编码变分贝叶斯(auto-encoding variational Bayes)[20]和随机反向传播(stochastic backpropagation)[24]的最新工作。

3 对抗网络

当两个模型都是多层感知机时,对抗建模框架最容易应用。为了学习生成器在数据x\boldsymbol{x}上的分布pgp_g,我们定义输入噪声变量的先验分布pz(z)p_z(\boldsymbol{z}),然后将到数据空间的映射表示为G(z;θg)G(\boldsymbol{z}; \theta_g),其中GG是一个由参数θg\theta_g的多层感知机表示的可微函数。我们还定义第二个多层感知机D(x;θd)D(\boldsymbol{x}; \theta_d),其输出为单个标量。D(x)D(\boldsymbol{x})表示x\boldsymbol{x}来自数据而非pgp_g的概率。我们训练DD以最大化对训练样本和来自GG的样本都赋予正确标签的概率。同时,我们训练GG以最小化log⁡(1−D(G(z)))\log(1 - D(G(\boldsymbol{z}))):

换句话说,DD和GG进行如下以V(G,D)V(G,D)为价值函数的双人极小极大博弈:

min⁡Gmax⁡DV(D,G)=Ex∼pdata(x)[log⁡D(x)]+Ez∼pz(z)[log⁡(1−D(G(z)))].(1)\min_G \max_D V(D,G) = \mathbb{E}_{x\sim p_{\mathrm{data}}(x)}[\log D(x)] + \mathbb{E}_{z\sim p_z(z)}[\log(1-D(G(z)))]. \tag{1}
(1)

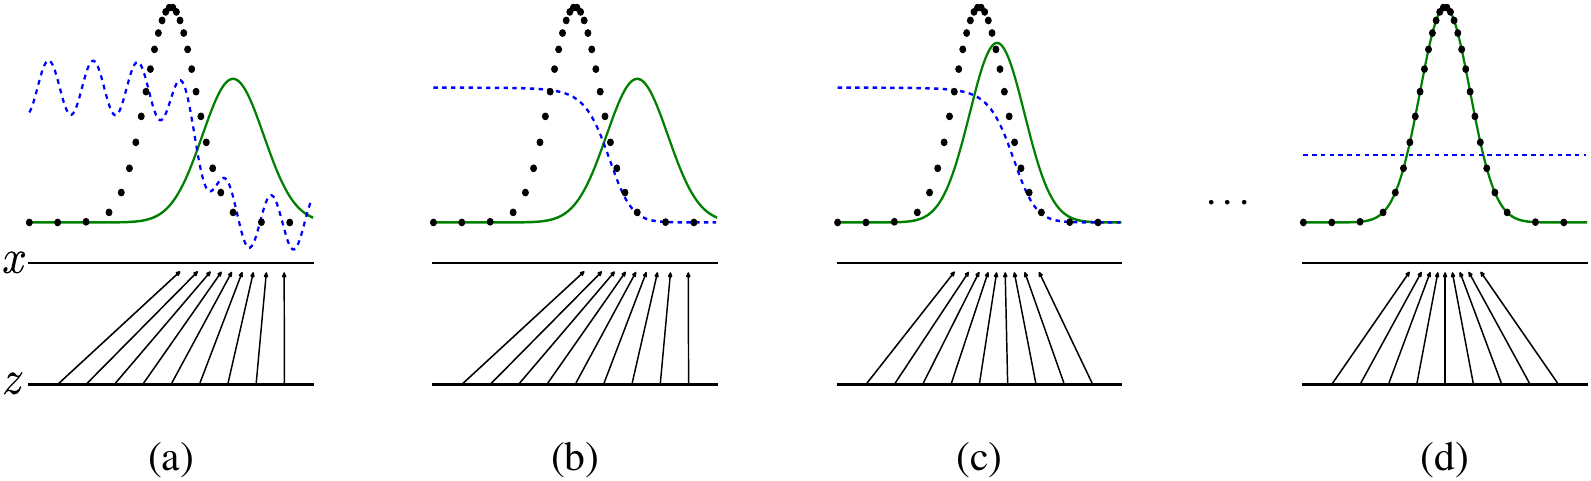
在下一节中,我们将给出对抗网络的理论分析,其本质是说明:当赋予GG和DD足够的容量时,即在非参数极限下,该训练准则能够恢复数据生成分布。关于该方法一种不那么正式、更具教学性的解释,请参见图 1。在实践中,我们必须采用迭代的数值方法来实现这一博弈。在训练的内层循环中将DD优化至完成在计算上代价过高,而且在有限数据集上会导致过拟合。相反,我们交替执行kk步对DD的优化和一步对GG的优化。只要GG变化得足够缓慢,这就能使DD始终维持在其最优解附近。这一策略类似于SML/PCD [31, 29]训练中的做法,即从一个学习步骤到下一个学习步骤持续维护来自马尔可夫链的样本,从而避免在学习的内层循环中对马尔可夫链进行预热。该过程在算法 1中进行了正式描述。

在实践中,公式 1可能无法为GG提供足够的梯度以实现良好学习。在学习初期,当GG表现较差时,DD能够以很高的置信度拒绝样本,因为它们与训练数据明显不同。在这种情况下,log⁡(1−D(G(z)))\log(1-D(G(z)))会饱和。与其训练GG去最小化log⁡(1−D(G(z)))\log(1-D(G(z))),我们可以训练GG去最大化log⁡D(G(z))\log D(G(z))。这一目标函数会产生与GG和DD动力学相同的不动点,但在学习初期能够提供强得多的梯度。

Figure 1
图 1:生成对抗网络通过同时更新判别分布(DD,蓝色虚线),使其能够区分来自数据生成分布(黑色点线)pxp_x的样本与来自生成分布pgp_g(GG)(绿色实线)的样本来进行训练。下方的水平线是对zz进行采样的定义域,在此情形下为均匀采样。上方的水平线是xx定义域的一部分。向上的箭头展示了映射x=G(z)x=G(z)如何在变换后的样本上施加非均匀分布pgp_g。GG在高密度区域收缩,在pgp_g的低密度区域扩张。(a) 考虑一个接近收敛的对抗博弈对:pgp_g与pdatap_{\mathrm{data}}相似,而DD是一个部分准确的分类器。(b) 在算法的内层循环中,训练DD以区分来自数据的样本,并收敛到D∗(x)=pdata(x)pdata(x)+pg(x)D^*(x)=\frac{p_{\mathrm{data}}(x)}{p_{\mathrm{data}}(x)+p_g(x)}。(c) 在对GG进行一次更新后,DD的梯度引导G(z)G(z)流向更有可能被分类为数据的区域。(d) 经过若干步训练后,如果GG和DD具有足够的容量,它们将达到一个双方都无法进一步改进的点,因为pg=pdatap_g=p_{\mathrm{data}}。判别器无法区分这两个分布,即D(x)=12D(x)=\frac{1}{2}。

4 理论结果

生成器GG将当z∼pzz\sim p_z时得到的样本G(z)G(z)的分布隐式定义为概率分布pgp_g。因此,如果给定足够的容量和训练时间,我们希望算法1能够收敛到pdatap_{\mathrm{data}}的一个良好估计器。本节的结果是在非参数设定下得到的,例如,我们通过研究概率密度函数空间中的收敛性来表示具有无限容量的模型。

我们将在4.1节中证明,当pg=pdatap_g=p_{\mathrm{data}}时,该极小极大博弈具有全局最优解。随后我们将在4.2节中证明算法1优化式1,从而得到期望的结果。

算法 1 生成对抗网络的小批量随机梯度下降训练。应用于判别器的步数kk是一个超参数。在我们的实验中使用了k=1k = 1,这是代价最低的选择。

for 训练迭代次数 do

for kk步 do

  • 从噪声先验pg(z)p_g(z)中采样包含mm个噪声样本的小批量{z(1),…,z(m)}\{z^{(1)}, \ldots, z^{(m)}\}。
  • 从数据生成分布pdata(x)p_{\text{data}}(x)中采样包含mm个样本的小批量{x(1),…,x(m)}\{x^{(1)}, \ldots, x^{(m)}\}。
  • 通过沿其随机梯度上升来更新判别器:
∇θd1m∑i=1m[log⁡D(x(i))+log⁡(1−D(G(z(i))))].\nabla_{\theta_d}\frac{1}{m}\sum_{i=1}^{m}\left[\log D\left(x^{(i)}\right)+\log\left(1-D\left(G\left(z^{(i)}\right)\right)\right)\right].

end for

  • 从噪声先验pg(z)p_g(z)中采样包含mm个噪声样本的小批量{z(1),…,z(m)}\{z^{(1)}, \ldots, z^{(m)}\}。
  • 通过沿其随机梯度下降来更新生成器:
∇θg1m∑i=1mlog⁡(1−D(G(z(i)))).\nabla_{\theta_g}\frac{1}{m}\sum_{i=1}^{m}\log\left(1-D\left(G\left(z^{(i)}\right)\right)\right).

end for

基于梯度的更新可以使用任何标准的基于梯度的学习规则。在我们的实验中使用了动量法。

4.1 pg=pdatap_g = p_{\text{data}}的全局最优性

我们首先考虑任意给定生成器GG对应的最优判别器DD。

命题 1. 对于固定的GG,最优判别器DD为

DG∗(x)=pdata(x)pdata(x)+pg(x)(2)D_G^*(x)=\frac{p_{\text{data}}(x)}{p_{\text{data}}(x)+p_g(x)}\tag{2}
(2)

证明。 给定任意生成器G,判别器D的训练准则是最大化量V(G,D)V(G,D)

V(G,D)=∫xpdata(x)log⁡(D(x))dx+∫zpz(z)log⁡(1−D(g(z)))dz=∫xpdata(x)log⁡(D(x))+pg(x)log⁡(1−D(x))dx(3)\begin{aligned} V(G,D)&=\int_x p_{\text{data}}(x)\log(D(x))dx+\int_z p_z(z)\log(1-D(g(z)))dz\\ &=\int_x p_{\text{data}}(x)\log(D(x))+p_g(x)\log(1-D(x))dx \end{aligned}\tag{3}
(3)

对于任意(a,b)∈R2∖{0,0}(a,b)\in\mathbb{R}^2\setminus\{0,0\},函数y→alog⁡(y)+blog⁡(1−y)y\rightarrow a\log(y)+b\log(1-y)在区间[0,1][0,1]上的最大值于aa+b\frac{a}{a+b}处取得。判别器无需在Supp(pdata)∪Supp(pg)Supp(p_{\text{data}})\cup Supp(p_g)之外定义,证明完成。□\square

注意,DD的训练目标可以解释为最大化用于估计条件概率P(Y=y∣x)P(Y=y|x)的对数似然,其中YY表示xx是来自pdatap_{\text{data}}(此时y=1y=1)还是来自pgp_g(此时y=0y=0)。式1中的极小极大博弈现在可以重写为:

C(G)=max⁡DV(G,D)=Ex∼pdata[log⁡DG∗(x)]+Ez∼pz[log⁡(1−DG∗(G(z)))]=Ex∼pdata[log⁡DG∗(x)]+Ex∼pg[log⁡(1−DG∗(x))]=Ex∼pdata[log⁡pdata(x)pdata(x)+pg(x)]+Ex∼pg[log⁡pg(x)pdata(x)+pg(x)](4)\begin{aligned} C(G)&=\max_D V(G,D)\\ &=\mathbb{E}_{x\sim p_{\text{data}}}\left[\log D_G^*(x)\right]+\mathbb{E}_{z\sim p_z}\left[\log(1-D_G^*(G(z)))\right]\\ &=\mathbb{E}_{x\sim p_{\text{data}}}\left[\log D_G^*(x)\right]+\mathbb{E}_{x\sim p_g}\left[\log(1-D_G^*(x))\right]\\ &=\mathbb{E}_{x\sim p_{\text{data}}}\left[\log\frac{p_{\text{data}}(x)}{p_{\text{data}}(x)+p_g(x)}\right]+\mathbb{E}_{x\sim p_g}\left[\log\frac{p_g(x)}{p_{\text{data}}(x)+p_g(x)}\right] \end{aligned}\tag{4}
(4)

定理 1. 虚拟训练准则C(G)C(G)的全局最小值当且仅当pg=pdatap_g = p_{\mathrm{data}}时达到。此时,C(G)C(G)取得值−log⁡4-\log 4。

证明。 当pg=pdatap_g = p_{\mathrm{data}}时,DG∗(x)=12D_G^*(x) = \frac{1}{2}(见式2)。因此,考察DG∗(x)=12D_G^*(x) = \frac{1}{2}时的式4,可得C(G)=log⁡12+log⁡12=−log⁡4C(G) = \log \frac{1}{2} + \log \frac{1}{2} = -\log 4。为了说明这是C(G)C(G)所能达到的最佳值,并且仅在pg=pdatap_g = p_{\mathrm{data}}时达到,注意到

Ex∼pdata[−log⁡2]+Ex∼pg[−log⁡2]=−log⁡4\mathbb{E}_{x\sim p_{\mathrm{data}}}[-\log 2] + \mathbb{E}_{x\sim p_g}[-\log 2] = -\log 4

并且从C(G)=V(DG∗,G)C(G) = V(D_G^*, G)中减去该表达式,我们得到:

C(G)=−log⁡(4)+KL(pdata∥pdata+pg2)+KL(pg∥pdata+pg2)(5)C(G) = -\log(4) + KL\left(p_{\mathrm{data}} \left\| \frac{p_{\mathrm{data}} + p_g}{2}\right.\right) + KL\left(p_g \left\| \frac{p_{\mathrm{data}} + p_g}{2}\right.\right) \tag{5}
(5)

其中 KL 是 Kullback–Leibler 散度。我们可以在前面的表达式中识别出模型分布与数据生成过程之间的 Jensen–Shannon 散度:

C(G)=−log⁡(4)+2⋅JSD(pdata∥pg)(6)C(G) = -\log(4) + 2 \cdot JSD(p_{\mathrm{data}} \| p_g) \tag{6}
(6)

由于两个分布之间的 Jensen–Shannon 散度总是非负的,并且仅当它们相等时才为零,我们已经证明C∗=−log⁡(4)C^* = -\log(4)是C(G)C(G)的全局最小值,并且唯一解为pg=pdatap_g = p_{\mathrm{data}},即生成模型完美复制了数据生成过程。□\square

4.2 算法 1 的收敛性

命题 2. 如果GG和DD具有足够的容量,并且在算法 1 的每一步中,判别器在给定GG的条件下都被允许达到其最优值,同时更新pgp_g以改进准则

Ex∼pdata[log⁡DG∗(x)]+Ex∼pg[log⁡(1−DG∗(x))]\mathbb{E}_{x\sim p_{\mathrm{data}}}[\log D_G^*(x)] + \mathbb{E}_{x\sim p_g}[\log(1 - D_G^*(x))]

则pgp_g收敛到pdatap_{\mathrm{data}}

证明。按照上述准则中的做法,将V(G,D)=U(pg,D)V(G, D) = U(p_g, D)视为pgp_g的函数。注意,U(pg,D)U(p_g, D)关于pgp_g是凸的。凸函数上确界的次导数包含达到最大值点处该函数的导数。换言之,如果f(x)=sup⁡α∈Afα(x)f(x) = \sup_{\alpha\in\mathcal{A}} f_\alpha(x),并且对每个α\alpha都有fα(x)f_\alpha(x)关于xx凸,那么当β=arg⁡sup⁡α∈Afα(x)\beta = \arg \sup_{\alpha\in\mathcal{A}} f_\alpha(x)时,∂fβ(x)∈∂f\partial f_\beta(x) \in \partial f。这等价于在对应GG给定时的最优DD处,对pgp_g计算一次梯度下降更新。根据定理 1 已证明的结果,sup⁡DU(pg,D)\sup_D U(p_g, D)关于pgp_g是凸的,并且具有唯一的全局最优解,因此当pgp_g的更新足够小时,pgp_g收敛到pxp_x,从而完成证明。□\square

在实践中,对抗网络通过函数G(z;θg)G(z; \theta_g)表示pgp_g分布的一个受限族,而我们优化的是θg\theta_g而非pgp_g本身。使用多层感知机来定义GG会在参数空间中引入多个临界点。然而,多层感知机在实践中的优异性能表明,尽管缺乏理论保证,它们仍然是合理可用的模型。

5 实验

我们在多个数据集上训练了对抗网络,包括MNIST[23]、Toronto Face Database(TFD)[28]以及CIFAR-10 [21]。生成器网络使用了整流线性激活函数[19, 9]与sigmoid激活函数的混合,而判别器网络使用了maxout [10]激活函数。在训练判别器网络时应用了Dropout [17]。尽管我们的理论框架允许在生成器的中间层使用dropout及其他噪声,但我们仅将噪声作为生成器网络最底层的输入。

我们通过对由GG生成的样本拟合高斯Parzen窗,并报告该分布下的对数似然,来估计测试集数据在pgp_g下的概率。σ\sigma参数

模型MNISTTFD
DBN [3]138±2138 \pm 21909±661909 \pm 66
Stacked CAE [3]121±1.6121 \pm 1.62110±50\mathbf{2110 \pm 50}
Deep GSN [6]214±1.1214 \pm 1.11890±291890 \pm 29
对抗网络225±2\mathbf{225 \pm 2}2057±26\mathbf{2057 \pm 26}

表 1:基于Parzen窗的对数似然估计。MNIST上的报告数值是测试集样本对数似然的均值,均值标准误差在样本间计算得到。在TFD上,我们在数据集各折之间计算标准误差,并使用每一折的验证集选择不同的σ\sigma。在TFD上,σ\sigma在每一折上通过交叉验证确定,并计算每一折上的平均对数似然。对于MNIST,我们与该数据集实值版本(而非二值版本)的其他模型进行比较。

这些高斯分布的参数通过在验证集上进行交叉验证得到。该过程由Breuleux et al. [8]提出,并用于多种无法计算精确似然的生成模型[25, 3, 5]。结果见表 1。这种似然估计方法具有较高方差,在高维空间中表现不佳,但据我们所知,它是当前可用的最佳方法。那些能够采样却无法直接估计似然的生成模型的发展,促使人们进一步研究如何评估此类模型。

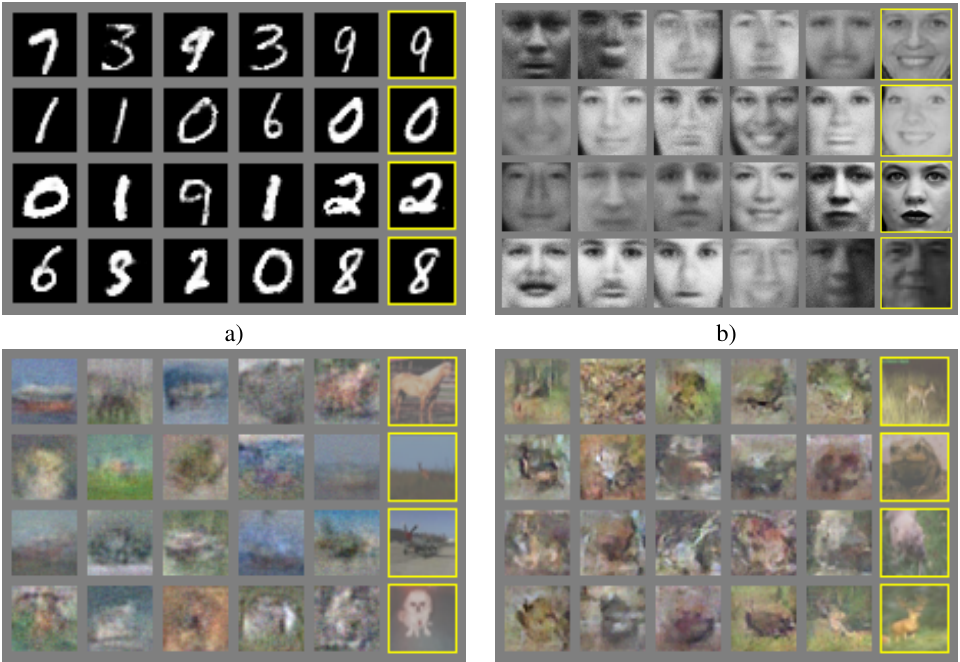
在图 2和图 3中,我们展示了训练后从生成器网络中抽取的样本。尽管我们并不声称这些样本优于现有方法生成的样本,但我们认为这些样本至少能够与文献中较好的生成模型相竞争,并体现了对抗框架的潜力。

Figure 2
图 2:模型样本的可视化。最右侧一列显示相邻样本最近的训练样本,用以证明模型并未记忆训练集。样本均为公平随机抽取,而非刻意挑选。与大多数其他深度生成模型的可视化不同,这些图像展示的是模型分布中的真实样本,而不是给定隐单元样本时的条件均值。此外,这些样本彼此不相关,因为采样过程不依赖于马尔可夫链混合。a)MNIST b)TFD c)CIFAR-10(全连接模型)d)CIFAR-10(卷积判别器与“反卷积”生成器)
Figure 3
图 3:通过在完整模型的zz空间坐标之间进行线性插值得到的数字。
深度有向图模型深度无向图模型生成式自编码器对抗模型
训练训练期间需要推理。训练期间需要推理。需要MCMC来近似配分函数梯度。在混合能力与重构生成能力之间强制权衡使判别器与生成器同步。Helvetica。
推理学习得到的近似推理变分推理基于MCMC的推理学习得到的近似推理
采样无困难需要马尔可夫链需要马尔可夫链无困难
评估p(x)p(x)不可处理,可用AIS近似不可处理,可用AIS近似未显式表示,可用Parzen密度估计近似未显式表示,可用Parzen密度估计近似
模型设计几乎所有模型都会遇到极大困难需要精心设计以保证多种性质理论上允许任意可微函数理论上允许任意可微函数

表 2:生成建模中的挑战:对深度生成建模不同方法在涉及模型的各项主要操作中所遇到困难的总结。

6 优势与劣势

与先前的建模框架相比,这一新框架既有优势也有劣势。其劣势主要在于不存在对pg(x)p_g(x)的显式表示,并且在训练过程中DD必须与GG保持良好同步(特别是,为了避免“Helvetica 情形”,即GG将过多的z\mathbf{z}取值坍缩到同一个x\mathbf{x}取值,从而缺乏足够的多样性来建模pdatap_{\text{data}},在不更新DD的情况下不能对GG进行过多训练);这一点类似于玻尔兹曼机的负链必须在学习步骤之间保持最新状态。其优势在于永远不需要马尔可夫链,只需使用反向传播来获得梯度,学习过程中不需要推理,并且可以将各种各样的函数纳入模型。表 2总结了生成对抗网络与其他生成建模方法的比较。

上述优势主要体现在计算方面。由于生成器网络并非直接利用数据样例进行更新,而仅通过流经判别器的梯度进行更新,对抗模型还可能因此获得某些统计上的优势。这意味着输入的各个组成部分不会被直接复制到生成器的参数中。对抗网络的另一个优势是,它们能够表示非常尖锐甚至退化的分布;而基于马尔可夫链的方法则要求分布具有一定程度的模糊性,以便链能够在不同模态之间实现混合。

7 结论与未来工作

该框架允许许多直接的扩展:

  1. 通过将c\mathbf{c}作为输入同时加入GG和DD,可以得到一个条件生成模型p(x∣c)p(\mathbf{x}\mid\mathbf{c})。
  2. 通过训练一个辅助网络来根据x\mathbf{x}预测z\mathbf{z},可以实现学习得到的近似推理。这与由wake-sleep算法[15]训练的推理网络类似,但其优点在于,在生成器网络完成训练之后,可以针对一个固定的生成器网络来训练推理网络。
  1. 通过训练一族共享参数的条件模型,可以近似地对所有条件分布p(xS∣xS̸)p(x_S \mid x_{\not S})进行建模,其中SS是xx的索引集合的一个子集。从本质上讲,可以利用对抗网络来实现确定性MP-DBM [11]的随机扩展。
  2. 半监督学习:来自判别器或推理网络的特征,能够在可用标注数据有限时提高分类器的性能。
  3. 效率改进:通过设计更好的方法来协调GG和DD,或者在训练期间确定更优的zz采样分布,可以大幅加速训练。

本文已经证明了对抗建模框架的可行性,表明这些研究方向可能是有价值的。

致谢

我们感谢Patrice Marcotte、Olivier Delalleau、Kyunghyun Cho、Guillaume Alain和Jason Yosinski所进行的富有帮助的讨论。Yann Dauphin与我们分享了他的Parzen窗评估代码。我们感谢Pylearn2 [12]和Theano [7, 1]的开发者,尤其是Frédéric Bastien,他分享了一项专门为本项目提供帮助的Theano特性。Arnaud Bergeron在LaTeX\LaTeX排版方面提供了极其重要的支持。我们还感谢CIFAR和Canada Research Chairs提供资金支持,并感谢Compute Canada和Calcul Québec提供计算资源。Ian Goodfellow获得了2013年Google深度学习奖学金的资助。最后,我们感谢Les Trois Brasseurs激发了我们的创造力。

Notes

  1. Jean Pouget-Abadie从Ecole Polytechnique访问蒙特利尔大学。
  2. Sherjil Ozair从Indian Institute of Technology Delhi访问蒙特利尔大学
  3. Yoshua Bengio是CIFAR高级研究员。
  4. 所有代码和超参数可在http://www.github.com/goodfeli/adversarial获得

References

  1. Bastien, F., Lamblin, P., Pascanu, R., Bergstra, J., Goodfellow, I. J., Bergeron, A., Bouchard, N., and Bengio, Y. (2012). Theano: new features and speed improvements. Deep Learning and Unsupervised Feature Learning NIPS 2012 Workshop.
  2. Bengio, Y. (2009). *Learning deep architectures for AI.* Now Publishers.
  3. Bengio, Y., Mesnil, G., Dauphin, Y., and Rifai, S. (2013a). Better mixing via deep representations. In *ICML’13*.
  4. Bengio, Y., Yao, L., Alain, G., and Vincent, P. (2013b). Generalized denoising auto-encoders as generative models. In *NIPS26*. Nips Foundation.
  5. Bengio, Y., Thibodeau-Laufer, E., and Yosinski, J. (2014a). Deep generative stochastic networks trainable by backprop. In *ICML’14*.
  6. Bengio, Y., Thibodeau-Laufer, E., Alain, G., and Yosinski, J. (2014b). Deep generative stochastic networks trainable by backprop. In *Proceedings of the 30th International Conference on Machine Learning (ICML’14)*.
  7. Bergstra, J., Breuleux, O., Bastien, F., Lamblin, P., Pascanu, R., Desjardins, G., Turian, J., Warde-Farley, D., and Bengio, Y. (2010). Theano: a CPU and GPU math expression compiler. In *Proceedings of the Python for Scientific Computing Conference (SciPy)*. Oral Presentation.
  8. Breuleux, O., Bengio, Y., and Vincent, P. (2011). Quickly generating representative samples from an RBM-derived process. *Neural Computation*, **23**(8), 2053–2073.
  9. Glorot, X., Bordes, A., and Bengio, Y. (2011). Deep sparse rectifier neural networks. In *AISTATS’2011*.
  10. Goodfellow, I. J., Warde-Farley, D., Mirza, M., Courville, A., and Bengio, Y. (2013a). Maxout networks. In *ICML’2013*.
  11. Goodfellow, I. J., Mirza, M., Courville, A., and Bengio, Y. (2013b). Multi-prediction deep Boltzmann machines. In *NIPS’2013*.
  12. Goodfellow, I. J., Warde-Farley, D., Lamblin, P., Dumoulin, V., Mirza, M., Pascanu, R., Bergstra, J., Bastien, F., and Bengio, Y. (2013c). Pylearn2: a machine learning research library. *arXiv preprint arXiv:1308.4214*.
  13. Gutmann, M. and Hyvarinen, A. (2010). Noise-contrastive estimation: A new estimation principle for unnormalized statistical models. In *AISTATS’2010*.
  14. Hinton, G., Deng, L., Dahl, G. E., Mohamed, A., Jaitly, N., Senior, A., Vanhoucke, V., Nguyen, P., Sainath, T., and Kingsbury, B. (2012a). Deep neural networks for acoustic modeling in speech recognition. *IEEE Signal Processing Magazine*, **29**(6), 82–97.
  15. Hinton, G. E., Dayan, P., Frey, B. J., and Neal, R. M. (1995). The wake-sleep algorithm for unsupervised neural networks. *Science*, **268**, 1558–1161.
  16. Hinton, G. E., Osindero, S., and Teh, Y. (2006). A fast learning algorithm for deep belief nets. *Neural Computation*, **18**, 1527–1554.
  17. Hinton, G. E., Srivastava, N., Krizhevsky, A., Sutskever, I., and Salakhutdinov, R. (2012b). Improving neural networks by preventing co-adaptation of feature detectors. Technical report, arXiv:1207.0580.
  18. Hyvärinen, A. (2005). Estimation of non-normalized statistical models using score matching. *J. Machine Learning Res.*, **6**.
  19. Jarrett, K., Kavukcuoglu, K., Ranzato, M., and LeCun, Y. (2009). What is the best multi-stage architecture for object recognition? In *Proc. International Conference on Computer Vision (ICCV’09)*, pages 2146–2153. IEEE.
  20. Kingma, D. P. and Welling, M. (2014). Auto-encoding variational bayes. In *Proceedings of the International Conference on Learning Representations (ICLR)*.
  21. Krizhevsky, A. and Hinton, G. (2009). Learning multiple layers of features from tiny images. Technical report, University of Toronto.
  22. Krizhevsky, A., Sutskever, I., and Hinton, G. (2012). ImageNet classification with deep convolutional neural networks. In *NIPS’2012*. Read it here
  23. LeCun, Y., Bottou, L., Bengio, Y., and Haffner, P. (1998). Gradient-based learning applied to document recognition. *Proceedings of the IEEE*, **86**(11), 2278–2324. Read it here
  24. Rezende, D. J., Mohamed, S., and Wierstra, D. (2014). Stochastic backpropagation and approximate inference in deep generative models. Technical report, arXiv:1401.4082.
  25. Rifai, S., Bengio, Y., Dauphin, Y., and Vincent, P. (2012). A generative process for sampling contractive auto-encoders. In *ICML’12*.
  26. Salakhutdinov, R. and Hinton, G. E. (2009). Deep Boltzmann machines. In *AISTATS’2009*, pages 448–455.
  27. Smolensky, P. (1986). Information processing in dynamical systems: Foundations of harmony theory. In D. E. Rumelhart and J. L. McClelland, editors, *Parallel Distributed Processing*, volume 1, chapter 6, pages 194–281. MIT Press, Cambridge.
  28. Susskind, J., Anderson, A., and Hinton, G. E. (2010). The Toronto face dataset. Technical Report UTML TR 2010-001, U. Toronto.
  29. Tieleman, T. (2008). Training restricted Boltzmann machines using approximations to the likelihood gradient. In W. W. Cohen, A. McCallum, and S. T. Roweis, editors, *ICML 2008*, pages 1064–1071. ACM.
  30. Vincent, P., Larochelle, H., Bengio, Y., and Manzagol, P.-A. (2008). Extracting and composing robust features with denoising autoencoders. In *ICML 2008*.
  31. Younes, L. (1999). On the convergence of Markovian stochastic algorithms with rapidly decreasing ergodicity rates. *Stochastics and Stochastic Reports*, **65**(3), 177–228.

Read off the page by a vision model reading the page images using gpt-6-astra. Translated into 中文 by gpt-5, against glossary version 5. Translated from the English.