arXiv:1512.03385v1 [cs.CV] 10 Dec 2015
Học dư sâu cho nhận dạng ảnh
Kaiming He Xiangyu Zhang Shaoqing Ren Jian Sun
Microsoft Research
{kahe, v-xiangz, v-shren, jiansun}@microsoft.com
Tóm tắt
Mạng nơ-ron sâu hơn khó huấn luyện hơn. Chúng tôi trình bày một khung học dư để giúp việc huấn luyện các mạng sâu hơn đáng kể so với những mạng được sử dụng trước đây. Chúng tôi định dạng lại rõ ràng các lớp thành việc học các hàm dư với tham chiếu đến các đầu vào của lớp, thay vì học các hàm không có tham chiếu. Chúng tôi cung cấp bằng chứng thực nghiệm toàn diện cho thấy các mạng dư này dễ tối ưu hóa hơn, và có thể đạt được độ chính xác từ việc tăng độ sâu đáng kể. Trên tập dữ liệu ImageNet, chúng tôi đánh giá các mạng dư có độ sâu lên tới 152 lớp—sâu hơn 8× so với các mạng VGG [41] nhưng vẫn có độ phức tạp thấp hơn. Một tổ hợp các mạng dư này đạt được lỗi 3.57% trên tập kiểm thử ImageNet. Kết quả này giành vị trí thứ 1 trong nhiệm vụ phân loại ILSVRC 2015. Chúng tôi cũng trình bày phân tích trên CIFAR-10 với 100 và 1000 lớp.
Độ sâu của các biểu diễn có tầm quan trọng trung tâm đối với nhiều nhiệm vụ nhận dạng thị giác. Chỉ nhờ các biểu diễn cực kỳ sâu của chúng tôi, chúng tôi đạt được mức cải thiện tương đối 28% trên tập dữ liệu phát hiện đối tượng COCO. Các mạng dư sâu là nền tảng cho các bài nộp của chúng tôi tới các cuộc thi ILSVRC & COCO 20151, nơi chúng tôi cũng giành các vị trí thứ 1 trong các nhiệm vụ phát hiện ImageNet, định vị ImageNet, phát hiện COCO, và phân đoạn COCO.
1 Giới thiệu
Các mạng nơ-ron tích chập sâu [22], [21] đã dẫn đến một loạt đột phá trong phân loại ảnh [21], [50], [40]. Các mạng sâu tự nhiên tích hợp các đặc trưng mức thấp/trung bình/cao [50] và các bộ phân loại theo cách nhiều lớp đầu-cuối, và các “mức” của đặc trưng có thể được làm phong phú hơn bởi số lượng lớp được xếp chồng (độ sâu). Các bằng chứng gần đây [41, 44] cho thấy độ sâu của mạng có tầm quan trọng then chốt, và các kết quả dẫn đầu [41, 44, 13, 16] trên tập dữ liệu ImageNet đầy thách thức [36] đều khai thác các mô hình “rất sâu” [41], với độ sâu từ mười sáu [41] đến ba mươi [16]. Nhiều tác vụ nhận dạng thị giác không tầm thường khác [8, 12, 7, 32, 27] cũng đã thu được nhiều lợi ích từ các mô hình rất sâu.
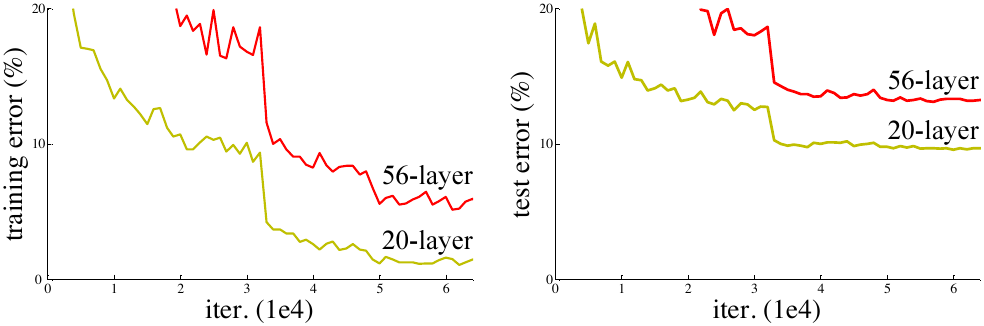
Bị thúc đẩy bởi tầm quan trọng của độ sâu, một câu hỏi được đặt ra: \Liệu việc học các mạng tốt hơn có dễ dàng như việc xếp chồng thêm các lớp không?\ Một trở ngại để trả lời câu hỏi này là vấn đề nổi tiếng về gradient biến mất/bùng nổ [1, 9], gây cản trở sự hội tụ ngay từ đầu. Tuy nhiên, vấn đề này phần lớn đã được giải quyết bằng khởi tạo được chuẩn hóa [23, 9, 37, 13] và các lớp chuẩn hóa trung gian [16], cho phép các mạng với hàng chục lớp bắt đầu hội tụ khi thực hiện giảm gradient ngẫu nhiên (SGD) với lan truyền ngược [22].
Khi các mạng sâu hơn có thể bắt đầu hội tụ, một vấn đề \suy giảm\ đã được phát hiện: khi độ sâu của mạng tăng lên, độ chính xác đạt trạng thái bão hòa (điều này có thể không đáng ngạc nhiên) và sau đó suy giảm nhanh chóng. Không ngờ rằng, sự suy giảm như vậy \không phải do quá khớp\, và việc thêm nhiều lớp hơn vào một mô hình đủ sâu dẫn đến \lỗi huấn luyện cao hơn\, như được báo cáo trong [11, 42] và được xác minh kỹ lưỡng bởi các thí nghiệm của chúng tôi. Hình 1 cho thấy một ví dụ điển hình.
Sự suy giảm (của độ chính xác huấn luyện) cho thấy không phải tất cả các hệ thống đều dễ tối ưu hóa như nhau. Hãy xem xét một kiến trúc nông hơn và phiên bản sâu hơn tương ứng của nó, bổ sung thêm các lớp vào đó. Tồn tại một giải pháp \bằng cách xây dựng\ cho mô hình sâu hơn: các lớp được thêm vào là \ánh xạ đồng nhất\, và các lớp còn lại được sao chép từ mô hình nông hơn đã được học. Sự tồn tại của giải pháp được xây dựng này cho thấy rằng một mô hình sâu hơn sẽ không tạo ra lỗi huấn luyện cao hơn so với phiên bản nông hơn tương ứng. Nhưng các thí nghiệm cho thấy rằng các bộ giải hiện có của chúng tôi không thể tìm thấy các giải pháp
có chất lượng tương đương hoặc tốt hơn giải pháp được xây dựng (hoặc không thể thực hiện điều đó trong thời gian khả thi).
Trong bài báo này, chúng tôi giải quyết vấn đề suy giảm bằng cách giới thiệu một khung \học phần dư sâu\. Thay vì hy vọng rằng mỗi vài lớp được xếp chồng sẽ trực tiếp khớp với ánh xạ nền tảng mong muốn, chúng tôi cho phép rõ ràng các lớp này khớp với một ánh xạ phần dư. Về mặt hình thức, ký hiệu ánh xạ nền tảng mong muốn là , chúng tôi cho phép các lớp phi tuyến được xếp chồng khớp với một ánh xạ khác . Ánh xạ ban đầu được chuyển đổi thành . Chúng tôi đưa ra giả thuyết rằng việc tối ưu hóa ánh xạ phần dư dễ hơn so với tối ưu hóa ánh xạ ban đầu, không có tham chiếu. Ở mức cực đoan, nếu một ánh xạ đồng nhất là tối ưu, việc đẩy phần dư về không sẽ dễ hơn so với việc khớp một ánh xạ đồng nhất bằng một chồng các lớp phi tuyến.
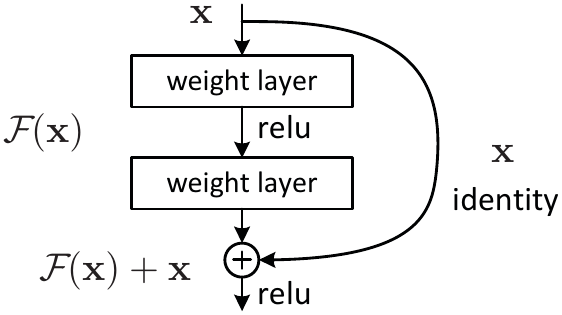
Cách biểu diễn có thể được hiện thực hóa bởi các mạng nơ-ron truyền thẳng với các “kết nối tắt” (Hình 2). Các kết nối tắt [2, 34, 49] là những kết nối bỏ qua một hoặc nhiều lớp. Trong trường hợp của chúng tôi, các kết nối tắt chỉ đơn giản thực hiện ánh xạ \đồng nhất\, và đầu ra của chúng được cộng vào đầu ra của các lớp được xếp chồng (Hình 2). Các kết nối tắt đồng nhất không thêm bất kỳ tham số bổ sung nào cũng như độ phức tạp tính toán. Toàn bộ mạng vẫn có thể được huấn luyện đầu-cuối bằng SGD với lan truyền ngược, và có thể dễ dàng được triển khai bằng cách sử dụng các thư viện thông dụng (\ví dụ\, Caffe [19]) mà không cần sửa đổi các bộ giải.
Chúng tôi trình bày các thí nghiệm toàn diện trên ImageNet [36] để chỉ ra vấn đề suy giảm và đánh giá phương pháp của mình. Chúng tôi chỉ ra rằng: 1) Các mạng dư cực sâu của chúng tôi dễ tối ưu hóa, nhưng các mạng “thuần” tương ứng (chỉ đơn giản xếp chồng các lớp) thể hiện lỗi huấn luyện cao hơn khi độ sâu tăng lên; 2) Các mạng dư sâu của chúng tôi có thể dễ dàng thu được lợi ích về độ chính xác từ việc tăng độ sâu đáng kể, tạo ra các kết quả tốt hơn nhiều so với các mạng trước đây.
Các hiện tượng tương tự cũng được thể hiện trên tập CIFAR-10 [20], cho thấy rằng những khó khăn trong tối ưu hóa và các tác động của phương pháp của chúng tôi không chỉ tương tự với một tập dữ liệu cụ thể. Chúng tôi trình bày các mô hình được huấn luyện thành công trên tập dữ liệu này với hơn 100 lớp, và khảo sát các mô hình với hơn 1000 lớp.
Trên tập dữ liệu phân loại ImageNet [36], chúng tôi thu được các kết quả xuất sắc bằng các mạng dư cực sâu. Mạng dư 152 lớp của chúng tôi là mạng sâu nhất từng được trình bày trên ImageNet, đồng thời vẫn có độ phức tạp thấp hơn các mạng VGG [41]. Tổ hợp của chúng tôi có lỗi top-5 \\3.57%\\ trên tập \kiểm thử\ ImageNet, và \giành vị trí thứ nhất trong cuộc thi phân loại ILSVRC 2015\. Các biểu diễn cực sâu cũng có hiệu năng tổng quát hóa xuất sắc trên các tác vụ nhận dạng khác, và giúp chúng tôi tiếp tục \giành các vị trí thứ nhất trong: phát hiện ImageNet, định vị ImageNet, phát hiện COCO, và phân đoạn COCO\ trong các cuộc thi ILSVRC & COCO 2015. Bằng chứng mạnh mẽ này cho thấy nguyên lý học phần dư là tổng quát, và chúng tôi kỳ vọng rằng nó có thể áp dụng cho các vấn đề thị giác và phi thị giác khác.
2 Công trình liên quan
Biểu diễn phần dư. Trong nhận dạng ảnh, VLAD [18] là một biểu diễn mã hóa bằng các vectơ phần dư đối với một từ điển, và Fisher Vector [30] có thể được xây dựng như một phiên bản xác suất [18] của VLAD. Cả hai đều là các biểu diễn nông mạnh mẽ cho truy hồi ảnh và phân loại [4, 48]. Đối với lượng tử hóa vectơ, việc mã hóa các vectơ phần dư [17] được cho thấy hiệu quả hơn so với việc mã hóa các vectơ gốc.
Trong thị giác mức thấp và đồ họa máy tính, để giải các Phương trình Vi phân Riêng phần (PDEs), phương pháp Multigrid được sử dụng rộng rãi [3] cải tổ hệ thống thành các bài toán con ở nhiều tỷ lệ, trong đó mỗi bài toán con chịu trách nhiệm cho nghiệm phần dư giữa một tỷ lệ thô hơn và một tỷ lệ mịn hơn. Một phương án thay thế cho Multigrid là tiền điều kiện hóa cơ sở phân cấp [45, 46], dựa trên các biến biểu diễn các vectơ phần dư giữa hai tỷ lệ. Đã được chứng minh [3, 45, 46] rằng các bộ giải này hội tụ nhanh hơn nhiều so với các bộ giải tiêu chuẩn không nhận biết bản chất phần dư của các nghiệm. Các phương pháp này cho thấy rằng một cách cải tổ hoặc tiền điều kiện hóa tốt có thể đơn giản hóa quá trình tối ưu hóa.
Kết nối tắt. Các thực hành và lý thuyết dẫn đến các kết nối tắt [2, 34, 49] đã được nghiên cứu trong một thời gian dài. Một thực hành ban đầu trong việc huấn luyện các perceptron nhiều lớp (MLPs) là thêm một lớp tuyến tính được kết nối từ đầu vào mạng đến đầu ra [34, 49]. Trong [44, 24], một vài lớp trung gian được kết nối trực tiếp với các bộ phân loại phụ để xử lý các gradient biến mất/bùng nổ. Các bài báo [39, 38, 31, 47] đề xuất các phương pháp căn giữa các phản hồi của lớp, các gradient và các lỗi được lan truyền, được triển khai bằng các kết nối tắt. Trong [44], một lớp “inception” được cấu thành từ một nhánh tắt và một vài nhánh sâu hơn.
Đồng thời với công trình của chúng tôi, “mạng đường cao tốc” [42, 43] đưa ra các kết nối tắt với các hàm cổng [15]. Các cổng này phụ thuộc vào dữ liệu và có các tham số, trái ngược với các kết nối tắt ánh xạ đồng nhất của chúng tôi không có tham số. Khi một kết nối tắt có cổng bị “đóng” (tiến gần đến không), các lớp trong mạng đường cao tốc biểu diễn các hàm không phần dư. Ngược lại, công thức của chúng tôi luôn học các hàm phần dư; các kết nối tắt ánh xạ đồng nhất của chúng tôi không bao giờ bị đóng, và mọi thông tin luôn được truyền qua, cùng với các hàm phần dư bổ sung cần được học. Ngoài ra, mạng đường cao tốc chưa chứng minh được sự tăng độ chính xác với độ sâu tăng cực lớn (, trên 100 lớp).
3 Học sâu dư thừa
3.1. Học dư thừa
Xét là một ánh xạ nền tảng cần được khớp bởi một vài lớp xếp chồng (không nhất thiết là toàn bộ mạng), với biểu thị các đầu vào của lớp đầu tiên trong số các lớp này. Nếu giả thuyết rằng nhiều lớp phi tuyến có thể xấp xỉ tiệm cận các hàm phức tạp1, thì tương đương với việc giả thuyết rằng chúng có thể xấp xỉ tiệm cận các hàm dư thừa, , (giả sử đầu vào và đầu ra có cùng số chiều). Vì vậy, thay vì kỳ vọng các lớp xếp chồng xấp xỉ , chúng tôi cho phép rõ ràng các lớp này xấp xỉ một hàm dư thừa . Do đó, hàm ban đầu trở thành . Mặc dù cả hai dạng đều có thể xấp xỉ tiệm cận các hàm mong muốn (như đã giả thuyết), mức độ dễ học có thể khác nhau.
Cách cải biến này được thúc đẩy bởi các hiện tượng phản trực giác liên quan đến vấn đề suy giảm (Hình 1, bên trái). Như chúng tôi đã thảo luận trong phần giới thiệu, nếu các lớp được thêm vào có thể được xây dựng dưới dạng các ánh xạ đồng nhất, một mô hình sâu hơn sẽ có lỗi huấn luyện không lớn hơn mô hình tương ứng nông hơn của nó. Vấn đề suy giảm cho thấy các bộ giải có thể gặp khó khăn trong việc xấp xỉ các ánh xạ đồng nhất bằng nhiều lớp phi tuyến. Với cách cải biến học dư thừa, nếu các ánh xạ đồng nhất là tối ưu, các bộ giải có thể đơn giản đưa các trọng số của nhiều lớp phi tuyến về gần bằng không để tiến gần đến các ánh xạ đồng nhất.
Trong các trường hợp thực tế, khó có khả năng các ánh xạ đồng nhất là tối ưu, nhưng cách cải biến của chúng tôi có thể giúp tiền điều kiện hóa vấn đề. Nếu hàm tối ưu gần với một ánh xạ đồng nhất hơn là một ánh xạ không, bộ giải sẽ dễ dàng tìm thấy các nhiễu động có tham chiếu đến một ánh xạ đồng nhất hơn là học hàm đó như một hàm mới. Chúng tôi chỉ ra bằng các thí nghiệm (Hình 7) rằng các hàm dư thừa được học nhìn chung có phản hồi nhỏ, cho thấy các ánh xạ đồng nhất cung cấp sự tiền điều kiện hóa hợp lý.
3.2. Ánh xạ đồng nhất bằng các đường tắt
Chúng tôi áp dụng học dư thừa cho mỗi vài lớp xếp chồng. Một khối xây dựng được minh họa trong Hình 2. Về mặt hình thức, trong bài báo này chúng tôi xem xét một khối xây dựng được định nghĩa như sau:
Ở đây và là các vectơ đầu vào và đầu ra của các lớp được xem xét. Hàm biểu diễn ánh xạ dư thừa cần được học. Đối với ví dụ trong Hình 2 có hai lớp, trong đó biểu thị ReLU [29] và các độ lệch được bỏ qua để đơn giản hóa ký hiệu. Phép toán được thực hiện bởi một kết nối đường tắt và phép cộng theo từng phần tử. Chúng tôi áp dụng tính phi tuyến thứ hai sau phép cộng (, , xem Hình 2).
Các kết nối đường tắt trong Eqn.(1) không đưa vào thêm tham số hay độ phức tạp tính toán nào. Điều này không chỉ hấp dẫn trong thực tế mà còn quan trọng trong các so sánh của chúng tôi giữa mạng thông thường và mạng dư thừa. Chúng tôi có thể so sánh công bằng các mạng thông thường/dư thừa đồng thời có cùng số lượng tham số, độ sâu, độ rộng và chi phí tính toán (ngoại trừ phép cộng theo từng phần tử không đáng kể).
Các số chiều của và phải bằng nhau trong Eqn.(1). Nếu không phải vậy (, khi thay đổi các kênh đầu vào/đầu ra), chúng tôi có thể thực hiện phép chiếu tuyến tính thông qua các kết nối đường tắt để khớp các số chiều:
Chúng tôi cũng có thể sử dụng một ma trận vuông trong Eqn.(1). Nhưng chúng tôi sẽ chỉ ra bằng các thí nghiệm rằng ánh xạ đồng nhất là đủ để giải quyết vấn đề suy giảm và mang tính kinh tế, do đó chỉ được sử dụng khi khớp các số chiều.
Dạng của hàm dư thừa rất linh hoạt. Các thí nghiệm trong bài báo này liên quan đến một hàm có hai hoặc ba lớp (Hình 5), trong khi có thể có nhiều lớp hơn. Nhưng nếu chỉ có một lớp đơn, Eqn.(1) tương tự như một lớp tuyến tính: , và chúng tôi chưa quan sát thấy ưu điểm nào đối với trường hợp này.
Chúng tôi cũng lưu ý rằng mặc dù các ký hiệu trên nói về các lớp kết nối đầy đủ để đơn giản hóa, chúng vẫn áp dụng được cho các lớp tích chập. Hàm có thể biểu diễn nhiều lớp tích chập. Phép cộng theo từng phần tử được thực hiện trên hai bản đồ đặc trưng, theo từng kênh.
3.3. Các kiến trúc mạng
Chúng tôi đã kiểm thử nhiều mạng thông thường/dư thừa khác nhau và quan sát thấy các hiện tượng nhất quán. Để cung cấp các ví dụ cho việc thảo luận, chúng tôi mô tả hai mô hình cho ImageNet như sau.
Mạng thông thường. Các đường cơ sở thông thường của chúng tôi (Hình 3, giữa) chủ yếu được truyền cảm hứng bởi triết lý của các mạng VGG [41] (Hình 3, trái). Các lớp tích chập chủ yếu có các bộ lọc và tuân theo hai quy tắc thiết kế đơn giản: (i) đối với cùng kích thước bản đồ đặc trưng đầu ra, các lớp có cùng số lượng bộ lọc; và (ii) nếu kích thước bản đồ đặc trưng giảm một nửa, số lượng bộ lọc tăng gấp đôi để duy trì độ phức tạp thời gian trên mỗi lớp. Chúng tôi thực hiện giảm mẫu trực tiếp bằng các lớp tích chập có bước chạy là 2. Mạng kết thúc với một lớp pooling trung bình toàn cục và một lớp kết nối đầy đủ 1000 chiều với softmax. Tổng số lớp có trọng số là 34 trong Hình 3 (giữa).
Đáng chú ý là mô hình của chúng tôi có ít bộ lọc hơn và độ phức tạp thấp hơn so với các mạng VGG [41] (Hình 3, trái). Đường cơ sở 34 lớp của chúng tôi có 3.6 tỷ FLOPs (multipy-adds), chỉ bằng 18% của VGG-19 (19.6 tỷ FLOPs).
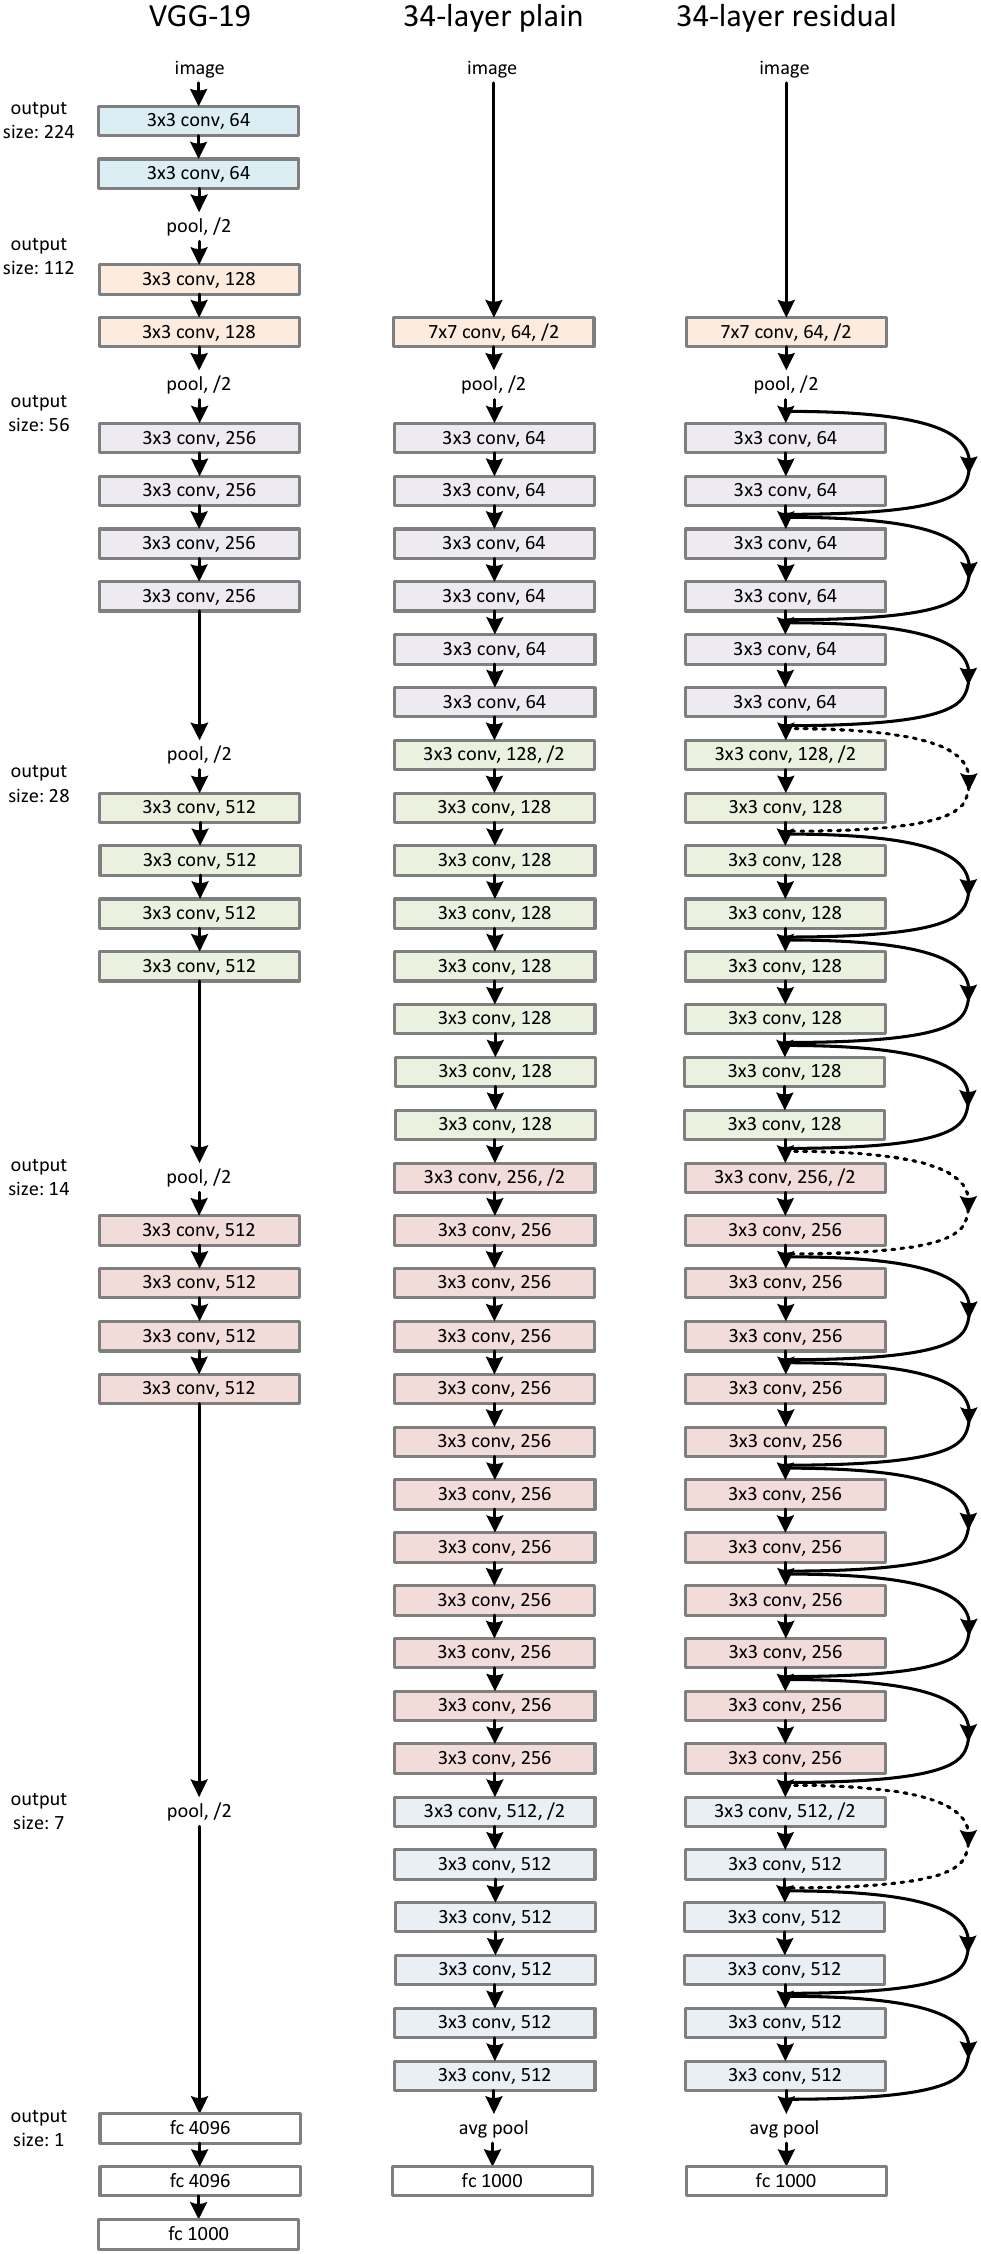
Mạng dư. Dựa trên mạng thường ở trên, chúng tôi chèn các kết nối tắt (Hình 3, bên phải) để biến mạng thành phiên bản dư tương ứng. Các kết nối tắt ánh xạ đồng nhất (Eqn.(1)) có thể được sử dụng trực tiếp khi đầu vào và đầu ra có cùng kích thước (các kết nối tắt đường liền trong Hình 3). Khi kích thước tăng lên (các kết nối tắt đường chấm trong Hình 3), chúng tôi xem xét hai tùy chọn: (A) Kết nối tắt vẫn thực hiện ánh xạ đồng nhất, với các phần tử không bổ sung được đệm thêm để tăng kích thước. Tùy chọn này không đưa thêm tham số nào; (B) Kết nối tắt phép chiếu trong Eqn.(2) được sử dụng để khớp kích thước (thực hiện bằng các tích chập ). Với cả hai tùy chọn, khi các kết nối tắt đi qua các bản đồ đặc trưng có hai kích thước, chúng được thực hiện với bước nhảy bằng 2.
3.4. Triển khai
Triển khai của chúng tôi cho ImageNet tuân theo thực hành trong [21], [41]. Ảnh được thay đổi kích thước với cạnh ngắn hơn được lấy mẫu ngẫu nhiên trong để tăng cường theo tỷ lệ [41]. Một vùng cắt được lấy mẫu ngẫu nhiên từ một ảnh hoặc ảnh lật ngang của nó, với giá trị trung bình trên mỗi điểm ảnh được trừ đi [21]. Phép tăng cường màu chuẩn trong [21] được sử dụng. Chúng tôi áp dụng chuẩn hóa theo lô (BN) [16] ngay sau mỗi phép tích chập và trước khi kích hoạt, theo [16]. Chúng tôi khởi tạo các trọng số như trong [13] và huấn luyện tất cả các mạng thường/dư từ đầu. Chúng tôi sử dụng SGD với kích thước lô nhỏ là 256. Tốc độ học bắt đầu từ 0.1 và được chia cho 10 khi lỗi đạt trạng thái bão hòa, và các mô hình được huấn luyện tối đa lần lặp. Chúng tôi sử dụng suy giảm trọng số là 0.0001 và động lượng là 0.9. Chúng tôi không sử dụng dropout [14], theo thực hành trong [16].
Trong kiểm thử, để so sánh các nghiên cứu, chúng tôi áp dụng phép kiểm thử cắt 10 vùng tiêu chuẩn [21]. Để đạt kết quả tốt nhất, chúng tôi áp dụng dạng tích chập đầy đủ như trong [41, 13], và lấy trung bình các điểm số ở nhiều tỷ lệ (các ảnh được thay đổi kích thước sao cho cạnh ngắn hơn nằm trong ).
4 Thí nghiệm
4.1. Phân loại ImageNet
Chúng tôi đánh giá phương pháp của mình trên tập dữ liệu phân loại ImageNet 2012 [36] gồm 1000 lớp. Các mô hình được huấn luyện trên 1,28 triệu ảnh huấn luyện, và được đánh giá trên 50k ảnh xác thực. Chúng tôi cũng thu được kết quả cuối cùng trên 100k ảnh kiểm thử, được báo cáo bởi server kiểm thử. Chúng tôi đánh giá cả tỷ lệ lỗi top-1 và top-5.
Mạng Thuần. Trước tiên chúng tôi đánh giá các mạng thuần 18 lớp và 34 lớp. Mạng thuần 34 lớp được trình bày trong Hình 3 (giữa). Mạng thuần 18 lớp có dạng tương tự. Xem Bảng 1 để biết các kiến trúc chi tiết.
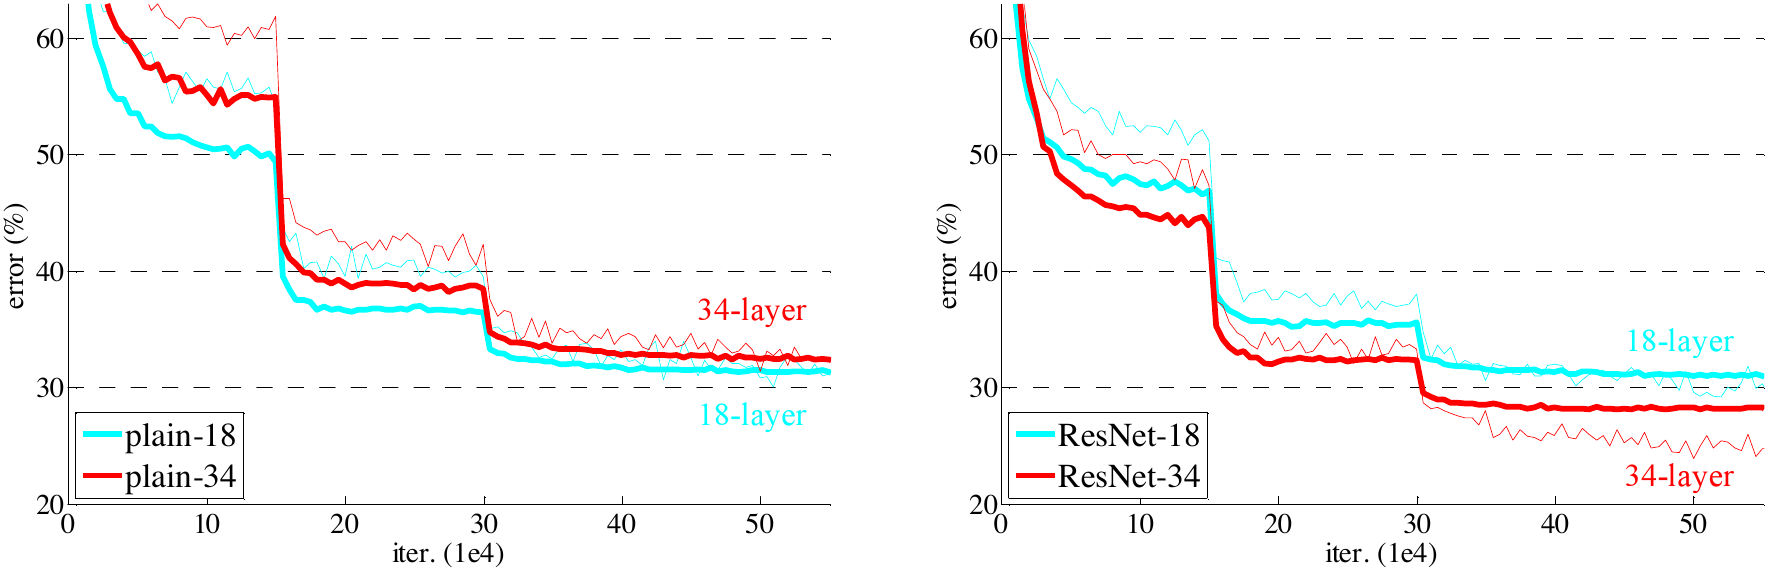
Các kết quả trong Bảng 2 cho thấy mạng thuần 34 lớp sâu hơn có lỗi xác thực cao hơn mạng thuần 18 lớp nông hơn. Để làm rõ nguyên nhân, trong Hình 4 (trái) chúng tôi so sánh lỗi huấn luyện/xác thực của chúng trong suốt quá trình huấn luyện. Chúng tôi đã quan sát thấy vấn đề suy giảm - mạng
              layer name     output size     18-layer              34-layer              50-layer                         101-layer                          152-layer
-------------------------------------------------------------------------------------------------------------------------------
conv1          112×112                                7×7, 64, stride 2
                                              3×3 max pool, stride 2
conv2_x        56×56           [3×3, 64            [3×3, 64            [1×1, 64                         [1×1, 64                          [1×1, 64
                                3×3, 64] ×2         3×3, 64] ×3         3×3, 64                          3×3, 64                           3×3, 64
                                                                        1×1, 256] ×3                    1×1, 256] ×3                     1×1, 256] ×3

conv3_x        28×28           [3×3, 128           [3×3, 128           [1×1, 128                        [1×1, 128                         [1×1, 128
                                3×3, 128] ×2        3×3, 128] ×4        3×3, 128                         3×3, 128                          3×3, 128
                                                                        1×1, 512] ×4                    1×1, 512] ×4                     1×1, 512] ×8

conv4_x        14×14           [3×3, 256           [3×3, 256           [1×1, 256                        [1×1, 256                         [1×1, 256
                                3×3, 256] ×2        3×3, 256] ×6        3×3, 256                         3×3, 256                          3×3, 256
                                                                        1×1, 1024] ×6                   1×1, 1024] ×23                   1×1, 1024] ×36

conv5_x        7×7             [3×3, 512           [3×3, 512           [1×1, 512                        [1×1, 512                         [1×1, 512
                                3×3, 512] ×2        3×3, 512] ×3        3×3, 512                         3×3, 512                          3×3, 512
                                                                        1×1, 2048] ×3                   1×1, 2048] ×3                    1×1, 2048] ×3
                1×1                                   average pool, 1000-d fc, softmax
FLOPs                                  1.8×10^9             3.6×10^9             3.8×10^9                         7.6×10^9                         11.3×10^9
Bảng 1. Các kiến trúc cho ImageNet. Các khối xây dựng được hiển thị trong dấu ngoặc vuông (xem thêm Hình 5), cùng với số lượng khối được xếp chồng. Việc giảm mẫu được thực hiện bởi conv3_1, conv4_1 và conv5_1 với stride bằng 2.
| plain | ResNet | |
|---|---|---|
| 18 layers | 27.94 | 27.88 |
| 34 layers | 28.54 | 25.03 |
Bảng 2. Lỗi top-1 (%, kiểm thử 10-crop) trên tập xác thực ImageNet. Ở đây các ResNet không có tham số bổ sung so với các mạng thuần tương ứng của chúng. Hình 4 cho thấy các quá trình huấn luyện.
mạng thuần 34 lớp có lỗi huấn luyện cao hơn trong toàn bộ quá trình huấn luyện, mặc dù không gian nghiệm của mạng thuần 18 lớp là một không gian con của mạng 34 lớp.
Chúng tôi cho rằng khó khăn tối ưu hóa này không có khả năng là do gradient bị tiêu biến. Các mạng thuần này được huấn luyện với BN [16], điều này bảo đảm các tín hiệu lan truyền thuận có phương sai khác không. Chúng tôi cũng xác nhận rằng các gradient lan truyền ngược thể hiện các chuẩn lành mạnh với BN. Do đó, cả tín hiệu thuận lẫn tín hiệu ngược đều không bị tiêu biến. Trên thực tế, mạng thuần 34 lớp vẫn có thể đạt được độ chính xác cạnh tranh (Bảng 3), cho thấy bộ giải hoạt động ở một mức độ nào đó. Chúng tôi phỏng đoán rằng các mạng thuần sâu có thể có tốc độ hội tụ thấp theo hàm mũ, điều này ảnh hưởng đến việc giảm lỗi huấn luyện1. Nguyên nhân của những khó khăn tối ưu hóa như vậy sẽ được nghiên cứu trong tương lai.
Mạng Dư.
Tiếp theo chúng tôi đánh giá các mạng dư (ResNets) 18 lớp và 34 lớp. Các kiến trúc đường cơ sở giống như các mạng thuần ở trên, ngoại trừ việc một kết nối tắt được thêm vào mỗi cặp bộ lọc 3×3 như trong Hình 3 (phải). Trong phép so sánh đầu tiên (Bảng 2 và Hình 4 bên phải), chúng tôi sử dụng ánh xạ đồng nhất cho tất cả các kết nối tắt và đệm bằng số không để tăng số chiều (tùy chọn A). Vì vậy chúng không có tham số bổ sung so với các mạng thuần tương ứng.
Chúng tôi có ba quan sát chính từ Bảng 2 và Hình 4. Thứ nhất, tình huống bị đảo ngược với học phần dư (residual learning) – ResNet 34 lớp tốt hơn ResNet 18 lớp (hơn 2,8%). Quan trọng hơn, ResNet 34 lớp cho thấy lỗi huấn luyện thấp hơn đáng kể và có khả năng khái quát hóa đối với dữ liệu xác thực. Điều này cho thấy vấn đề suy giảm đã được xử lý tốt trong thiết lập này và chúng tôi đạt được mức tăng độ chính xác từ việc tăng độ sâu.
Thứ hai, so với đối tác thuần túy của nó, mô hình 34 lớp
              model                 top-1 err.   top-5 err.
VGG-16 [41]           28.07        9.33
GoogLeNet [44]        -            9.15
PReLU-net [13]        24.27        7.38
---------------------------------------------
plain-34              28.54        10.02
ResNet-34 A           25.03        7.76
ResNet-34 B           24.52        7.46
ResNet-34 C           24.19        7.40
---------------------------------------------
ResNet-50             22.85        6.71
ResNet-101            21.75        6.05
ResNet-152            21.43        5.71
Bảng 3. Tỷ lệ lỗi (%, kiểm thử 10-crop) trên tập xác thực ImageNet. VGG-16 dựa trên bài kiểm thử của chúng tôi. ResNet-50/101/152 thuộc lựa chọn B chỉ sử dụng phép chiếu để tăng số chiều.
              method                top-1 err.   top-5 err.
VGG [41] (ILSVRC’14)  -            8.43†
GoogLeNet [44] (ILSVRC’14)
                       -            7.89
---------------------------------------------
VGG [41] (v5)         24.4         7.1
PReLU-net [13]        21.59        5.71
BN-inception [16]     21.99        5.81
---------------------------------------------
ResNet-34 B           21.84        5.71
ResNet-34 C           21.53        5.60
ResNet-50             20.74        5.25
ResNet-101            19.87        4.60
ResNet-152            19.38        4.49
Bảng 4. Tỷ lệ lỗi (%) của các kết quả mô hình đơn trên tập xác thực ImageNet (ngoại trừ † được báo cáo trên tập kiểm thử).
              method                         top-5 err. (test)
VGG [41] (ILSVRC’14)           7.32
GoogLeNet [44] (ILSVRC’14)     6.66
---------------------------------------------
VGG [41] (v5)                  6.8
PReLU-net [13]                4.94
BN-inception [16]             4.82
---------------------------------------------
ResNet (ILSVRC’15)            3.57
Bảng 5. Tỷ lệ lỗi (%) của các tổ hợp. Lỗi top-5 được đo trên tập kiểm thử của ImageNet và được báo cáo bởi test server.
ResNet làm giảm lỗi top-1 xuống 3,5% (Bảng 2), là kết quả của việc giảm thành công lỗi huấn luyện (Hình 4 bên phải so với bên trái). So sánh này xác minh hiệu quả của học phần dư trên các hệ thống cực sâu.
Cuối cùng, chúng tôi cũng lưu ý rằng các mạng thuần túy/phần dư 18 lớp có độ chính xác tương đương (Bảng 2), nhưng ResNet 18 lớp hội tụ nhanh hơn (Hình 4 bên phải so với bên trái). Khi mạng “không quá sâu” (ở đây là 18 lớp), bộ giải SGD hiện tại vẫn có khả năng tìm được các nghiệm tốt cho mạng thuần túy. Trong trường hợp này, ResNet làm cho việc tối ưu hóa dễ dàng hơn bằng cách cung cấp sự hội tụ nhanh hơn ở giai đoạn đầu.
Đường tắt Ánh xạ đồng nhất so với Phép chiếu.
Chúng tôi đã chỉ ra rằng các đường tắt ánh xạ đồng nhất không có tham số giúp ích cho việc huấn luyện. Tiếp theo chúng tôi khảo sát các đường tắt phép chiếu (Eqn.(2)). Trong Bảng 3 chúng tôi so sánh ba lựa chọn: (A) các đường tắt zero-padding được sử dụng để tăng số chiều, và tất cả các đường tắt đều không có tham số (giống như Bảng 2 và Hình 4 bên phải); (B) các đường tắt phép chiếu được sử dụng để tăng số chiều, còn các đường tắt khác là ánh xạ đồng nhất; và (C) tất cả các đường tắt đều là phép chiếu.
Bảng 3 cho thấy cả ba lựa chọn đều tốt hơn đáng kể so với đối tác thuần túy. B tốt hơn A một chút. Chúng tôi cho rằng điều này là do các chiều được zero-padding trong A thực sự không có học phần dư. C tốt hơn B ở mức rất nhỏ, và chúng tôi quy điều này cho các tham số bổ sung được đưa vào bởi nhiều (mười ba) đường tắt phép chiếu. Nhưng các khác biệt nhỏ giữa A/B/C cho thấy các đường tắt phép chiếu không phải là yếu tố thiết yếu để giải quyết vấn đề suy giảm. Vì vậy chúng tôi không sử dụng lựa chọn C trong phần còn lại của bài báo này, nhằm giảm độ phức tạp bộ nhớ/thời gian và kích thước mô hình. Các đường tắt ánh xạ đồng nhất đặc biệt quan trọng để không làm tăng độ phức tạp của các kiến trúc bottleneck được giới thiệu dưới đây.
Các Kiến trúc Bottleneck Sâu hơn.
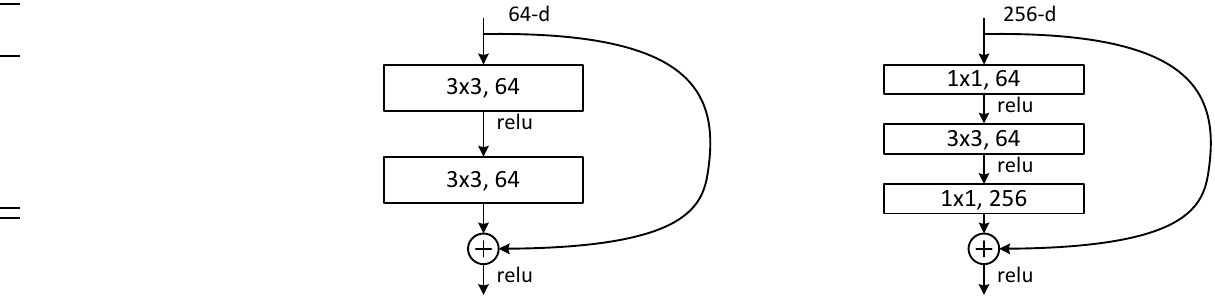
Tiếp theo chúng tôi mô tả các mạng sâu hơn của mình cho ImageNet. Do những lo ngại về thời gian huấn luyện mà chúng tôi có thể chấp nhận được, chúng tôi sửa đổi khối xây dựng theo thiết kế bottleneck.^4 Với mỗi hàm phần dư , chúng tôi sử dụng một chồng gồm 3 lớp thay vì 2 (Hình 5). Ba lớp này là các tích chập 1×1, 3×3 và 1×1, trong đó các lớp 1×1 chịu trách nhiệm giảm rồi tăng (khôi phục) số chiều, để lại lớp 3×3 như một bottleneck với số chiều đầu vào/đầu ra nhỏ hơn. Hình 5 cho thấy một ví dụ, trong đó cả hai thiết kế có độ phức tạp thời gian tương tự.
Các đường tắt ánh xạ đồng nhất không có tham số đặc biệt quan trọng đối với các kiến trúc bottleneck. Nếu đường tắt ánh xạ đồng nhất trong Hình 5 (bên phải) được thay thế bằng phép chiếu, có thể chỉ ra rằng độ phức tạp thời gian và kích thước mô hình bị tăng gấp đôi, vì đường tắt được kết nối với hai đầu có số chiều cao. Do đó các đường tắt ánh xạ đồng nhất dẫn đến các mô hình hiệu quả hơn cho các thiết kế bottleneck.
ResNet 50 lớp:
Chúng tôi thay thế mỗi khối 2 lớp trong
mạng 34 lớp bằng khối bottleneck 3 lớp này, tạo thành một ResNet 50 lớp (Bảng 1). Chúng tôi sử dụng lựa chọn B để tăng số chiều. Mô hình này có 3,8 tỷ FLOP.
ResNet 101 lớp và 152 lớp: Chúng tôi xây dựng các ResNet 101 lớp và 152 lớp bằng cách sử dụng nhiều khối 3 lớp hơn (Bảng 1). Đáng chú ý là mặc dù độ sâu được tăng lên đáng kể, ResNet 152 lớp (11,3 tỷ FLOP) vẫn có độ phức tạp thấp hơn các mạng VGG-16/19 (15,3/19,6 tỷ FLOP).
Các ResNet 50/101/152 lớp chính xác hơn đáng kể so với phiên bản 34 lớp (Bảng 3 và 4). Chúng tôi không quan sát thấy vấn đề suy giảm và do đó thu được mức tăng độ chính xác đáng kể từ việc tăng mạnh độ sâu. Lợi ích của độ sâu được thể hiện trên mọi thước đo đánh giá (Bảng 3 và 4).
So sánh với các phương pháp tiên tiến nhất. Trong Bảng 4, chúng tôi so sánh với các kết quả mô hình đơn tốt nhất trước đó. Các ResNet 34 lớp đường cơ sở của chúng tôi đã đạt được độ chính xác rất cạnh tranh. ResNet 152 lớp của chúng tôi có lỗi kiểm định top-5 của một mô hình đơn là 4,49%. Kết quả mô hình đơn này vượt qua mọi kết quả tổ hợp trước đó (Bảng 5). Chúng tôi kết hợp sáu mô hình có độ sâu khác nhau để tạo thành một tổ hợp (chỉ có hai mô hình 152 lớp vào thời điểm nộp bài). Điều này dẫn đến lỗi top-5 3,57% trên tập kiểm thử (Bảng 5). Mục này đã giành vị trí thứ nhất trong ILSVRC 2015.
4.2. CIFAR-10 và Phân tích
Chúng tôi tiến hành thêm các nghiên cứu trên tập dữ liệu (dataset) CIFAR-10 [20], bao gồm 50k ảnh huấn luyện và 10k ảnh kiểm thử thuộc 10 lớp. Chúng tôi trình bày các thí nghiệm được huấn luyện trên tập huấn luyện và đánh giá trên tập kiểm thử. Trọng tâm của chúng tôi là hành vi của các mạng cực sâu, chứ không phải nhằm đẩy kết quả tiên tiến nhất lên cao hơn, vì vậy chúng tôi chủ ý sử dụng các kiến trúc đơn giản như sau.
Các kiến trúc thuần túy/phần dư tuân theo dạng trong Hình 3 (giữa/phải). Đầu vào của mạng là các ảnh 32×32, với giá trị trung bình theo từng pixel đã được trừ đi. Lớp đầu tiên là các tích chập (convolution) 3×3. Sau đó chúng tôi sử dụng một chồng gồm lớp với các tích chập 3×3 trên các bản đồ đặc trưng có kích thước lần lượt là {32, 16, 8}, với lớp cho mỗi kích thước bản đồ đặc trưng. Số lượng bộ lọc lần lượt là {16, 32, 64}. Việc lấy mẫu xuống được thực hiện bằng các tích chập có bước nhảy bằng 2. Mạng kết thúc bằng một lớp gộp trung bình toàn cục, một lớp kết nối đầy đủ 10 đầu ra, và softmax. Tổng cộng có lớp có trọng số được xếp chồng. Bảng sau tóm tắt kiến trúc:
| kích thước bản đồ đầu ra | 32×32 | 16×16 | 8×8 |
|---|---|---|---|
| số lớp | 1+2n | 2n | 2n |
| số bộ lọc | 16 | 32 | 64 |
Khi các kết nối tắt được sử dụng, chúng được nối tới các cặp lớp 3×3 (tổng cộng 3 kết nối tắt). Trên tập dữ liệu này chúng tôi sử dụng các kết nối tắt ánh xạ đồng nhất (identity) trong mọi trường hợp (tức là, lựa chọn A),
                                       method                 error (%)
                         Maxout [10]            9.38
                         NIN [25]               8.81
                         DSN [24]               8.22

                         # layers   # params
FitNet [35]                 19        2.5M      8.39
Highway [42, 43]            19        2.3M      7.54 (7.72±0.16)
Highway [42, 43]            32        1.25M     8.80
ResNet                      20        0.27M     8.75
ResNet                      32        0.46M     7.51
ResNet                      44        0.66M     7.17
ResNet                      56        0.85M     6.97
ResNet                     110        1.7M      6.43 (6.61±0.16)
ResNet                    1202       19.4M      7.93
Bảng 6. Lỗi phân loại trên tập kiểm thử CIFAR-10. Tất cả các phương pháp đều sử dụng tăng cường dữ liệu. Đối với ResNet-110, chúng tôi chạy 5 lần và hiển thị “tốt nhất (trung bình±độ lệch chuẩn)” như trong [43].
vì vậy các mô hình phần dư của chúng tôi có chính xác cùng độ sâu, độ rộng và số lượng tham số như các đối tác thuần túy.
Chúng tôi sử dụng weight decay bằng 0,0001 và momentum bằng 0,9, đồng thời áp dụng khởi tạo trọng số trong [13] và BN [16] nhưng không dùng dropout. Các mô hình này được huấn luyện với kích thước mini-batch là 128 trên hai GPU. Chúng tôi bắt đầu với tốc độ học là 0,1, chia nó cho 10 tại các vòng lặp 32k và 48k, và kết thúc huấn luyện tại 64k vòng lặp, được xác định trên phép chia train/val 45k/5k. Chúng tôi tuân theo phương pháp tăng cường dữ liệu đơn giản trong [24] để huấn luyện: đệm thêm 4 pixel ở mỗi phía, và lấy ngẫu nhiên một vùng cắt 32×32 từ ảnh đã được đệm hoặc ảnh lật ngang của nó. Đối với kiểm thử, chúng tôi chỉ đánh giá một góc nhìn duy nhất của ảnh gốc 32×32.
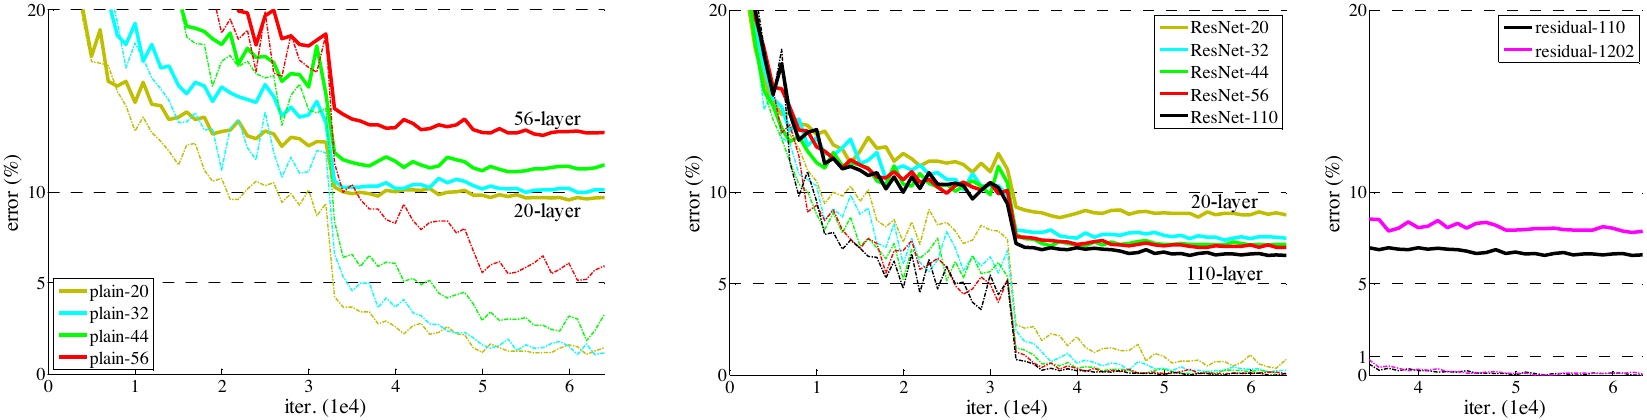
Chúng tôi so sánh , tương ứng tạo ra các mạng 20, 32, 44 và 56 lớp. Hình 6 (trái) cho thấy hành vi của các mạng thuần túy. Các mạng thuần túy sâu bị ảnh hưởng bất lợi khi độ sâu tăng lên, và biểu hiện lỗi huấn luyện cao hơn khi trở nên sâu hơn. Hiện tượng này tương tự như trên ImageNet (Hình 4, trái) và trên MNIST (xem [42]), cho thấy rằng khó khăn tối ưu hóa như vậy là một vấn đề cơ bản.
Hình 6 (giữa) cho thấy hành vi của các ResNet. Tương tự như các trường hợp trên ImageNet (Hình 4, phải), các ResNet của chúng tôi vượt qua được khó khăn tối ưu hóa và thể hiện mức tăng độ chính xác khi độ sâu tăng lên.
Chúng tôi tiếp tục khảo sát , dẫn đến một ResNet 110 lớp. Trong trường hợp này, chúng tôi nhận thấy rằng tốc độ học ban đầu 0.1 hơi quá lớn để bắt đầu hội tụ1. Vì vậy, chúng tôi sử dụng 0.01 để khởi động quá trình huấn luyện cho đến khi lỗi huấn luyện nhỏ hơn 80% (khoảng 400 lần lặp), sau đó quay lại 0.1 và tiếp tục huấn luyện. Phần còn lại của lịch huấn luyện được thực hiện như trước đây. Mạng 110 lớp này hội tụ tốt (Fig. 6, giữa). Nó có ít hơn tham số so với các mạng sâu và mỏng khác
các mạng như FitNet [35] và Highway [42] (Table 6), nhưng vẫn nằm trong số các kết quả hiện đại nhất (6.43%, Table 6).
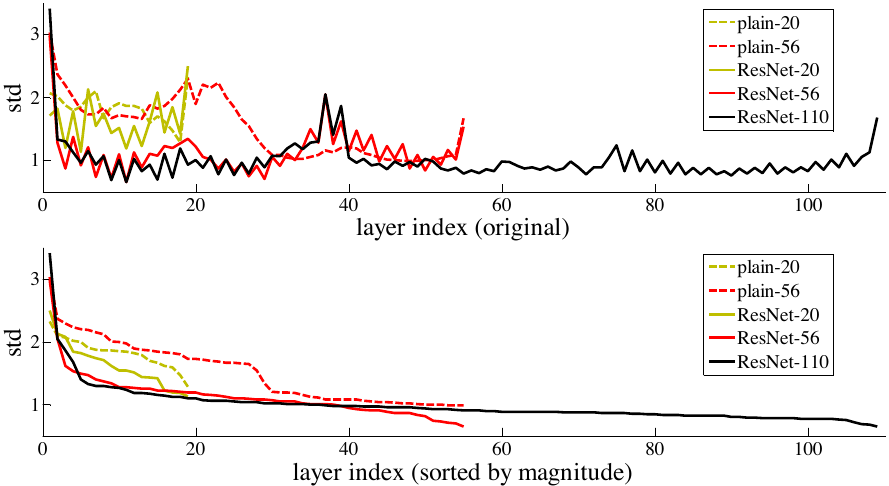
Phân tích các phản hồi lớp. Fig. 7 hiển thị độ lệch chuẩn (std) của các phản hồi lớp. Các phản hồi là đầu ra của mỗi lớp , sau BN và trước tính phi tuyến khác (ReLU/addition). Đối với ResNets, phân tích này cho thấy cường độ phản hồi của các hàm dư. Fig. 7 cho thấy ResNets nhìn chung có các phản hồi nhỏ hơn so với các mạng thông thường tương ứng. Các kết quả này ủng hộ động lực cơ bản của chúng tôi (Sec.3.1) rằng các hàm dư có thể thường gần bằng không hơn các hàm không dư. Chúng tôi cũng nhận thấy rằng ResNet sâu hơn có độ lớn phản hồi nhỏ hơn, được chứng minh qua các so sánh giữa ResNet-20, 56 và 110 trong Fig. 7. Khi có nhiều lớp hơn, một lớp riêng lẻ của ResNets có xu hướng thay đổi tín hiệu ít hơn.
Khảo sát trên 1000 lớp. Chúng tôi khảo sát một mô hình sâu mạnh mẽ có hơn 1000 lớp. Chúng tôi đặt , dẫn đến một mạng 1202 lớp, được huấn luyện như mô tả ở trên. Phương pháp của chúng tôi cho thấy không có khó khăn trong tối ưu hóa, và mạng lớp này có thể đạt được lỗi huấn luyện (Fig. 6, phải). Lỗi kiểm thử của nó vẫn khá tốt (7.93%, Table 6).
Tuy nhiên, vẫn còn các vấn đề mở đối với những mô hình sâu mạnh mẽ như vậy. Kết quả kiểm thử của mạng 1202 lớp này kém hơn so với mạng 110 lớp của chúng tôi, mặc dù cả hai
| dữ liệu huấn luyện | 07+12 | 07++12 |
|---|---|---|
| dữ liệu kiểm thử | VOC 07 test | VOC 12 test |
| VGG-16 | 73.2 | 70.4 |
| ResNet-101 | 76.4 | 73.8 |
Table 7. mAP (%) phát hiện đối tượng trên các tập kiểm thử PASCAL VOC 2007/2012 sử dụng đường cơ sở Faster R-CNN. Xem thêm Table 10 và 11 để có các kết quả tốt hơn.
| chỉ số | mAP@.5 | mAP@[.5, .95] |
|---|---|---|
| VGG-16 | 41.5 | 21.2 |
| ResNet-101 | 48.4 | 27.2 |
Table 8. mAP (%) phát hiện đối tượng trên tập xác thực COCO sử dụng đường cơ sở Faster R-CNN. Xem thêm Table 9 để có các kết quả tốt hơn.
có lỗi huấn luyện tương tự. Chúng tôi cho rằng điều này là do quá khớp. Mạng 1202 lớp có thể lớn không cần thiết (19.4M) đối với tập dữ liệu nhỏ này. Các kỹ thuật điều chuẩn mạnh như maxout [10] hoặc dropout [14] được áp dụng để thu được các kết quả tốt nhất ([10, 25, 24, 35]) trên tập dữ liệu này. Trong bài báo này, chúng tôi không sử dụng maxout/dropout và chỉ đơn giản áp đặt điều chuẩn thông qua các kiến trúc sâu và mỏng theo thiết kế, mà không làm phân tán trọng tâm khỏi những khó khăn trong tối ưu hóa. Tuy nhiên, việc kết hợp với điều chuẩn mạnh hơn có thể cải thiện kết quả, điều mà chúng tôi sẽ nghiên cứu trong tương lai.
4.3. Phát hiện đối tượng trên PASCAL và MS COCO
Phương pháp của chúng tôi có hiệu năng tổng quát hóa tốt trên các tác vụ nhận dạng khác. Table 7 và 8 cho thấy các kết quả đường cơ sở phát hiện đối tượng trên PASCAL VOC 2007 và 2012 [5] và COCO [26]. Chúng tôi sử dụng Faster R-CNN [32] làm phương pháp phát hiện. Ở đây chúng tôi quan tâm đến những cải thiện khi thay thế VGG-16 [41] bằng ResNet-101. Cách triển khai phát hiện (xem phụ lục) khi sử dụng cả hai mô hình là giống nhau, do đó các cải thiện chỉ có thể được quy cho các mạng tốt hơn. Đáng chú ý nhất, trên tập dữ liệu COCO đầy thách thức, chúng tôi thu được mức tăng 6.0% trong chỉ số tiêu chuẩn của COCO (mAP@[.5, .95]), tương đương với cải thiện tương đối 28%. Sự cải thiện này hoàn toàn nhờ vào các biểu diễn đã học.
Dựa trên các mạng dư sâu, chúng tôi đã giành vị trí thứ 1 trong một số hạng mục tại các cuộc thi ILSVRC & COCO 2015: ImageNet detection, ImageNet localization, COCO detection, và COCO segmentation. Các chi tiết nằm trong phụ lục.
A Các đường cơ sở phát hiện đối tượng
Trong phần này, chúng tôi giới thiệu phương pháp phát hiện dựa trên hệ thống đường cơ sở Faster R-CNN [32]. Các mô hình được khởi tạo bởi các mô hình phân loại ImageNet, sau đó được tinh chỉnh trên dữ liệu phát hiện đối tượng. Chúng tôi đã thử nghiệm với ResNet-50/101 vào thời điểm diễn ra các cuộc thi phát hiện ILSVRC & COCO 2015.
Khác với VGG-16 được sử dụng trong [32], ResNet của chúng tôi không có các lớp fc ẩn. Chúng tôi áp dụng ý tưởng “Networks on Conv feature maps” (NoC) [33] để giải quyết vấn đề này. Chúng tôi tính toán các bản đồ đặc trưng conv được chia sẻ trên toàn ảnh bằng cách sử dụng các lớp có stride trên ảnh không lớn hơn 16 pixel (tức là conv1, conv2_x, conv3_x, và conv4_x, tổng cộng 91 lớp conv trong ResNet-101; Bảng 1). Chúng tôi xem các lớp này tương tự như 13 lớp conv trong VGG-16, và bằng cách này, cả ResNet và VGG-16 đều có các bản đồ đặc trưng conv với cùng stride tổng (16 pixel). Các lớp này được chia sẻ bởi một mạng đề xuất vùng (RPN, tạo ra 300 đề xuất) [32] và một mạng phát hiện Fast R-CNN [7]. RoI pooling [7] được thực hiện trước conv5_1. Trên đặc trưng được RoI-pooled này, tất cả các lớp của conv5_x trở lên được áp dụng cho từng vùng, đóng vai trò của các lớp fc của VGG-16. Lớp phân loại cuối cùng được thay thế bằng hai lớp song song (phân loại và hồi quy hộp [7]).
Đối với việc sử dụng các lớp BN, sau khi tiền huấn luyện, chúng tôi tính toán các thống kê BN (trung bình và phương sai) cho mỗi lớp trên tập huấn luyện ImageNet. Sau đó, các lớp BN được cố định trong quá trình tinh chỉnh cho phát hiện đối tượng. Như vậy, các lớp BN trở thành các kích hoạt tuyến tính với các độ lệch và tỷ lệ không đổi, và các thống kê BN không được cập nhật bởi quá trình tinh chỉnh. Chúng tôi cố định các lớp BN chủ yếu để giảm mức tiêu thụ bộ nhớ trong quá trình huấn luyện Faster R-CNN.
PASCAL VOC
Theo [7, 32], đối với tập test PASCAL VOC 2007, chúng tôi sử dụng 5k ảnh trainval trong VOC 2007 và 16k ảnh trainval trong VOC 2012 để huấn luyện (“07+12”). Đối với tập test PASCAL VOC 2012, chúng tôi sử dụng 10k ảnh trainval+test trong VOC 2007 và 16k ảnh trainval trong VOC 2012 để huấn luyện (“07++12”). Các siêu tham số cho việc huấn luyện Faster R-CNN giống như trong [32]. Bảng 7 cho thấy các kết quả. ResNet-101 cải thiện mAP hơn >3% so với VGG-16. Sự cải thiện này hoàn toàn là do các đặc trưng được cải thiện được học bởi ResNet.
MS COCO
Tập dữ liệu MS COCO [26] bao gồm 80 loại đối tượng. Chúng tôi đánh giá theo độ đo PASCAL VOC (mAP @ IoU = 0.5) và độ đo COCO tiêu chuẩn (mAP @ IoU = .5:.05:.95). Chúng tôi sử dụng 80k ảnh trong tập train để huấn luyện và 40k ảnh trong tập val để đánh giá. Hệ thống phát hiện của chúng tôi cho COCO tương tự như hệ thống cho PASCAL VOC. Chúng tôi huấn luyện các mô hình COCO bằng một triển khai 8-GPU, do đó bước RPN có kích thước mini-batch là 8 ảnh (i.e., 1 trên mỗi GPU) và bước Fast R-CNN có kích thước mini-batch là 16 ảnh. Bước RPN và bước Fast R-CNN đều được huấn luyện trong 240k vòng lặp với tốc độ học là 0.001 và sau đó trong 80k vòng lặp với 0.0001.
Bảng 8 cho thấy các kết quả trên tập kiểm thử MS COCO. ResNet-101 có mức tăng 6% của mAP@[.5, .95] so với VGG-16, tương đương với cải thiện tương đối 28%, hoàn toàn do các đặc trưng được học bởi mạng tốt hơn đóng góp. Đáng chú ý, mức tăng tuyệt đối của mAP@I.5, .95] (6.0%) gần lớn bằng mức tăng của mAP@.5 (6.9%). Điều này cho thấy một mạng sâu hơn có thể cải thiện cả nhận dạng và định vị.
B Cải thiện phát hiện đối tượng
Để hoàn thiện, chúng tôi báo cáo các cải tiến được thực hiện cho các cuộc thi. Những cải tiến này dựa trên các đặc trưng sâu và do đó nên được hưởng lợi từ học dư.
MS COCO
\Tinh chỉnh hộp.\ Việc tinh chỉnh hộp của chúng tôi phần nào tuân theo định vị lặp trong [6]. Trong Faster R-CNN, đầu ra cuối cùng là một hộp được hồi quy, khác với hộp đề xuất của nó. Vì vậy, đối với suy luận, chúng tôi gom nhóm một đặc trưng mới từ hộp được hồi quy và thu được một điểm số phân loại mới cùng một hộp được hồi quy mới. Chúng tôi kết hợp 300 dự đoán mới này với 300 dự đoán ban đầu. Non-maximum suppression (NMS) được áp dụng trên tập hợp hợp nhất của các hộp được dự đoán bằng cách sử dụng ngưỡng IoU là 0.3 [8], tiếp theo là bỏ phiếu hộp [6]. Tinh chỉnh hộp cải thiện mAP khoảng 2 điểm (Bảng 9).
\Ngữ cảnh toàn cục.\ Chúng tôi kết hợp ngữ cảnh toàn cục trong bước Fast R-CNN. Với bản đồ đặc trưng conv của toàn bộ ảnh, chúng tôi gom nhóm một đặc trưng bằng Spatial Pyramid Pooling toàn cục [12] (với kim tự tháp “một mức”) có thể được triển khai như gom nhóm “RoI” bằng cách sử dụng hộp bao của toàn bộ ảnh làm RoI. Đặc trưng được gom nhóm này được đưa vào các lớp sau RoI để thu được một đặc trưng ngữ cảnh toàn cục. Đặc trưng toàn cục này được nối với đặc trưng ban đầu theo từng vùng, tiếp theo là các lớp phân loại song sinh và hồi quy hộp. Cấu trúc mới này được huấn luyện end-to-end. Ngữ cảnh toàn cục cải thiện mAP\@.5 khoảng 1 điểm (Bảng 9).
\Kiểm thử đa tỷ lệ.\ Trong phần trên, tất cả kết quả thu được bằng huấn luyện/kiểm thử đơn tỷ lệ như trong [32], trong đó cạnh ngắn hơn của ảnh là pixel. Huấn luyện/kiểm thử đa tỷ lệ đã được phát triển trong [12, 7] bằng cách chọn một tỷ lệ từ một kim tự tháp đặc trưng, và trong [33] bằng cách sử dụng các lớp maxout. Trong triển khai hiện tại, chúng tôi đã thực hiện \kiểm thử\ đa tỷ lệ theo [33]; chúng tôi chưa thực hiện huấn luyện đa tỷ lệ vì thời gian hạn chế. Ngoài ra, chúng tôi chỉ thực hiện kiểm thử đa tỷ lệ cho bước Fast R-CNN (nhưng chưa cho bước RPN). Với một mô hình đã được huấn luyện, chúng tôi tính toán các bản đồ đặc trưng conv trên một kim tự tháp ảnh, trong đó các cạnh ngắn hơn của ảnh là .
              training data                           COCO train                COCO trainval
test data                               COCO val                  COCO test-dev
mAP                                     @.5      @[.5, .95]       @.5      @[.5, .95]
baseline Faster R-CNN (VGG-16)          41.5     21.2
baseline Faster R-CNN (ResNet-101)      48.4     27.2
+box refinement                         49.9     29.9
+context                                51.1     30.0             53.3     32.2
+multi-scale testing                    53.8     32.5             55.7     34.9
ensemble                                                     59.0     37.4
Bảng 9. Các cải thiện phát hiện đối tượng trên MS COCO sử dụng Faster R-CNN và ResNet-101.
              system      net         data         mAP  areo  bike  bird  boat  bottle  bus  car  cat  chair  cow  table  dog  horse  mbike  person  plant  sheep  sofa  train  tv
baseline    VGG-16      07+12        73.2 76.5  79.0  70.9  65.5  52.1    83.1 84.7 86.4 52.0   81.9 65.7   84.8 84.6   77.5   76.7    38.8   73.6   73.9  83.0   72.6
baseline    ResNet-101  07+12        76.4 79.8  80.7  76.2  68.3  55.9    85.1 85.3 89.8 56.7   87.8 69.4   88.3 88.9   80.9   78.4    41.7   78.6   79.8  85.3   72.0
baseline+++ ResNet-101  COCO+07+12   85.6 90.0  89.6  87.8  80.8  76.1    89.9 89.9 89.6 75.5   90.0 80.7   89.6 90.3   89.1   88.7    65.4   88.1   85.6  89.0   86.8
Bảng 10. Các kết quả phát hiện trên tập kiểm thử PASCAL VOC 2007. Đường cơ sở là hệ thống Faster R-CNN. Hệ thống “baseline+++” bao gồm tinh chỉnh hộp, ngữ cảnh và kiểm thử đa tỷ lệ trong Bảng 9.
              system      net         data         mAP  areo  bike  bird  boat  bottle  bus  car  cat  chair  cow  table  dog  horse  mbike  person  plant  sheep  sofa  train  tv
baseline    VGG-16      07++12       70.4 84.9  79.8  74.3  53.9  49.8    77.5 75.9 88.5 45.6   77.1 55.3   86.9 81.7   80.9   79.6    40.1   72.6   60.9  81.2   61.5
baseline    ResNet-101  07++12       73.8 86.5  81.6  77.2  58.0  51.0    78.6 76.6 93.2 48.6   80.4 59.0   92.1 85.3   84.8   80.7    48.1   77.3   66.5  84.7   65.6
baseline+++ ResNet-101  COCO+07++12  83.8 92.1  88.4  84.8  75.9  71.4    86.3 87.8 94.2 66.8   89.4 69.2   93.9 91.9   90.9   89.6    67.9   88.2   76.8  90.3   80.0
Bảng 11. Các kết quả phát hiện trên tập kiểm thử PASCAL VOC 2012 (http://host.robots.ox.ac.uk:8080/leaderboard/displaylb.php?challengeid=11&compid=4). Đường cơ sở là hệ thống Faster R-CNN. Hệ thống “baseline+++” bao gồm tinh chỉnh hộp, ngữ cảnh và kiểm thử đa tỷ lệ trong Bảng 9.
Chúng tôi chọn hai tỷ lệ liền kề từ kim tự tháp theo [33]. Gom nhóm RoI và các lớp tiếp theo được thực hiện trên các bản đồ đặc trưng của hai tỷ lệ này [33], được hợp nhất bằng maxout như trong [33]. Kiểm thử đa tỷ lệ cải thiện mAP hơn 2 điểm (Bảng 9).
\Sử dụng dữ liệu xác thực.\ Tiếp theo, chúng tôi sử dụng tập trainval 80k+40k để huấn luyện và tập test-dev 20k để đánh giá. Tập test-dev không có ground truth công khai và kết quả được báo cáo bởi server đánh giá. Trong thiết lập này, các kết quả là mAP\@.5 là 55.7% và mAP@[.5, .95] là 34.9% (Bảng 9). Đây là kết quả của mô hình đơn của chúng tôi.
\Tổ hợp.\ Trong Faster R-CNN, hệ thống được thiết kế để học các đề xuất vùng và cả các bộ phân loại đối tượng, vì vậy một tổ hợp có thể được sử dụng để tăng cường cả hai tác vụ. Chúng tôi sử dụng một tổ hợp để đề xuất vùng, và tập hợp hợp nhất của các đề xuất được xử lý bởi một tổ hợp các bộ phân loại theo từng vùng. Bảng 9 cho thấy kết quả của chúng tôi dựa trên một tổ hợp gồm 3 mạng. mAP là 59.0% và 37.4% trên tập test-dev. \Kết quả này giành vị trí thứ 1 trong tác vụ phát hiện trong COCO 2015.\
PASCAL VOC
Chúng tôi xem xét lại tập dữ liệu PASCAL VOC dựa trên mô hình ở trên. Với mô hình đơn trên tập dữ liệu COCO (55.7% mAP\@.5 trong Table 9), chúng tôi tinh chỉnh mô hình này trên các tập PASCAL VOC. Các cải tiến về tinh chỉnh hộp, ngữ cảnh và kiểm thử đa tỷ lệ cũng được áp dụng. Bằng cách này
                                                 val2   test
GoogLeNet [44] (ILSVRC’14)         -      43.9
our single model (ILSVRC’15)       60.5   58.8
our ensemble (ILSVRC’15)           63.6   62.1
Table 12. Các kết quả của chúng tôi (mAP, %) trên tập dữ liệu phát hiện ImageNet. Hệ thống phát hiện của chúng tôi là Faster R-CNN [32] với các cải tiến trong Table 9, sử dụng ResNet-101.
chúng tôi đạt được 85.6% mAP trên PASCAL VOC 2007 (Table 10) và 83.8% trên PASCAL VOC 2012 (Table 11)1. Kết quả trên PASCAL VOC 2012 cao hơn 10 điểm so với kết quả tiên tiến nhất trước đó [6].
Phát hiện ImageNet
Tác vụ Phát hiện ImageNet (DET) bao gồm 200 loại đối tượng. Độ chính xác được đánh giá bằng mAP\@.5. Thuật toán phát hiện đối tượng ImageNet DET của chúng tôi giống với thuật toán dành cho MS COCO trong Table 9. Các mạng được huấn luyện trước trên tập phân loại ImageNet 1000 lớp, và được tinh chỉnh trên dữ liệu DET. Chúng tôi chia tập xác thực thành hai phần (val1/val2) theo [8]. Chúng tôi tinh chỉnh các mô hình phát hiện bằng cách sử dụng tập huấn luyện DET và tập val1. Tập val2 được sử dụng để xác thực. Chúng tôi không sử dụng dữ liệu ILSVRC 2015 khác. Mô hình đơn của chúng tôi với ResNet-101 có
              LOC         LOC         testing   LOC error   classification   top-5 LOC error
method      network               on GT CLS   network          on predicted CLS

VGG’s [41]  VGG-16      1-crop    33.1 [41]
RPN         ResNet-101  1-crop    13.3
RPN         ResNet-101  dense     11.7

RPN         ResNet-101  dense                  ResNet-101      14.4
RPN+RCNN    ResNet-101  dense                  ResNet-101      10.6
RPN+RCNN    ensemble    dense                  ensemble        8.9
Table 13. Lỗi định vị (%) trên tập xác thực ImageNet. Trong cột “LOC error on GT class” ([41]), lớp chân lý thực được sử dụng. Trong cột “testing”, “1-crop” biểu thị kiểm thử trên một crop trung tâm gồm 224×224 pixel, “dense” biểu thị kiểm thử dày đặc (hoàn toàn tích chập) và đa tỷ lệ.
58.8% mAP và tổ hợp của 3 mô hình của chúng tôi có 62.1% mAP trên tập kiểm thử DET (Table 12). Kết quả này giành vị trí thứ 1 trong tác vụ phát hiện ImageNet tại ILSVRC 2015, vượt qua vị trí thứ hai 8.5 điểm (tuyệt đối).
C Bản địa hóa ImageNet
Nhiệm vụ Bản địa hóa ImageNet (LOC) [36] yêu cầu phân loại và định vị các đối tượng. Theo [40, 41], chúng tôi giả định rằng các bộ phân loại ở mức ảnh trước tiên được sử dụng để dự đoán các nhãn lớp của một ảnh, và thuật toán bản địa hóa chỉ chịu trách nhiệm dự đoán các hộp bao quanh dựa trên các lớp đã dự đoán. Chúng tôi áp dụng chiến lược “hồi quy theo từng lớp” (PCR) [40, 41], học một bộ hồi quy hộp bao quanh cho mỗi lớp. Chúng tôi huấn luyện trước các mạng cho phân loại ImageNet rồi tinh chỉnh chúng cho bản địa hóa. Chúng tôi huấn luyện các mạng trên tập huấn luyện ImageNet 1000 lớp được cung cấp.
Thuật toán bản địa hóa của chúng tôi dựa trên khung RPN của [32] với một vài sửa đổi. Khác với cách trong [32] vốn không phụ thuộc danh mục, RPN của chúng tôi cho bản địa hóa được thiết kế dưới dạng theo từng lớp. RPN này kết thúc bằng hai lớp tích chập 1×1 song sinh cho phân loại nhị phân (cls) và hồi quy hộp (reg), như trong [32]. Các lớp cls và reg đều ở dạng theo từng lớp, trái ngược với [32]. Cụ thể, lớp cls có đầu ra 1000-d, và mỗi chiều là hồi quy logistic nhị phân để dự đoán có phải là một lớp đối tượng hay không; lớp reg có đầu ra 1000×4-d bao gồm các bộ hồi quy hộp cho 1000 lớp. Như trong [32], hồi quy hộp bao quanh của chúng tôi tham chiếu đến nhiều hộp “neo” bất biến theo phép dịch tại mỗi vị trí.
Giống như quá trình huấn luyện phân loại ImageNet của chúng tôi (Sec. 3.4), chúng tôi lấy mẫu ngẫu nhiên các vùng cắt 224×224 để tăng cường dữ liệu. Chúng tôi sử dụng kích thước lô nhỏ 256 ảnh để tinh chỉnh. Để tránh các mẫu âm chiếm ưu thế, 8 neo được lấy mẫu ngẫu nhiên cho mỗi ảnh, trong đó các neo dương và âm được lấy mẫu có tỷ lệ 1:1 [32]. Để kiểm thử, mạng được áp dụng trên toàn bộ ảnh theo cách tích chập đầy đủ.
Bảng 13 so sánh các kết quả bản địa hóa. Theo [41], trước tiên chúng tôi thực hiện kiểm thử “oracle” bằng cách sử dụng lớp đúng theo thực tế làm dự đoán phân loại. Bài báo của VGG [41] báo cáo lỗi cắt trung tâm là 33.1% (Bảng 13) khi sử dụng các lớp đúng theo thực tế. Với cùng thiết lập, phương pháp RPN của chúng tôi sử dụng mạng ResNet-101 giảm đáng kể lỗi cắt trung tâm xuống còn 13.3%. So sánh này chứng minh hiệu năng xuất sắc của khung của chúng tôi. Với kiểm thử dày đặc (tích chập đầy đủ) và đa tỷ lệ, ResNet-101 của chúng tôi có lỗi 11.7% khi sử dụng các lớp đúng theo thực tế. Sử dụng ResNet-101 để dự đoán các lớp (lỗi phân loại top-5 4.6%, Bảng 4), lỗi bản địa hóa top-5 là 14.4%.
              method                         top-5 localization err
                               val     test
OverFeat [40] (ILSVRC’13)      30.0    29.9
GoogLeNet [44] (ILSVRC’14)     -       26.7
VGG [41] (ILSVRC’14)           26.9    25.3
ours (ILSVRC’15)               8.9     9.0
Bảng 14. So sánh lỗi bản địa hóa (%) trên tập dữ liệu ImageNet với các phương pháp hiện đại nhất.
Các kết quả trên chỉ dựa trên mạng đề xuất (RPN) trong Faster R-CNN [32]. Có thể sử dụng mạng phát hiện (Fast R-CNN [7]) trong Faster R-CNN để cải thiện kết quả. Tuy nhiên, chúng tôi nhận thấy rằng trên tập dữ liệu này, một ảnh thường chứa một đối tượng chi phối duy nhất, và các vùng đề xuất chồng lấn nhiều với nhau nên có các đặc trưng RoI-pooled rất tương tự. Do đó, việc huấn luyện lấy ảnh làm trung tâm của Fast R-CNN [7] tạo ra các mẫu có biến thiên nhỏ, điều này có thể không mong muốn đối với huấn luyện ngẫu nhiên. Dựa trên động lực này, trong thí nghiệm hiện tại, chúng tôi sử dụng R-CNN gốc [8] vốn lấy RoI làm trung tâm, thay cho Fast R-CNN.
Cài đặt R-CNN của chúng tôi như sau. Chúng tôi áp dụng RPN theo từng lớp được huấn luyện như trên vào các ảnh huấn luyện để dự đoán các hộp bao quanh cho lớp đúng theo thực tế. Các hộp được dự đoán này đóng vai trò là các đề xuất phụ thuộc lớp. Với mỗi ảnh huấn luyện, 200 đề xuất có điểm số cao nhất được trích xuất làm các mẫu huấn luyện để huấn luyện bộ phân loại R-CNN. Vùng ảnh được cắt từ một đề xuất, biến dạng thành 224×224 pixel, và đưa vào mạng phân loại như trong R-CNN [8]. Các đầu ra của mạng này bao gồm hai lớp fc song sinh cho cls và reg, cũng ở dạng theo từng lớp. Mạng R-CNN này được tinh chỉnh trên tập huấn luyện bằng cách sử dụng kích thước lô nhỏ 256 theo cách lấy RoI làm trung tâm. Để kiểm thử, RPN tạo ra 200 đề xuất có điểm số cao nhất cho mỗi lớp được dự đoán, và mạng R-CNN được sử dụng để cập nhật điểm số và vị trí hộp của các đề xuất này.
Phương pháp này giảm lỗi bản địa hóa top-5 xuống còn 10.6% (Bảng 13). Đây là kết quả của mô hình đơn lẻ của chúng tôi trên tập xác thực. Sử dụng một tổ hợp các mạng cho cả phân loại và bản địa hóa, chúng tôi đạt được lỗi bản địa hóa top-5 là 9.0% trên tập kiểm thử. Con số này vượt trội đáng kể so với các kết quả ILSVRC 14 (Bảng 14), cho thấy mức giảm lỗi tương đối 64%. Kết quả này giành vị trí thứ 1 trong nhiệm vụ bản địa hóa ImageNet tại ILSVRC 2015.