Phân tích hiệu năng trong trung tâm dữ liệu của một Tensor Processing Unit™
Norman P. Jouppi, Cliff Young, Nishant Patil, David Patterson, Gaurav Agrawal, Raminder Bajwa, Sarah Bates, Suresh Bhatia, Nan Boden, Al Borchers, Rick Boyle, Pierre-luc Cantin, Clifford Chao, Chris Clark, Jeremy Coriell, Mike Daley, Matt Dau, Jeffrey Dean, Ben Gelb, Tara Vazir Ghaemmaghami, Rajendra Gottipati, William Gulland, Robert Hagmann, C. Richard Ho, Doug Hogberg, John Hu, Robert Hundt, Dan Hurt, Julian Ibarz, Aaron Jaffey, Alek Jaworski, Alexander Kaplan, Harshit Khaitan, Daniel Killebrew, Andy Koch, Naveen Kumar, Steve Lacy, James Laudon, James Law, Diemthu Le, Chris Leary, Zhuyuan Liu, Kyle Lucke, Alan Lundin, Gordon MacKean, Adriana Maggiore, Maire Mahony, Kieran Miller, Rahul Nagarajan, Ravi Narayanaswami, Ray Ni, Kathy Nix, Thomas Norrie, Mark Omernick, Narayana Penukonda, Andy Phelps, Jonathan Ross, Matt Ross, Amir Salek, Emad Samadiani, Chris Severn, Gregory Sizikov, Matthew Snelham, Jed Souter, Dan Steinberg, Andy Swing, Mercedes Tan, Gregory Thorson, Bo Tian, Horia Toma, Erick Tuttle, Vijay Vasudevan, Richard Walter, Walter Wang, Eric Wilcox, and Doe Hyun Yoon Google, Inc., Mountain View, CA USA Email: {jouppi, cliffy, nishantpatil, davidpatterson} @google.com
Sẽ được trình bày tại Hội nghị chuyên đề quốc tế lần thứ 44 về Kiến trúc Máy tính (ISCA), Toronto, Canada, ngày 26 tháng 6 năm 2017.
Tóm tắt Nhiều kiến trúc sư cho rằng những cải thiện lớn về chi phí-năng lượng-hiệu năng hiện nay phải đến từ phần cứng chuyên biệt theo miền. Bài báo này đánh giá một ASIC tùy biến, được gọi là Tensor Processing Unit (TPU), được triển khai trong các trung tâm dữ liệu từ năm 2015 để tăng tốc giai đoạn suy luận của các mạng nơ-ron (NN). Thành phần cốt lõi của TPU là một đơn vị nhân ma trận MAC 65,536 8-bit, cung cấp thông lượng cực đại 92 TeraOps/giây (TOPS) và một bộ nhớ lớn (28 MiB) trên chip do phần mềm quản lý. Mô hình thực thi xác định của TPU phù hợp với yêu cầu thời gian đáp ứng ở phân vị thứ 99 của các ứng dụng NN của chúng tôi hơn so với các tối ưu hóa biến thiên theo thời gian của CPU và GPU (cache, thực thi ngoài thứ tự, đa luồng, đa tiến trình, nạp trước, ...) vốn giúp tăng thông lượng trung bình nhiều hơn là bảo đảm độ trễ. Việc thiếu các tính năng như vậy giúp giải thích tại sao, mặc dù có vô số MAC và một bộ nhớ lớn, TPU tương đối nhỏ và tiêu thụ ít điện năng. Chúng tôi so sánh TPU với CPU Intel Haswell cấp server và GPU Nvidia K80, là những bộ xử lý cùng thời được triển khai trong cùng các trung tâm dữ liệu. Tải công việc của chúng tôi, được viết bằng khung TensorFlow cấp cao, sử dụng các ứng dụng NN trong môi trường sản xuất (MLP, CNN và LSTM), đại diện cho 95% nhu cầu suy luận NN của các trung tâm dữ liệu của chúng tôi. Mặc dù mức sử dụng thấp đối với một số ứng dụng, trung bình TPU nhanh hơn khoảng 15X - 30X so với GPU hoặc CPU cùng thời, với TOPS/Watt cao hơn khoảng 30X - 80X. Hơn nữa, việc sử dụng bộ nhớ GDDR5 của GPU trong TPU sẽ tăng gấp ba TOPS đạt được và nâng TOPS/Watt lên gần 70X so với GPU và 200X so với CPU. Từ khóa–DNN, MLP, CNN, RNN, LSTM, mạng nơ-ron, kiến trúc chuyên biệt theo miền, bộ tăng tốc
1 Giới thiệu về mạng nơ-ron
Sự kết hợp giữa các tập dữ liệu lớn trên đám mây và số lượng lớn máy tính vận hành đám mây đã tạo nên sự hồi sinh của học máy. Đặc biệt, các mạng nơ-ron sâu (deep neural networks, DNN) đã mang lại những đột phá như giảm tỷ lệ lỗi từ trong nhận dạng tiếng nói xuống 30% so với các phương pháp truyền thống, mức cải thiện lớn nhất trong 20 năm [Dea16]; giảm tỷ lệ lỗi trong một cuộc thi nhận dạng ảnh từ 26% xuống 3.5% kể từ năm 2011 [Kri12] [Sze15] [He16]; và đánh bại một nhà vô địch cờ vây là con người [Sil16]. Khác với một số đối tượng ứng dụng của phần cứng, DNN có thể áp dụng cho nhiều bài toán, nên chúng tôi có thể tái sử dụng một ASIC chuyên dụng cho DNN để xây dựng các giải pháp về tiếng nói, thị giác, ngôn ngữ, dịch thuật, xếp hạng tìm kiếm và nhiều lĩnh vực khác.
Mạng nơ-ron (NN) hướng tới chức năng tương tự bộ não và dựa trên một nơ-ron nhân tạo đơn giản: một hàm phi tuyến (chẳng hạn như ) của tổng có trọng số của các đầu vào. Các nơ-ron nhân tạo này được tập hợp thành các lớp, với đầu ra của một lớp trở thành đầu vào của lớp tiếp theo trong chuỗi. Phần “sâu” trong DNN xuất phát từ việc sử dụng nhiều hơn một vài lớp, vì các tập dữ liệu lớn trên đám mây cho phép xây dựng các mô hình chính xác hơn bằng cách dùng thêm các lớp và tăng kích thước lớp để nắm bắt các mẫu hoặc khái niệm ở cấp độ cao hơn, còn GPU cung cấp đủ năng lực tính toán để phát triển chúng.
Hai giai đoạn của NN được gọi là huấn luyện (hay học) và suy luận (hay dự đoán), tương ứng với phát triển và vận hành thực tế. Nhà phát triển chọn số lớp và kiểu NN, còn quá trình huấn luyện xác định các trọng số. Hiện nay, hầu như toàn bộ quá trình huấn luyện đều sử dụng số dấu phẩy động, đây là một lý do khiến GPU trở nên phổ biến. Một bước gọi là lượng tử hóa (quantization) chuyển số dấu phẩy động thành số nguyên có độ rộng nhỏ—thường chỉ 8 bit—vốn thường đủ tốt cho suy luận. Phép nhân số nguyên tám bit có thể tiêu thụ năng lượng ít hơn 6X và chiếm diện tích nhỏ hơn 6X so với phép nhân số dấu phẩy động 16 bit theo IEEE 754, còn lợi thế của phép cộng số nguyên là 13X về năng lượng và 38X về diện tích [Dal16].
Hiện nay có ba loại NN phổ biến: 1. Perceptron đa lớp (MLP): Mỗi lớp mới là một tập hợp các hàm phi tuyến của tổng có trọng số của tất cả đầu ra (kết nối đầy đủ) từ một lớp trước đó, trong đó các trọng số được tái sử dụng. 2. Mạng nơ-ron tích chập (CNN): Mỗi lớp kế tiếp là một tập hợp các hàm phi tuyến của các tổng có trọng số của những tập con đầu ra gần nhau trong không gian từ lớp trước đó, trong đó các trọng số cũng được tái sử dụng. 3. Mạng nơ-ron hồi quy (RNN): Mỗi lớp tiếp theo là một tập hợp các hàm phi tuyến của các tổng có trọng số của đầu ra và trạng thái trước đó. RNN phổ biến nhất là bộ nhớ dài ngắn hạn (Long Short-Term Memory, LSTM). Điểm tinh tế của LSTM nằm ở việc quyết định thông tin nào cần quên và thông tin nào cần truyền sang lớp tiếp theo dưới dạng trạng thái. Các trọng số được tái sử dụng qua các bước thời gian.
Bảng 1 trình bày hai ví dụ cho mỗi kiểu trong ba kiểu NN—đại diện cho 95% tải công việc suy luận NN trong các trung tâm dữ liệu của chúng tôi—mà chúng tôi dùng làm các phép đo chuẩn. Thường được viết bằng TensorFlow [Aba16], chúng ngắn đến ngạc nhiên: chỉ từ 100 đến 1500 dòng mã. Các phép đo chuẩn của chúng tôi là những phần nhỏ của các ứng dụng lớn hơn chạy trên server chủ, có thể gồm hàng nghìn đến hàng triệu dòng mã C++. Các ứng dụng thường phục vụ trực tiếp người dùng, dẫn đến những giới hạn nghiêm ngặt về thời gian phản hồi.
Mỗi mô hình cần từ 5M đến 100M trọng số (cột thứ 9 của Bảng 1), và việc truy cập chúng có thể tốn nhiều thời gian và năng lượng. Để phân bổ chi phí truy cập, cùng một bộ trọng số được tái sử dụng cho cả một lô ví dụ độc lập trong quá trình suy luận hoặc huấn luyện, qua đó cải thiện hiệu năng.
Bài báo này mô tả và đo lường Bộ xử lý Tensor (TPU), đồng thời so sánh hiệu năng và công suất tiêu thụ của nó trong suy luận với các CPU và GPU cùng thời. Dưới đây là các điểm nổi bật: • Các ứng dụng suy luận thường chú trọng thời gian phản hồi hơn thông lượng vì chúng thường phục vụ trực tiếp người dùng. • Do các giới hạn về độ trễ, GPU K80 chưa được khai thác hết khi thực hiện suy luận và chỉ nhanh hơn CPU Haswell một chút. • Mặc dù có chip nhỏ hơn nhiều và công suất tiêu thụ thấp hơn, TPU có số lượng MAC gấp 25 lần và dung lượng bộ nhớ trên chip gấp 3.5 lần GPU K80. • TPU thực hiện suy luận nhanh hơn GPU K80 và CPU Haswell khoảng 15X - 30X. • Bốn trong sáu ứng dụng NN bị giới hạn bởi băng thông bộ nhớ trên TPU; nếu TPU được sửa đổi để có cùng hệ thống bộ nhớ như GPU K80, nó sẽ nhanh hơn GPU và CPU khoảng 30X - 50X. • Hiệu năng/Watt của TPU gấp 30X - 80X các sản phẩm cùng thời; TPU được sửa đổi với bộ nhớ K80 sẽ tốt hơn 70X - 200X. • Trong khi phần lớn các nhà thiết kế kiến trúc tập trung tăng tốc CNN, chúng chỉ chiếm 5% tải công việc trong trung tâm dữ liệu của chúng tôi.
              Name  LOC  Layers  Nonlinear function  Weights  TPU Ops / Weight Byte  TPU Batch Size  % of Deployed TPUs in July 2016
FC  Conv  Vector  Pool  Total
MLP0  100  5        5  ReLU  20M  200  200  61%
MLP1  1000  4        4  ReLU  5M  168  168
LSTMO  1000  24    34    58  sigmoid, tanh  52M  64  64  29%
LSTM1  1500  37    19    56  sigmoid, tanh  34M  96  96
CNN0  1000    16      16  ReLU  8M  2888  8  5%
CNN1  1000  4  72    13  89  ReLU  100M  1750  32
Bảng 1. Sáu ứng dụng NN (hai ứng dụng cho mỗi kiểu NN) đại diện cho 95% tải công việc của TPU. Các cột là tên NN; số dòng mã; các kiểu và số lượng lớp trong NN (FC là kết nối đầy đủ, Conv là tích chập, Vector là vectơ như tên gọi, Pool là phép gộp, thực hiện giảm kích thước phi tuyến trên TPU; và mức độ phổ biến của ứng dụng TPU vào tháng 7 năm 2016. Một DNN là RankBrain [Cla15]; một LSTM là một phần của GNM Translate [Wu16]; một CNN là Inception; và CNN còn lại là DeepMind AlphaGo [Sil16][Jou15].
2 Nguồn gốc, Kiến trúc và Triển khai TPU
Bắt đầu từ năm 2006, chúng tôi đã thảo luận về việc triển khai GPU, FPGA hoặc ASIC tùy biến trong các datacenter của mình. Chúng tôi kết luận rằng một số ít ứng dụng có thể chạy trên phần cứng chuyên dụng có thể được thực hiện gần như miễn phí bằng công suất dư thừa của các datacenter lớn, và rất khó cải thiện một thứ miễn phí. Cuộc thảo luận thay đổi vào năm 2013 khi một dự báo cho rằng nếu mọi người sử dụng tìm kiếm bằng giọng nói 3 phút mỗi ngày với các DNN nhận dạng tiếng nói, chúng tôi sẽ phải tăng gấp đôi số datacenter để đáp ứng nhu cầu tính toán, điều này sẽ rất tốn kém nếu đáp ứng bằng các CPU thông thường. Do đó, chúng tôi bắt đầu một dự án ưu tiên cao nhằm nhanh chóng sản xuất một ASIC tùy biến cho suy luận (và mua GPU có sẵn trên thị trường cho huấn luyện). Mục tiêu là cải thiện hiệu năng-chi phí lên 10X so với GPU. Theo yêu cầu này, TPU được thiết kế, kiểm chứng [Ste15], chế tạo và triển khai trong các datacenter chỉ trong 15 tháng. (Giới hạn về dung lượng khiến lượng thông tin và mức độ chi tiết về TPU trong bài báo này bị hạn chế; xem [Ros15a], [Ros15b], [Ros15c], [Ros15d], [Tho15] và [You15] để biết thêm.)
Thay vì tích hợp chặt chẽ với CPU, nhằm giảm khả năng làm chậm quá trình triển khai, TPU được thiết kế như một bộ đồng xử lý trên bus I/O PCIe, cho phép cắm nó vào các server hiện có giống như GPU. Ngoài ra, để đơn giản hóa thiết kế phần cứng và gỡ lỗi, server máy chủ gửi các lệnh TPU để TPU thực thi thay vì tự lấy chúng.
Do đó, về bản chất, TPU gần với một bộ đồng xử lý FPU (floating-point unit) hơn là GPU.
Hình.
Hình.
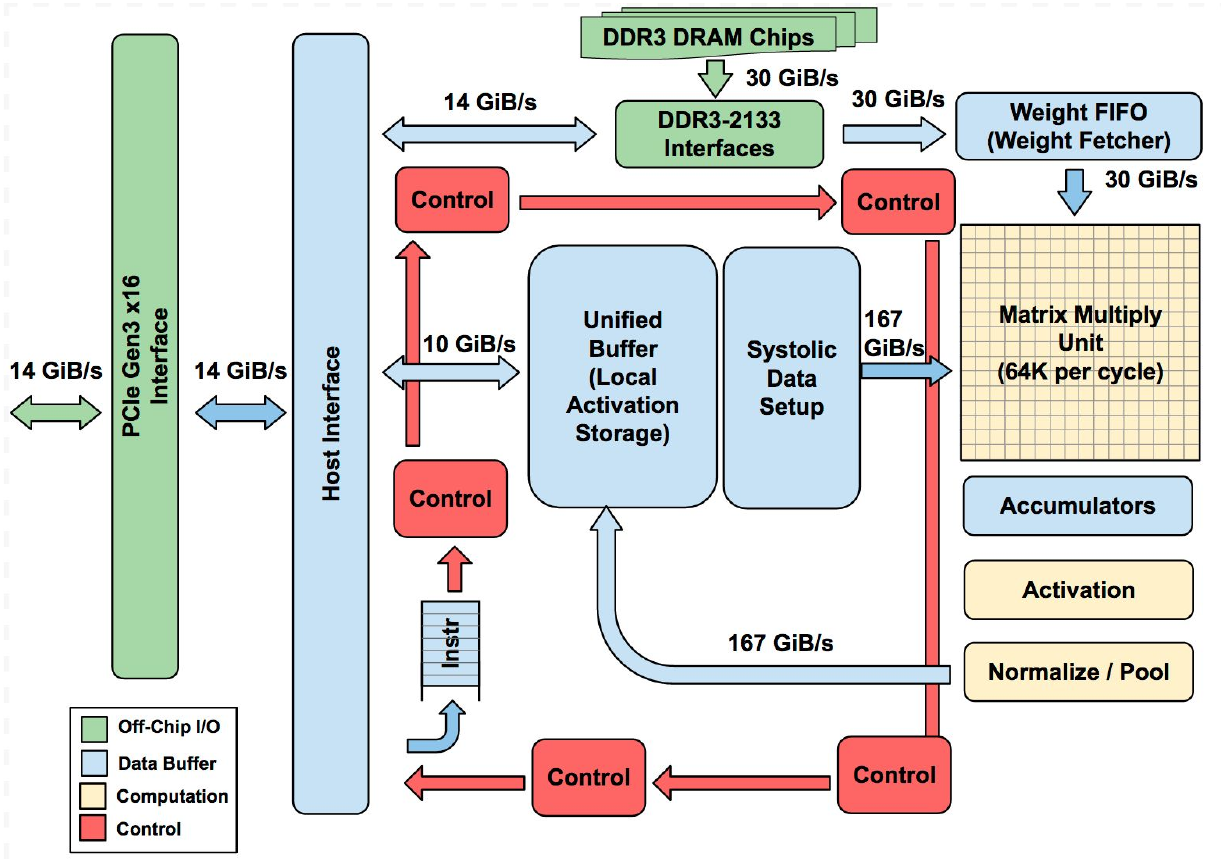
Mục tiêu là chạy toàn bộ các mô hình suy luận trên TPU để giảm tương tác với CPU máy chủ và đủ linh hoạt để đáp ứng nhu cầu NN của năm 2015 và những năm sau đó, thay vì chỉ đáp ứng những gì cần thiết cho các NN năm 2013. Hình 1 cho thấy sơ đồ khối của TPU.
Các lệnh TPU được gửi từ máy chủ qua bus PCIe Gen3 x16 vào một bộ đệm lệnh. Các khối bên trong thường được kết nối với nhau bằng các đường truyền rộng 256 byte. Bắt đầu từ góc trên bên phải, Matrix Multiply Unit là trung tâm của TPU. Nó chứa 256x256 MAC có thể thực hiện phép nhân-cộng 8-bit trên các số nguyên có dấu hoặc không dấu. Các tích 16-bit được tập hợp trong 4 MiB Accumulators 32-bit bên dưới đơn vị ma trận. 4MiB biểu diễn 4096 accumulator 32-bit, mỗi accumulator gồm 256 phần tử. Đơn vị ma trận tạo ra một tổng từng phần gồm 256 phần tử trong mỗi chu kỳ xung nhịp. Chúng tôi chọn 4096 bằng cách trước hết nhận thấy rằng số phép toán trên mỗi byte cần thiết để đạt hiệu năng cực đại (điểm gối roofline trong Section 4) là ~1350, nên chúng tôi làm tròn lên 2048 rồi nhân đôi nó để trình biên dịch có thể sử dụng double buffering khi chạy ở hiệu năng cực đại.
Khi sử dụng kết hợp các trọng số 8-bit và các activation 16-bit (hoặc ngược lại), Matrix Unit tính toán ở tốc độ bằng một nửa, và tính toán ở tốc độ bằng một phần tư khi cả hai đều là 16 bit. Nó đọc và ghi 256 giá trị trong mỗi chu kỳ xung nhịp và có thể thực hiện phép nhân ma trận hoặc tích chập. Đơn vị ma trận chứa một tile trọng số 64 KiB cộng thêm một tile để double-buffering (để che giấu 256 chu kỳ cần thiết để dịch một tile vào). Đơn vị này được thiết kế cho các ma trận dày. Hỗ trợ kiến trúc thưa bị loại bỏ vì lý do thời gian triển khai. Tính thưa sẽ được ưu tiên cao trong các thiết kế tương lai.
Các trọng số cho đơn vị ma trận được đưa qua một Weight FIFO on-chip, đọc từ một DRAM 8 GiB off-chip gọi là Weight Memory (đối với suy luận, các trọng số chỉ được đọc; 8 GiB hỗ trợ nhiều mô hình đang hoạt động đồng thời). Weight FIFO có độ sâu bốn tile. Các kết quả trung gian được lưu trong Unified Buffer on-chip 24 MiB, có thể cung cấp đầu vào cho Matrix Unit. Một bộ điều khiển DMA có thể lập trình truyền dữ liệu đến hoặc từ bộ nhớ Host CPU và Unified Buffer.
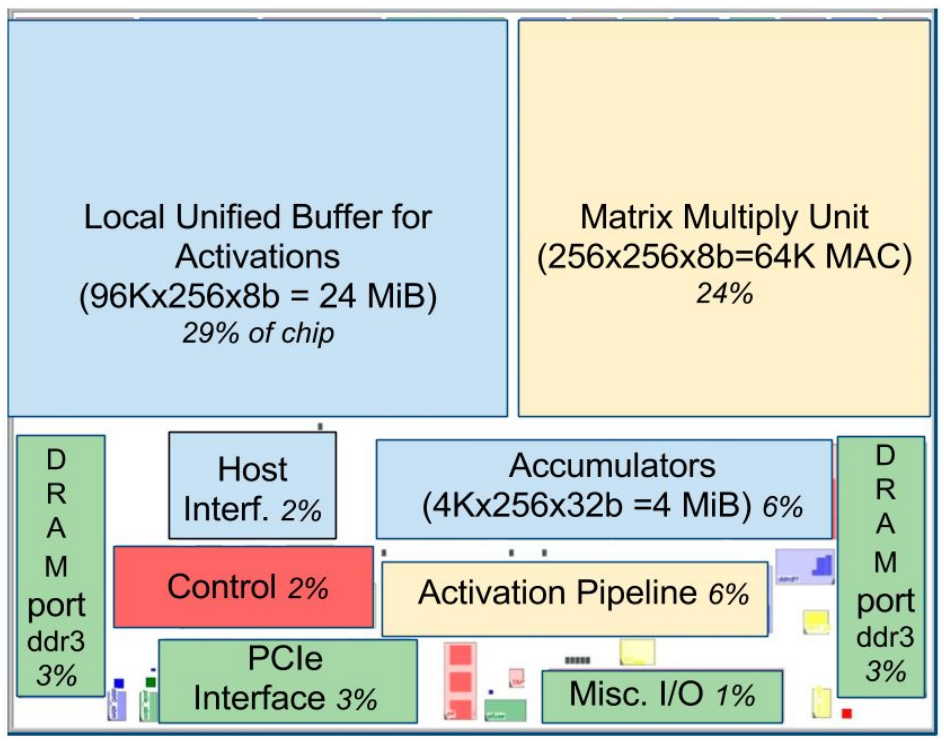
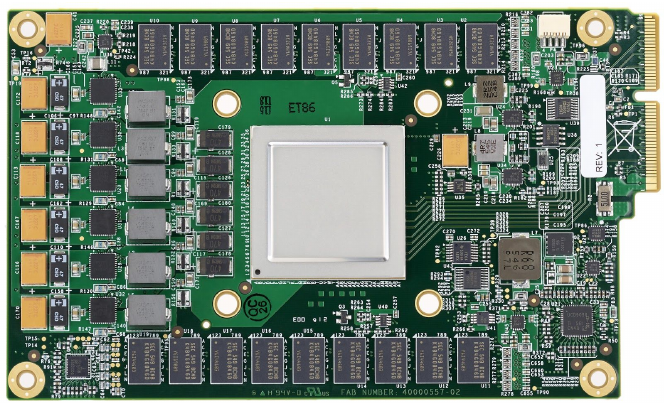
Hình 2 cho thấy sơ đồ bố trí khuôn của TPU. Unified Buffer 24 MiB chiếm gần một phần ba khuôn và Matrix Multiply Unit chiếm một phần tư, do đó datapath chiếm gần hai phần ba khuôn. Kích thước 24 MiB được chọn một phần để phù hợp với pitch của Matrix Unit trên khuôn và, do lịch trình phát triển ngắn, một phần để đơn giản hóa trình biên dịch (xem Section 7). Phần điều khiển chỉ chiếm 2%. Hình 3 cho thấy TPU trên card mạch in của nó, được cắm vào các server hiện có giống như một đĩa SATA.
Vì các lệnh được gửi qua bus PCIe tương đối chậm, các lệnh TPU tuân theo truyền thống CISC, bao gồm một trường lặp. Số chu kỳ xung nhịp trung bình trên mỗi lệnh (CPI) của các lệnh CISC này thường là 10 đến 20. Tổng cộng nó có khoảng một tá lệnh, nhưng năm lệnh sau đây là những lệnh then chốt:
- Read_Host_Memory đọc dữ liệu từ bộ nhớ máy chủ CPU vào Unified Buffer (UB).
- Read_Weights đọc các trọng số từ Weight Memory vào Weight FIFO làm đầu vào cho Matrix Unit.
- MatrixMultiply/Convolve khiến Matrix Unit thực hiện phép nhân ma trận hoặc tích chập từ Unified Buffer vào các Accumulators. Một phép toán ma trận nhận đầu vào B256 có kích thước biến thiên, nhân nó với đầu vào trọng số hằng 256x256, và tạo ra đầu ra B256, cần B chu kỳ được đường ống hóa để hoàn thành.
- Activate thực hiện hàm phi tuyến của nơ-ron nhân tạo, với các tùy chọn cho ReLU, Sigmoid, v.v. Các đầu vào của nó là các Accumulator, và đầu ra của nó là Unified Buffer. Nó cũng có thể thực hiện các phép pooling cần thiết cho các phép tích chập bằng cách sử dụng phần cứng chuyên dụng trên die, vì nó được kết nối với logic hàm phi tuyến.
- Write_Host_Memory ghi dữ liệu từ Unified Buffer vào bộ nhớ host của CPU.
Các lệnh khác là đọc/ghi bộ nhớ host thay thế, thiết lập cấu hình, hai phiên bản đồng bộ hóa, ngắt host, debug-tag, nop, và halt. Lệnh CISC MatrixMultiply có 12 byte, trong đó 3 byte là địa chỉ Unified Buffer; 2 byte là địa chỉ accumulator; 4 byte là độ dài (đôi khi là 2 chiều đối với các phép tích chập); phần còn lại là opcode và cờ.
Triết lý của vi kiến trúc TPU là giữ cho đơn vị ma trận luôn bận. Nó sử dụng pipeline 4 giai đoạn cho các lệnh CISC này, trong đó mỗi lệnh thực thi trong một giai đoạn riêng biệt. Kế hoạch là che giấu việc thực thi các lệnh khác bằng cách chồng lấp việc thực thi của chúng với lệnh MatrixMultiply. Nhằm đạt được mục đích đó, lệnh Read_Weights tuân theo triết lý decoupled-access/execute [Smi82], theo đó nó có thể hoàn thành sau khi gửi địa chỉ của nó nhưng trước khi trọng số được lấy từ Weight Memory. Đơn vị ma trận sẽ bị stall nếu activation đầu vào hoặc dữ liệu trọng số chưa sẵn sàng.
Chúng tôi không có các sơ đồ chồng lấp pipeline rõ ràng, vì các lệnh CISC của chúng tôi có thể chiếm giữ một station trong hàng nghìn chu kỳ clock, không giống pipeline RISC truyền thống với một chu kỳ clock cho mỗi giai đoạn. Các trường hợp thú vị xảy ra khi các activation cho một lớp mạng phải hoàn thành trước khi các phép nhân ma trận của lớp tiếp theo có thể bắt đầu; chúng tôi thấy một “delay slot,” trong đó đơn vị ma trận chờ đồng bộ hóa tường minh trước khi đọc an toàn từ Unified Buffer.
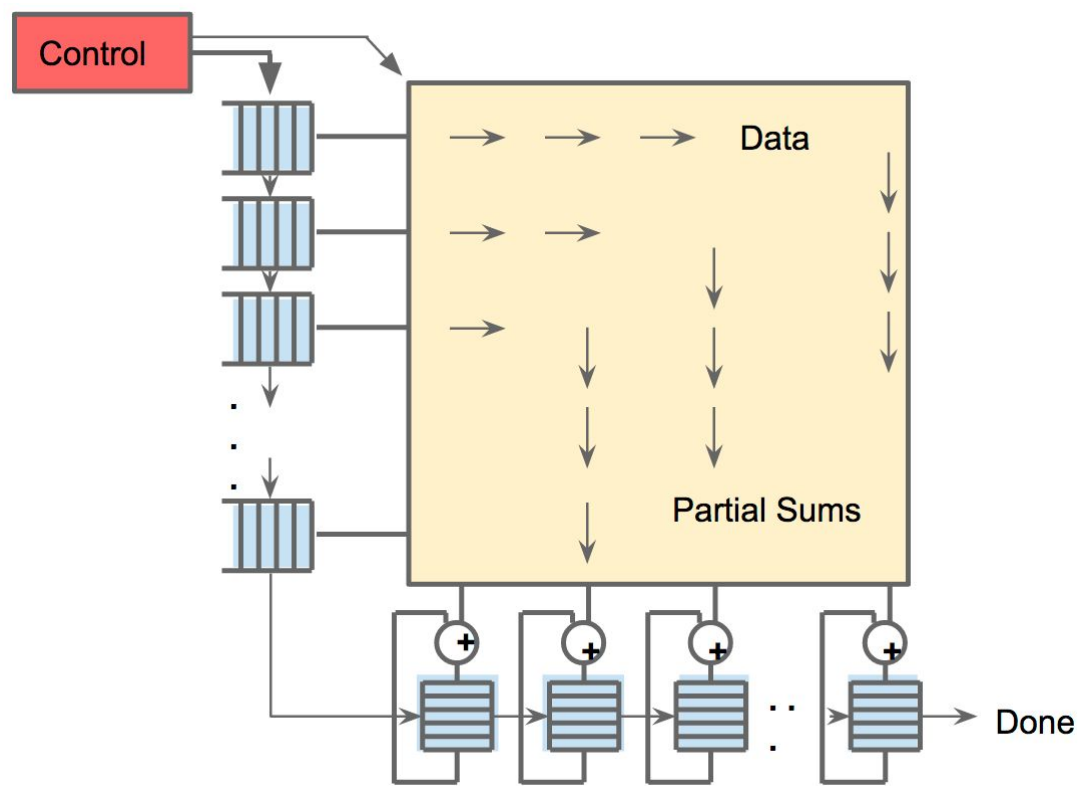
Vì việc đọc một SRAM lớn sử dụng nhiều năng lượng hơn nhiều so với phép toán số học, đơn vị ma trận sử dụng thực thi systolic để tiết kiệm năng lượng bằng cách giảm số lần đọc và ghi của Unified Buffer [Kun80][Ram91][Ovt15b]. Nó dựa vào dữ liệu từ các hướng khác nhau đến các ô trong một mảng tại các khoảng thời gian đều đặn, nơi chúng được kết hợp. Figure 4 cho thấy dữ liệu chảy vào từ bên trái, và các trọng số được nạp từ phía trên. Một phép nhân-tích lũy 256 phần tử nhất định di chuyển qua ma trận như một mặt sóng chéo. Các trọng số được nạp trước, và có hiệu lực cùng với mặt sóng đang tiến lên song song với dữ liệu đầu tiên của một block mới. Điều khiển và dữ liệu được pipeline để tạo ra ảo giác rằng 256 đầu vào được đọc cùng lúc, và rằng chúng cập nhật tức thời một vị trí của mỗi trong 256 accumulator. Xét về tính đúng đắn, phần mềm không nhận biết bản chất systolic của đơn vị ma trận, nhưng về hiệu năng, nó quan tâm đến độ trễ của đơn vị.
Ngăn xếp phần mềm TPU phải tương thích với các ngăn xếp được phát triển cho CPU và GPU để các ứng dụng có thể được chuyển nhanh sang TPU. Phần của ứng dụng chạy trên TPU thường được viết bằng TensorFlow và được biên dịch thành một API có thể chạy trên GPU hoặc TPU [Lar16]. Giống như GPU, ngăn xếp TPU được chia thành User Space Driver và Kernel Driver. Kernel Driver nhẹ và chỉ xử lý quản lý bộ nhớ và các ngắt. Nó được thiết kế để ổn định trong dài hạn. User Space driver thay đổi thường xuyên. Nó thiết lập và điều khiển thực thi TPU, định dạng lại dữ liệu theo thứ tự TPU, dịch các lời gọi API thành các lệnh TPU, và biến chúng thành một binary ứng dụng. User Space driver biên dịch một mô hình lần đầu tiên nó được đánh giá, lưu cache ảnh chương trình và ghi ảnh trọng số vào bộ nhớ trọng số của TPU; lần đánh giá thứ hai và các lần tiếp theo chạy ở tốc độ tối đa. TPU chạy hầu hết các mô hình hoàn toàn từ đầu vào đến đầu ra, tối đa hóa tỷ lệ giữa thời gian tính toán TPU và thời gian I/O. Tính toán thường được thực hiện từng lớp một, với thực thi chồng lấp cho phép đơn vị nhân ma trận che giấu hầu hết các thao tác không nằm trên đường quan trọng.
              Model  Die  Benchmarked Servers  Measured
mm^2  nm  MHz  TDP  Measured  TOPS/s  GB/s  On-Chip Memory  Dies  DRAM Size  TDP  Idle  Busy
Haswell E5-2699 v3  662  22  2300  145W  41W  145W  2.6  1.3  51  51 MiB  2  256 GiB  504W  159W  455W
NVIDIA K80 (2 dies/card)  561  28  560  150W  25W  98W  --  2.8  160  8 MiB  8  256 GiB (host) + 12 GiB x 8  1838W  357W  991W
TPU  NA*  28  700  75W  28W  40W  92  --  34  28 MiB  4  256 GiB (host) + 8 GiB x 4  861W  290W  384W
Table 2. Các server được đo chuẩn sử dụng CPU Haswell, GPU K80, và TPU. Haswell có 18 lõi, và K80 có 13 bộ xử lý SMX. Figure 10 có công suất đã đo. TPU công suất thấp cho phép mật độ cấp rack tốt hơn so với GPU công suất cao. 8 GiB DRAM trên mỗi TPU là Weight Memory. Chế độ GPU Boost không được sử dụng (Sec. 8). SECDEC và không sử dụng chế độ Boost làm giảm băng thông K80 từ 240 xuống 160. Không sử dụng chế độ Boost và hiệu năng của single die so với dual die làm giảm TOPS cực đại của K80 từ 8.7 xuống 2.8. (*Die TPU có kích thước ≤ một nửa kích thước die Haswell.)
3 Các nền tảng CPU, GPU và TPU
Sáu ứng dụng đang vận hành thực tế trong Bảng 1 là tải công việc của chúng tôi trong bài báo này. Như đã đề cập ở trên, sáu ứng dụng này đại diện cho 95% mức sử dụng TPU trong các trung tâm dữ liệu của chúng tôi. Trớ trêu thay, việc triển khai và đo lường các mạng nơ-ron sâu (DNN) nhỏ phổ biến như AlexNet hoặc VGG trên các máy đang vận hành thực tế lại khó khăn. Tuy nhiên, một trong các mạng nơ-ron tích chập (CNN) của chúng tôi bắt nguồn từ Inception V2, vốn được sử dụng rộng rãi.
Các nền tảng đo chuẩn là những máy tính cấp server có sẵn vào năm 2015, khi TPU được triển khai. Ràng buộc này có nghĩa là chúng phải có ít nhất cơ chế bảo vệ sửa lỗi một bit và phát hiện lỗi hai bit (SECDED) cho SRAM bên trong cũng như bộ nhớ DRAM bên ngoài giống như TPU, qua đó loại trừ một số lựa chọn như GPU Nvidia Maxwell. Để công ty chúng tôi mua và triển khai, chúng cũng phải là những máy có cấu hình hợp lý, chứ không phải những hệ thống chắp vá được lắp ráp chỉ để thắng các phép đo chuẩn.
Bảng 2 liệt kê các lựa chọn của chúng tôi. Đại diện cho server CPU truyền thống là bộ xử lý Haswell 18 lõi của Intel trong hệ thống hai socket. Nền tảng này cũng là server chủ cho GPU hoặc TPU. Haswell được chế tạo bằng quy trình 22nm của Intel. Cả CPU lẫn GPU đều có đế bán dẫn rất lớn: khoảng 600 mm²!
Tần số xung nhịp CPU 2.3 GHz không bao gồm chế độ Turbo vì chế độ này hiếm khi hoạt động với các ứng dụng mạng nơ-ron trong các trung tâm dữ liệu của chúng tôi. Haswell có các tần số xung nhịp khác nhau tùy thuộc vào việc chương trình có sử dụng các lệnh AVX hay không; các ứng dụng mạng nơ-ron của chúng tôi thường sử dụng những lệnh này. Tần số xung nhịp cao hơn của chế độ Turbo (dành cho các chương trình không dùng AVX) xuất hiện khi chúng không sử dụng hết các lõi. Do đó, một lý do khác khiến chế độ Turbo hiếm khi hoạt động trong các trung tâm dữ liệu của chúng tôi là các ứng dụng thường sử dụng hết các lõi; hơn nữa, các máy có thể chạy những công việc khác của trung tâm dữ liệu để tận dụng mọi lõi đang nhàn rỗi.
Bộ tăng tốc GPU là Nvidia K80. Mỗi card K80 chứa hai đế bán dẫn và cung cấp SECDED cho bộ nhớ bên trong và DRAM. Nvidia tuyên bố rằng “Bộ tăng tốc K80 giảm mạnh chi phí trung tâm dữ liệu bằng cách cung cấp hiệu năng ứng dụng với ít server hơn nhưng mạnh hơn”[Nvi16]. Các nhà nghiên cứu mạng nơ-ron thường xuyên sử dụng K80 vào năm 2015, và đến tận tháng 9 năm 2016, K80 vẫn được chọn cho các dịch vụ GPU mới trên nền tảng đám mây [Bar16].
Có thể lắp tối đa tám đế bán dẫn K80 trên bốn card vào server này, và đây là cấu hình chúng tôi dùng để đo chuẩn. K80 cung cấp chế độ Boost để tăng tần số xung nhịp lên tới 875 MHz. Chế độ Turbo trong Haswell được phần cứng điều khiển nên có thể hoạt động trong những đợt ngắn trước khi nhiệt độ chip tăng đáng kể. Tuy nhiên, chế độ Boost do trình điều khiển phần mềm kiểm soát [Nvi15], nên kéo dài ít nhất hàng trăm mili giây. Vì vậy, hệ thống cấp điện và làm mát phải được trang bị cho K80 như thể nó gần như luôn chạy ở chế độ Boost; nếu không, các chip có thể quá nóng. Với nền tảng này, bật chế độ Boost sẽ buộc chúng tôi phải giảm số lượng card K80, gây bất lợi về tổng chi phí sở hữu. Do đó, chế độ Boost bị tắt. Ràng buộc này làm giảm băng thông đỉnh và TOPS (xem chú thích Bảng 2); Mục 8 xem xét trường hợp chế độ này được bật.
Vì số đế bán dẫn trên mỗi server được đo chuẩn dao động từ 2 đến 8, các kết quả dưới đây thường được chúng tôi chuẩn hóa theo từng đế bán dẫn (các Hình 5-8, các Hình 10-11 và các Bảng 3, 4 và 6), nhưng đôi khi chúng tôi trình bày kết quả cho toàn bộ hệ thống (Hình 9). Chúng tôi hy vọng sự phân biệt này là rõ ràng.
4 Hiệu năng: Roofline, thời gian đáp ứng, và thông lượng
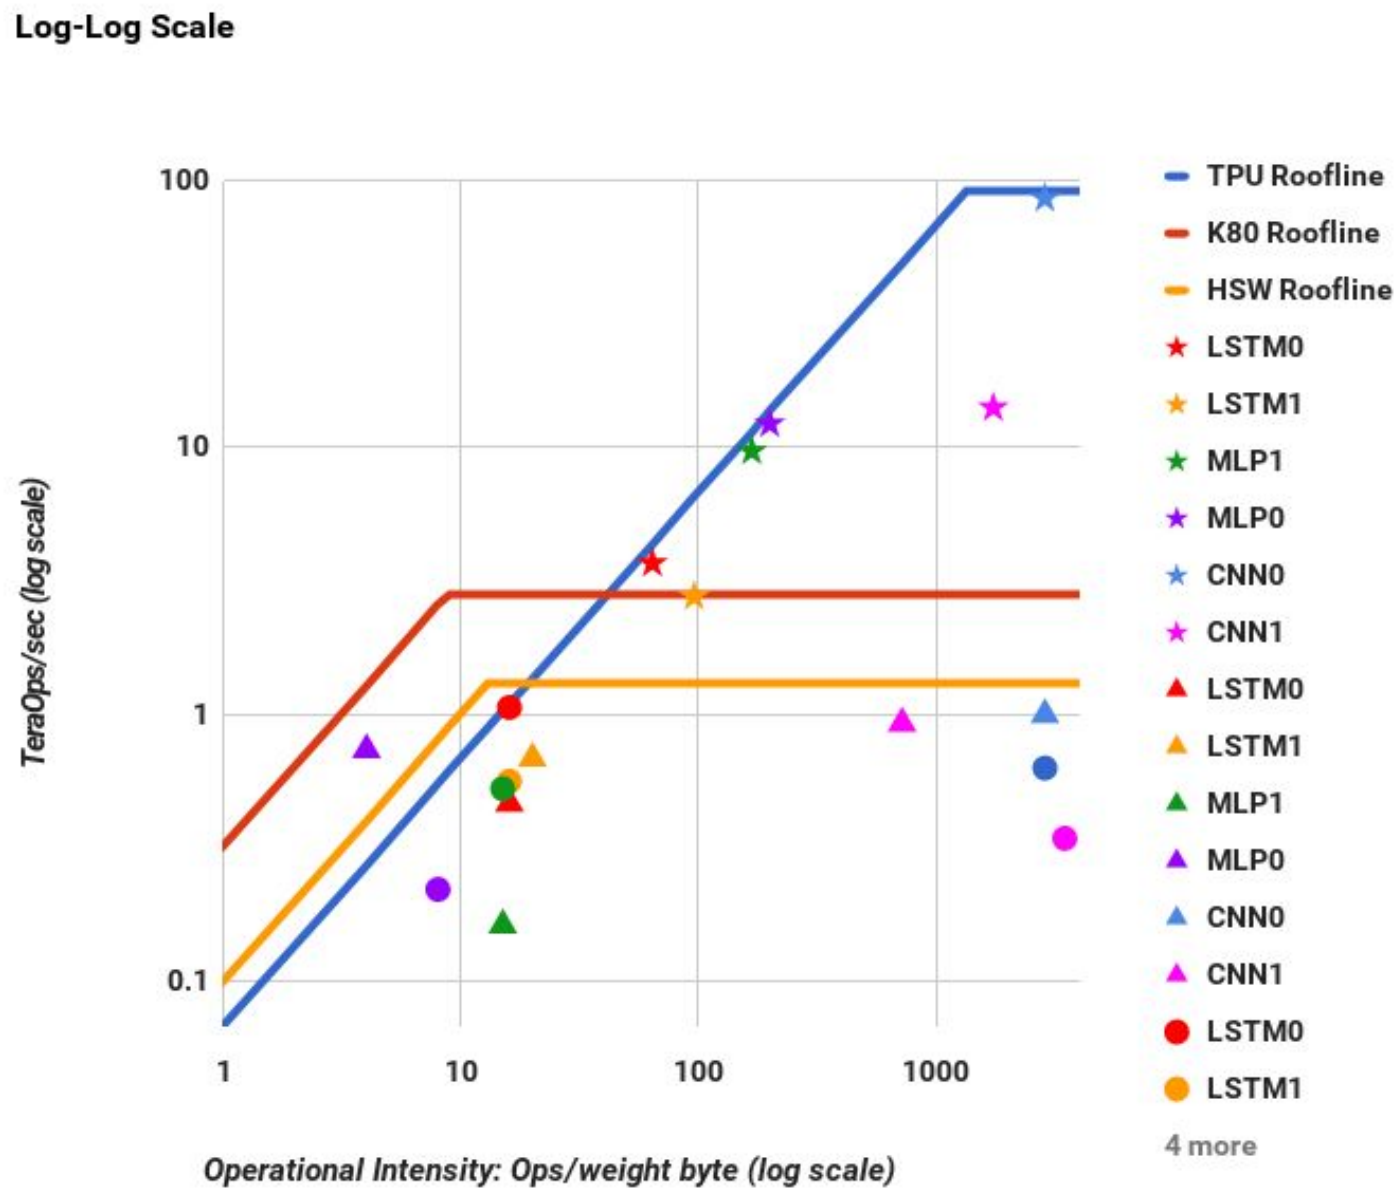
Để minh họa hiệu năng của sáu ứng dụng trên ba bộ xử lý, chúng tôi điều chỉnh mô hình Hiệu năng Roofline từ lĩnh vực tính toán hiệu năng cao (HPC) [Wil09]. Mô hình trực quan đơn giản này không hoàn hảo, tuy nhiên nó cung cấp những hiểu biết về nguyên nhân của các nút thắt hiệu năng. Giả định đằng sau mô hình là các ứng dụng không vừa trong các cache on-chip, vì vậy chúng bị giới hạn bởi tính toán hoặc bị giới hạn bởi băng thông bộ nhớ. Đối với HPC, trục Y là hiệu năng theo số phép toán dấu phẩy động trên giây, do đó tốc độ tính toán cực đại tạo thành phần “phẳng” của đường mái. Trục X là cường độ vận hành, được đo bằng số phép toán dấu phẩy động trên mỗi byte DRAM được truy cập. Băng thông bộ nhớ là số byte trên giây, biến thành phần “xiên” của đường mái vì (FLOPS/sec)/(FLOPS/Byte) = Bytes/sec. Nếu không có đủ cường độ vận hành, một chương trình bị giới hạn bởi băng thông bộ nhớ và nằm dưới phần xiên của đường mái.
Khoảng cách giữa số phép toán thực tế trên giây của một ứng dụng và mức trần ngay phía trên nó cho thấy lợi ích tiềm năng của việc tinh chỉnh hiệu năng thêm trong khi giữ nguyên cường độ vận hành; tất nhiên, các tối ưu hóa làm tăng cường độ vận hành (chẳng hạn như cache blocking) có thể mang lại lợi ích còn lớn hơn.
Để sử dụng mô hình Roofline cho TPU, khi các ứng dụng NN được lượng tử hóa, trước tiên chúng tôi thay thế các phép toán dấu phẩy động bằng các phép toán số nguyên. Vì các trọng số thường không vừa trong bộ nhớ on-chip đối với các ứng dụng NN, thay đổi thứ hai là định nghĩa lại cường độ vận hành thành số phép toán số nguyên trên mỗi byte của weights được đọc (xem cột thứ mười của Table 1).
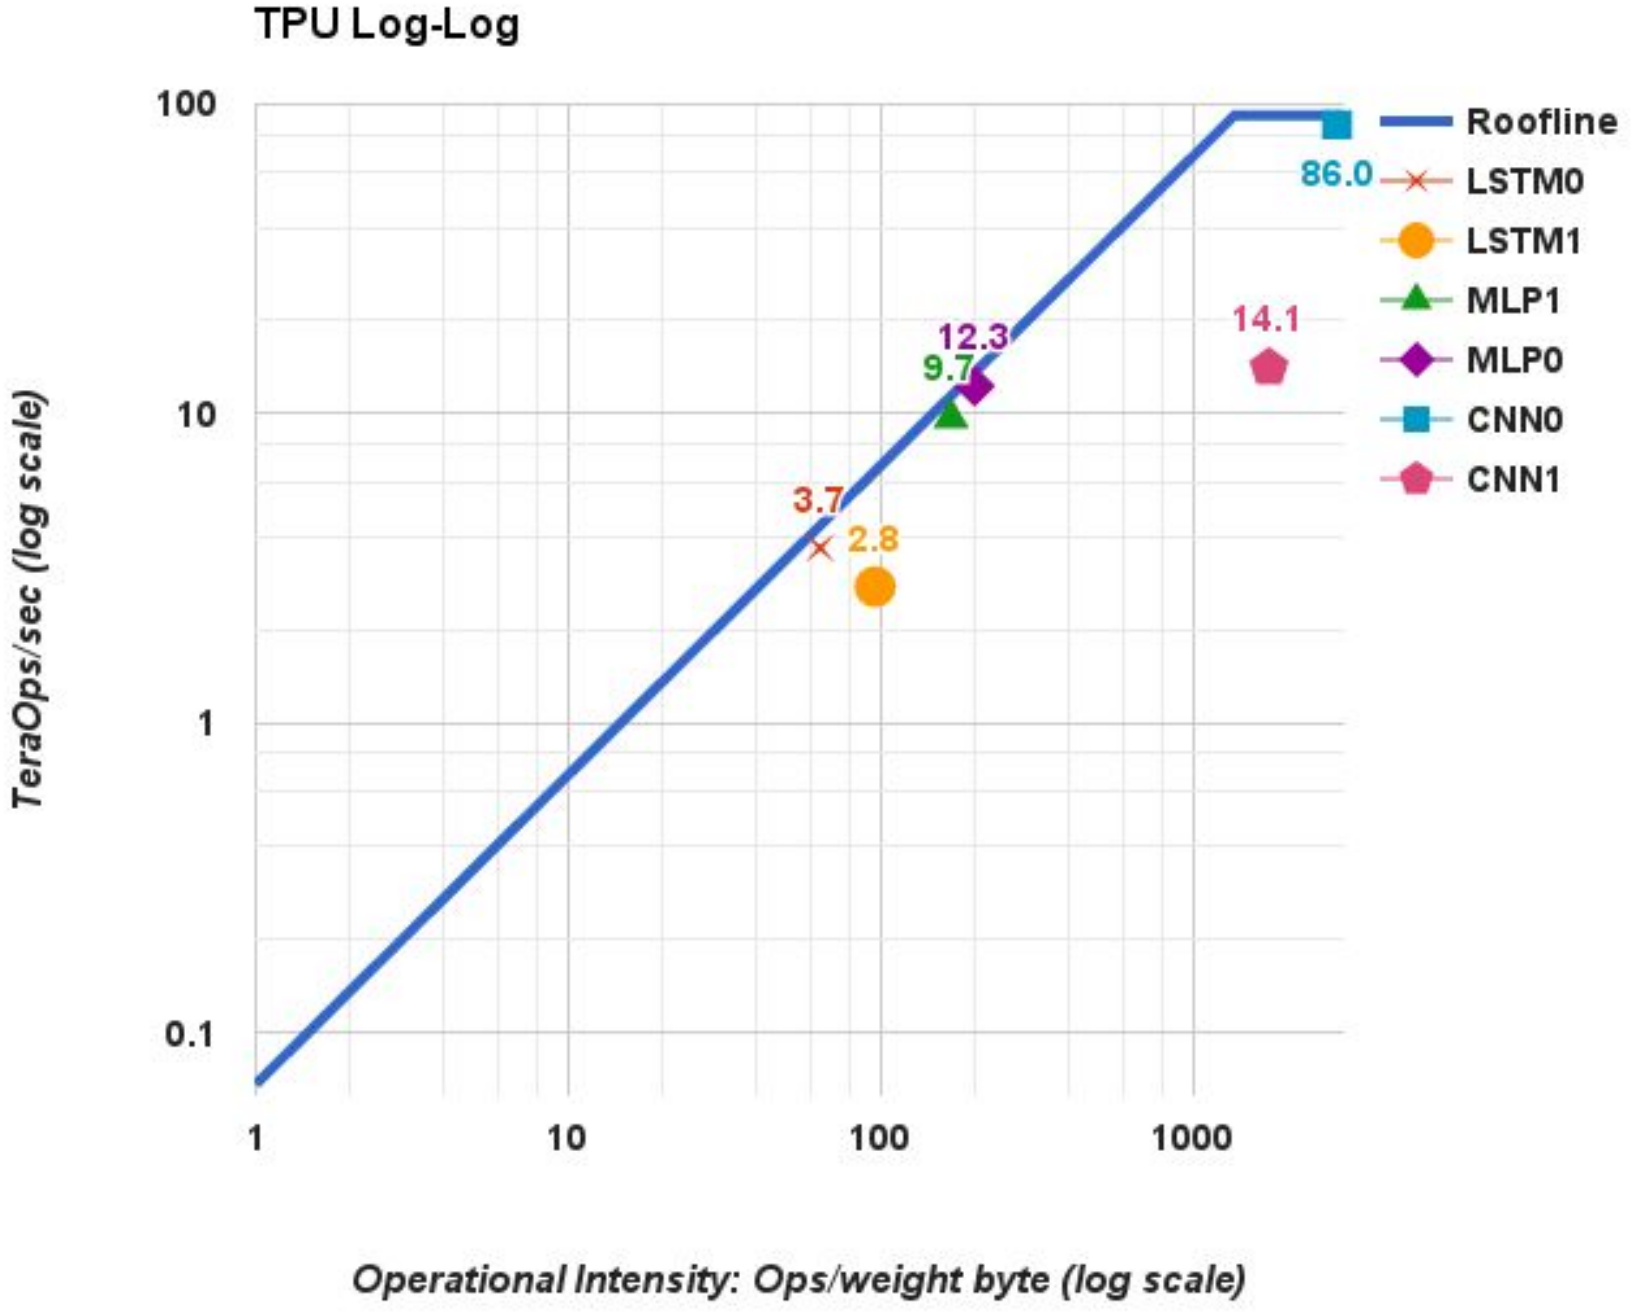
Figure 5 cho thấy mô hình Roofline cho một die TPU đơn lẻ trên các thang đo log-log. TPU có một phần “xiên” dài của đường mái, trong đó cường độ vận hành có nghĩa là hiệu năng bị giới hạn bởi băng thông bộ nhớ thay vì bởi tính toán cực đại. Năm trong sáu ứng dụng đang chạm vào mức trần: các MLP và LSTM bị giới hạn bởi bộ nhớ, còn CNN bị giới hạn bởi tính toán. CNN1, mặc dù có cường độ vận hành rất cao, chỉ chạy ở 14.1 TOPS trong khi CNN0 chạy ở 86 TOPS.
Table 3 giải thích điều gì đã xảy ra với CNN1, dựa trên các bộ đếm hiệu năng cung cấp cho chúng tôi khả năng quan sát một phần hoạt động của TPU. TPU dành ít hơn một nửa số chu kỳ của nó để thực hiện các phép toán ma trận cho CNN1 (cột 7, hàng 1). Trong mỗi chu kỳ hoạt động đó, chỉ khoảng một nửa trong số 65,536 MAC chứa các trọng số hữu ích vì một số lớp trong CNN1 có độ sâu đặc trưng nhỏ. Khoảng 35% số chu kỳ được dành để chờ các trọng số được nạp từ bộ nhớ vào đơn vị ma trận, điều này xảy ra trong 4 lớp kết nối đầy đủ chạy ở cường độ vận hành chỉ 32 (xem Fallacy cuối cùng trong Section 8). Điều này để lại khoảng 19% số chu kỳ chưa được giải thích bởi các bộ đếm liên quan đến ma trận. Do thực thi chồng lấp trên TPU, chúng tôi không có hạch toán chính xác cho các chu kỳ đó, nhưng chúng tôi có thể thấy rằng 23% số chu kỳ có các lần dừng do các phụ thuộc RAW trong đường ống, và 1% được dành để dừng do đầu vào qua bus PCIe.
| Ứng dụng | MLP0 | MLP1 | LSTM0 | LSTM1 | CNN0 | CNN1 | Trung bình | Hàng |
|---|---|---|---|---|---|---|---|---|
| Các chu kỳ hoạt động của mảng | 12.7% | 10.6% | 8.2% | 10.5% | 78.2% | 46.2% | 28% | 1 |
| MAC hữu ích trong ma trận 64K (% cực đại) | 12.5% | 9.4% | 8.2% | 6.3% | 78.2% | 22.5% | 23% | 2 |
| MAC không được sử dụng | 0.3% | 1.2% | 0.0% | 4.2% | 0.0% | 23.7% | 5% | 3 |
| Các chu kỳ dừng do trọng số | 53.9% | 44.2% | 58.1% | 62.1% | 0.0% | 28.1% | 43% | 4 |
| Các chu kỳ dịch chuyển trọng số | 15.9% | 13.4% | 15.8% | 17.1% | 0.0% | 7.0% | 12% | 5 |
| Các chu kỳ không thuộc ma trận | 17.5% | 31.9% | 17.9% | 10.3% | 21.8% | 18.7% | 20% | 6 |
| Các lần dừng RAW | 3.3% | 8.4% | 14.6% | 10.6% | 3.5% | 22.8% | 11% | 7 |
| Các lần dừng dữ liệu đầu vào | 6.1% | 8.8% | 5.1% | 2.4% | 3.4% | 0.6% | 4% | 8 |
| TeraOps/sec (92 Peak) | 12.3 | 9.7 | 3.7 | 2.8 | 86.0 | 14.1 | 21.4 | 9 |
Table 3. Các yếu tố giới hạn hiệu năng TPU của tải công việc NN dựa trên các bộ đếm hiệu năng phần cứng. Các hàng 1, 4, 5, và 6 tổng cộng bằng 100% và dựa trên các phép đo hoạt động của đơn vị ma trận. Các hàng 2 và 3 tiếp tục phân rã phần nhỏ của 64K trọng số trong đơn vị ma trận chứa các trọng số hữu ích trong các chu kỳ hoạt động. Các bộ đếm của chúng tôi không thể giải thích chính xác thời gian khi đơn vị ma trận không hoạt động trong hàng 6; các hàng 7 và 8 hiển thị các bộ đếm cho hai nguyên nhân có thể, bao gồm các nguy cơ của đường ống RAW và các lần dừng đầu vào PCIe. Hàng 9 (TOPS) dựa trên các phép đo của mã sản xuất trong khi các hàng khác dựa trên các phép đo bộ đếm hiệu năng, vì vậy chúng không hoàn toàn nhất quán. Chi phí phụ trội của server máy chủ được loại trừ ở đây. Các MLP và LSTM bị giới hạn bởi băng thông bộ nhớ nhưng CNN thì không. Kết quả CNN1 được giải thích trong văn bản.
Figure.
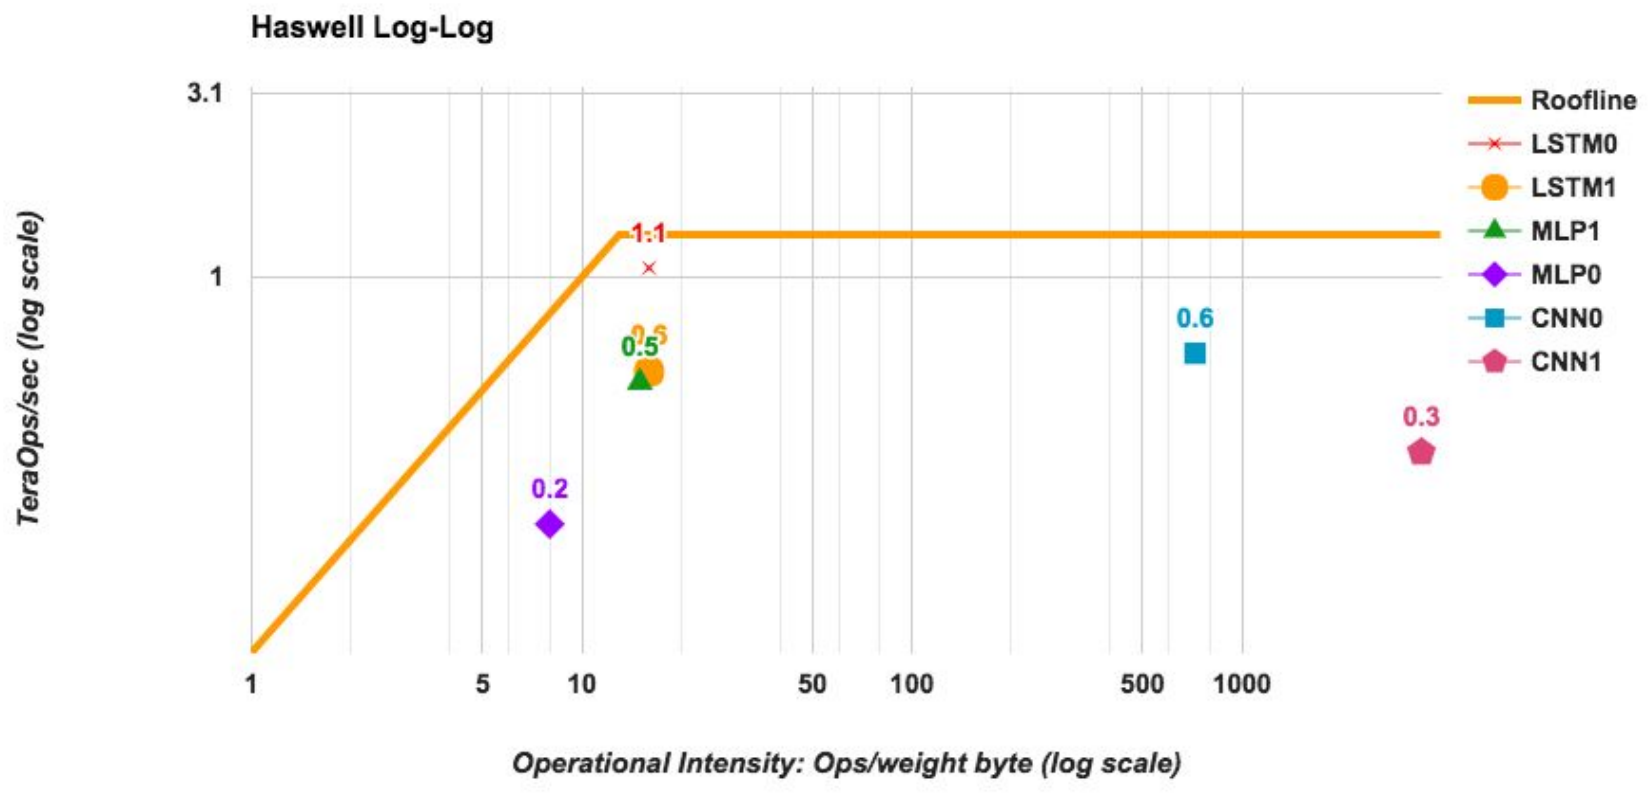
Figure.
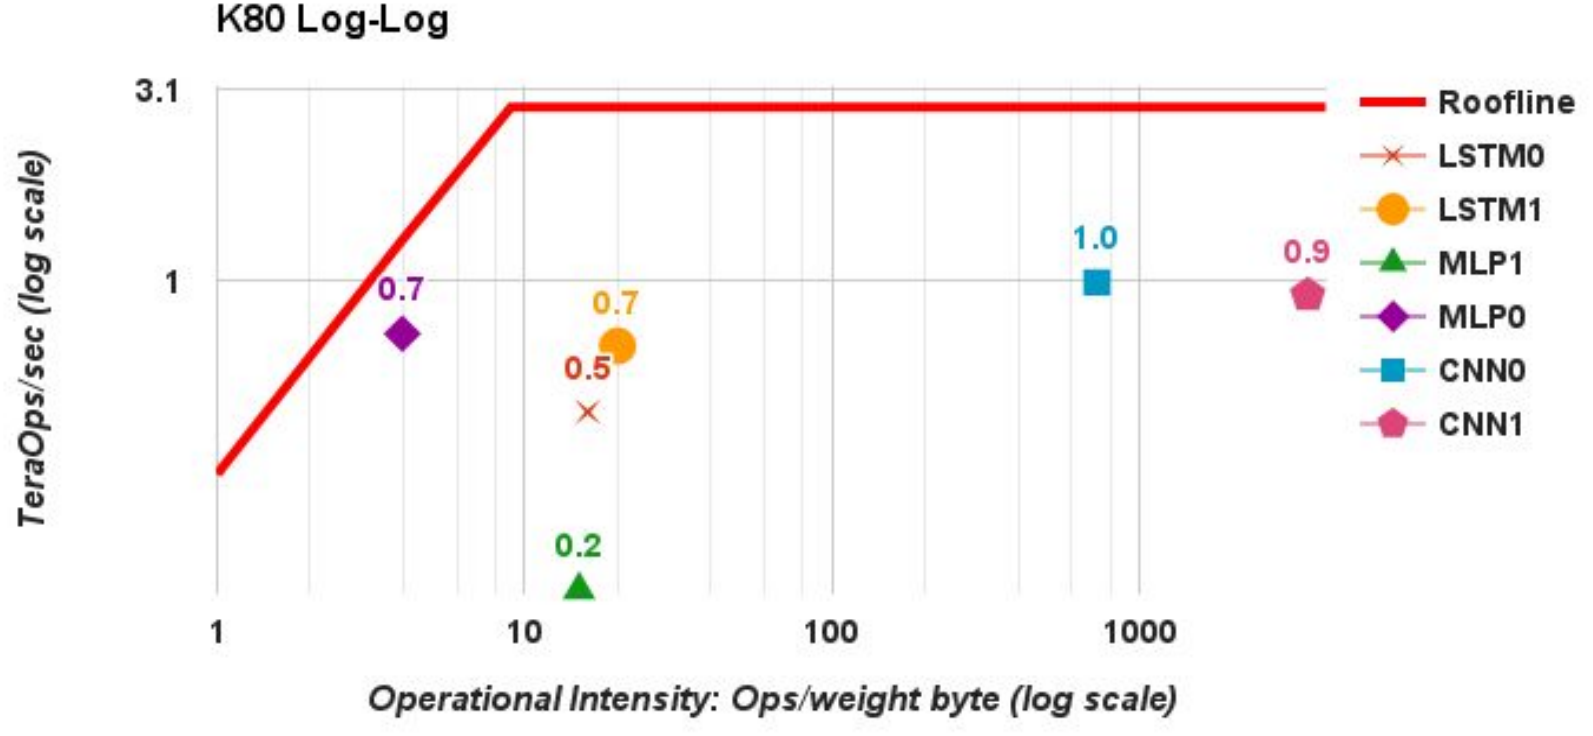
Hình 6 và 7 cho thấy các đường mái (roofline) cho một die Haswell đơn và một die K80 đơn. Sáu ứng dụng NN nhìn chung nằm xa hơn bên dưới các giới hạn của chúng so với TPU trong Hình 5. Thời gian đáp ứng là lý do. Nhiều ứng dụng NN này là các phần của các dịch vụ hướng đến người dùng cuối. Các nhà nghiên cứu đã chứng minh rằng những gia tăng nhỏ trong thời gian đáp ứng khiến khách hàng sử dụng một dịch vụ ít hơn [Sch09]. Vì vậy, trong khi huấn luyện có thể không có các thời hạn cứng về thời gian đáp ứng, suy luận thường có. Nghĩa là, suy luận ưu tiên độ trễ hơn thông lượng [Pat04].
Bảng 4 minh họa tác động của giới hạn thời gian đáp ứng phân vị thứ 99 là 7 ms đối với MLP0 trên Haswell và K80 [Dea13], giới hạn này được yêu cầu bởi nhà phát triển ứng dụng. (Số lần suy luận mỗi giây và độ trễ 7 ms bao gồm thời gian của server host cũng như thời gian của bộ tăng tốc.) Chúng hoạt động lần lượt ở mức 42% và 37% thông lượng cao nhất có thể đạt được cho MLP0 nếu giới hạn thời gian đáp ứng được nới lỏng. Vì vậy, mặc dù CPU và GPU có thông lượng tiềm năng cao hơn nhiều, nó bị lãng phí nếu chúng không đáp ứng giới hạn thời gian đáp ứng. Các cận này cũng ảnh hưởng đến TPU, nhưng ở mức 80% trong Bảng 4, nó đang hoạt động gần hơn nhiều với thông lượng MLP0 cao nhất của mình. So với CPU và GPU, TPU đơn luồng không có bất kỳ tính năng vi kiến trúc phức tạp nào tiêu tốn transistor và năng lượng để cải thiện trường hợp trung bình nhưng không cải thiện trường hợp phân vị thứ 99: không có cache, dự đoán nhánh, thực thi ngoài thứ tự, xử lý đa tiến trình, nạp trước đầu cơ, hợp nhất địa chỉ, đa luồng, chuyển đổi ngữ cảnh, v.v. Chủ nghĩa tối giản là một ưu điểm của các bộ xử lý chuyên biệt theo miền.
Bảng 3 cho thấy hiệu năng TPU, nhưng nó không tính đến thời gian của server host, thời gian này có thể được chia thành việc chạy phần ứng dụng trên host và việc giao tiếp với TPU. Bảng 5 liệt kê phần thứ hai, nhưng phần thứ nhất thì khó. Lý thuyết hàng đợi cho thấy các hàng đợi đầu vào dài làm tăng thông lượng, bằng cách đảm bảo rằng máy tính không bao giờ ở trạng thái nhàn rỗi, nhưng làm kéo dài thời gian đáp ứng. Vì vậy, hầu hết ứng dụng giữ cho các hàng đợi đầu vào của chúng trống. Tuy nhiên, chúng tôi không thể đo được khi nào TPU nhàn rỗi vì nó đang chờ CPU thực hiện phần ứng dụng của nó hoặc vì CPU cũng nhàn rỗi do hàng đợi đầu vào trống.
Bảng 6 đưa ra kết quả cuối cùng của hiệu năng suy luận tương đối trên mỗi die, bao gồm chi phí phụ trội của server host đối với hai bộ tăng tốc so với CPU. Cột áp chót cho thấy trung bình hình học của hiệu năng tương đối đối với sáu ứng dụng NN, cho thấy die K80 nhanh gấp 1.1X so với die Haswell, die TPU nhanh gấp 14.5 lần, và do đó die TPU nhanh gấp 13.2 lần so với die GPU. Hình 8 biểu diễn trực quan tốc độ tương đối của chúng.
Hãy nhớ rằng các kiến trúc sư sử dụng trung bình hình học khi họ không biết tổ hợp chương trình thực tế sẽ được chạy [Hen18]. Tuy nhiên, đối với nghiên cứu này, chúng tôi biết tổ hợp đó (Bảng 1). Trung bình có trọng số trong cột cuối cùng của Bảng 6 sử dụng tổ hợp thực tế làm tăng GPU lên 1.9X và TPU lên 29.2X, vì vậy die TPU hiện nhanh gấp 15.3 lần so với die GPU.
| Kiểu | Lô | Đáp ứng phân vị thứ 99 | Inf/s (IPS) | % Max IPS |
|---|---|---|---|---|
| CPU | 16 | 7.2 ms | 5,482 | 42% |
| CPU | 64 | 21.3 ms | 13,194 | 100% |
| GPU | 16 | 6.7 ms | 13,461 | 37% |
| GPU | 64 | 8.3 ms | 36,465 | 100% |
| TPU | 200 | 7.0 ms | 225,000 | 80% |
| TPU | 250 | 10.0 ms | 280,000 | 100% |
Bảng 4. Thời gian đáp ứng phân vị thứ 99 và thông lượng trên mỗi die (IPS) cho MLP0 khi kích thước lô thay đổi đối với MLP0. Độ trễ cho phép dài nhất là 7 ms. Đối với GPU và TPU, thông lượng MLP0 tối đa bị giới hạn bởi chi phí phụ trội của server host. Kích thước lô lớn hơn làm tăng thông lượng, nhưng như văn bản giải thích, thời gian đáp ứng dài hơn của chúng vượt quá giới hạn, vì vậy CPU và GPU phải sử dụng kích thước lô nhỏ hơn, kém hiệu quả hơn (16 so với 200).
| MLP0 | MLP1 | LSTM0 | LSTM1 | CNN0 | CNN1 |
|---|---|---|---|---|---|
| 21% | 76% | 11% | 20% | 51% | 14% |
Bảng 5. Thời gian để CPU host tương tác với TPU được biểu diễn dưới dạng phần trăm thời gian thực thi TPU (từ các bộ đếm hiệu năng TPU). Phần này là thời gian CPU và TPU giao tiếp qua bus PCIe, không bao gồm thời gian CPU thực hiện một phần của ứng dụng nhưng không tương tác với TPU. Như văn bản giải thích, TPU khó đo được liệu CPU đang nhàn rỗi hay đang làm việc trên ứng dụng.
| Kiểu | MLP0 | MLP1 | LSTM0 | LSTM1 | CNN0 | CNN1 | GM | WM |
|---|---|---|---|---|---|---|---|---|
| GPU | 2.5 | 0.3 | 0.4 | 1.2 | 1.6 | 2.7 | 1.1 | 1.9 |
| TPU | 41.0 | 18.5 | 3.5 | 1.2 | 40.3 | 71.0 | 14.5 | 29.2 |
| Ratio | 16.7 | 60.0 | 8.0 | 1.0 | 25.4 | 26.3 | 13.2 | 15.3 |
Bảng 6. Hiệu năng die GPU K80 và die TPU tương đối so với CPU đối với tải công việc NN. GM và WM là trung bình hình học và trung bình có trọng số (sử dụng tổ hợp thực tế của sáu ứng dụng trong Bảng 1). Hiệu năng tương đối của GPU và TPU bao gồm chi phí phụ trội của server host. MLP và CNN hoạt động tốt trên TPU. Bảng 4 giải thích rằng TPU có thể có kích thước lô lớn hơn và vẫn đáp ứng các giới hạn thời gian, làm tăng số phép toán trên mỗi byte (Bảng 1) hoặc tương đương, giảm số lần truy cập bộ nhớ trên mỗi phép toán. Ngoài ra, CNN theo bản chất có khả năng tái sử dụng trọng số lớn hơn và do đó có số phép toán trên mỗi byte cao hơn. Vì vậy, băng thông bộ nhớ thấp hơn của TPU không làm giảm đáng kể hiệu năng CNN.
5 Chi phí-Hiệu năng, TCO, và Hiệu năng/Watt
Khi mua máy tính với số lượng hàng nghìn, chi phí-hiệu năng vượt trội hơn hiệu năng. Chỉ số chi phí tốt nhất trong một datacenter là tổng chi phí sở hữu (TCO). Giá thực tế mà chúng tôi trả cho hàng nghìn chip phụ thuộc vào các cuộc đàm phán giữa các công ty liên quan. Vì lý do kinh doanh, chúng tôi không thể công bố thông tin giá như vậy hoặc dữ liệu có thể cho phép suy ra chúng. Tuy nhiên, công suất có tương quan với TCO, và chúng tôi có thể công bố Watts trên mỗi server, vì vậy trong bài báo này chúng tôi sử dụng hiệu năng/Watt làm đại diện cho hiệu năng/TCO. Trong phần này, chúng tôi so sánh toàn bộ server thay vì các die đơn lẻ, như được liệt kê trong các cột “Benchmarked Server” của Table 2.
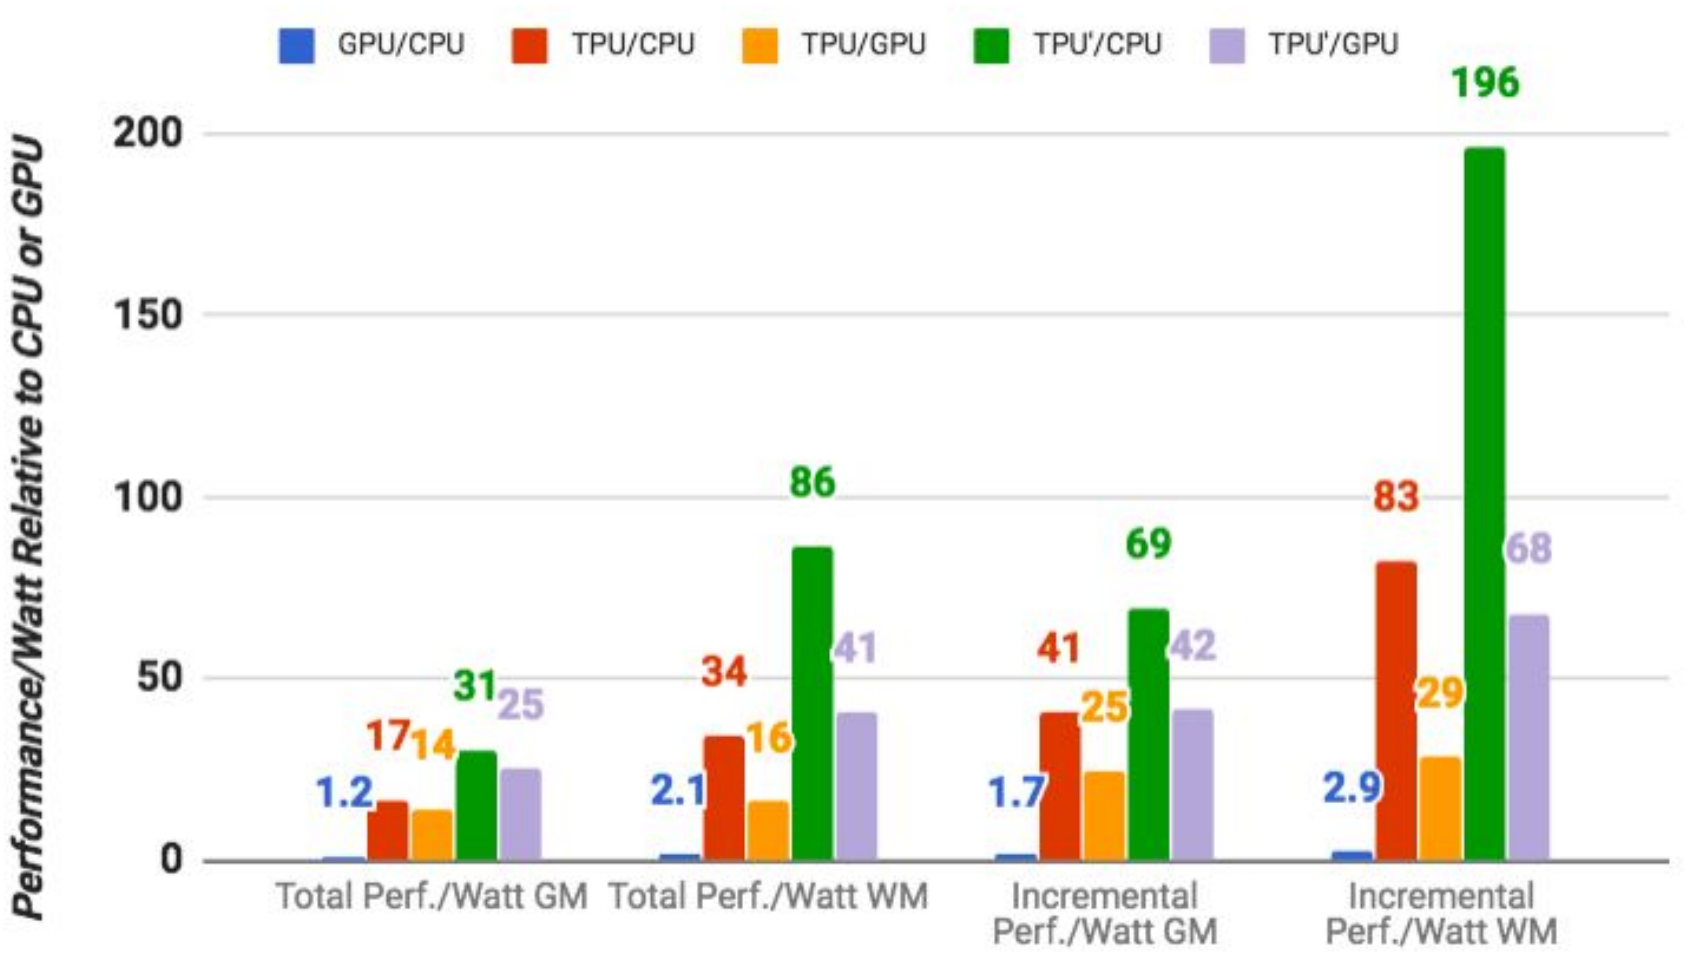
Figure 9 trình bày trung bình hình học và trung bình có trọng số của hiệu năng/Watt đối với GPU K80 và TPU so với CPU Haswell. Chúng tôi trình bày hai cách tính khác nhau của hiệu năng/Watt. Cách thứ nhất (“total”) bao gồm công suất được tiêu thụ bởi server CPU máy chủ khi tính hiệu năng/Watt cho GPU và TPU. Cách thứ hai (“incremental”) trừ công suất của server CPU máy chủ khỏi GPU và TPU trước đó.
Đối với total-performance/Watt, server K80 đạt 1.2 - 2.1X Haswell. Đối với incremental-performance/Watt, khi bỏ qua công suất của server Haswell, server K80 đạt 1.7- 2.9X.
Server TPU có total-performance/Watt tốt hơn Haswell từ 17 đến 34 lần, điều này khiến server TPU đạt hiệu năng/Watt bằng 14 đến 16 lần server K80. incremental-performance/Watt tương đối — là lý do biện minh của công ty chúng tôi cho một ASIC tùy chỉnh — là 41 đến 83 đối với TPU, giúp TPU đạt hiệu năng/Watt bằng 25 đến 29 lần GPU.
6 Tính tỷ lệ thuận với năng lượng
Thermal Design Power (TDP) ảnh hưởng đến chi phí cung cấp nguồn điện, vì cần cung cấp đủ điện năng và làm mát khi phần cứng hoạt động ở công suất tối đa. Tuy nhiên, chi phí điện năng dựa trên mức tiêu thụ trung bình khi tải công việc thay đổi trong ngày. [Bar07] nhận thấy rằng các server bận 100% trong chưa đến 10% thời gian và đề xuất tính tỷ lệ thuận với năng lượng: các server nên tiêu thụ công suất tỷ lệ thuận với lượng công việc được thực hiện. Ước tính công suất tiêu thụ trong phần trước dựa trên tỷ lệ của TDP đã được quan sát trong các datacenter của chúng tôi.
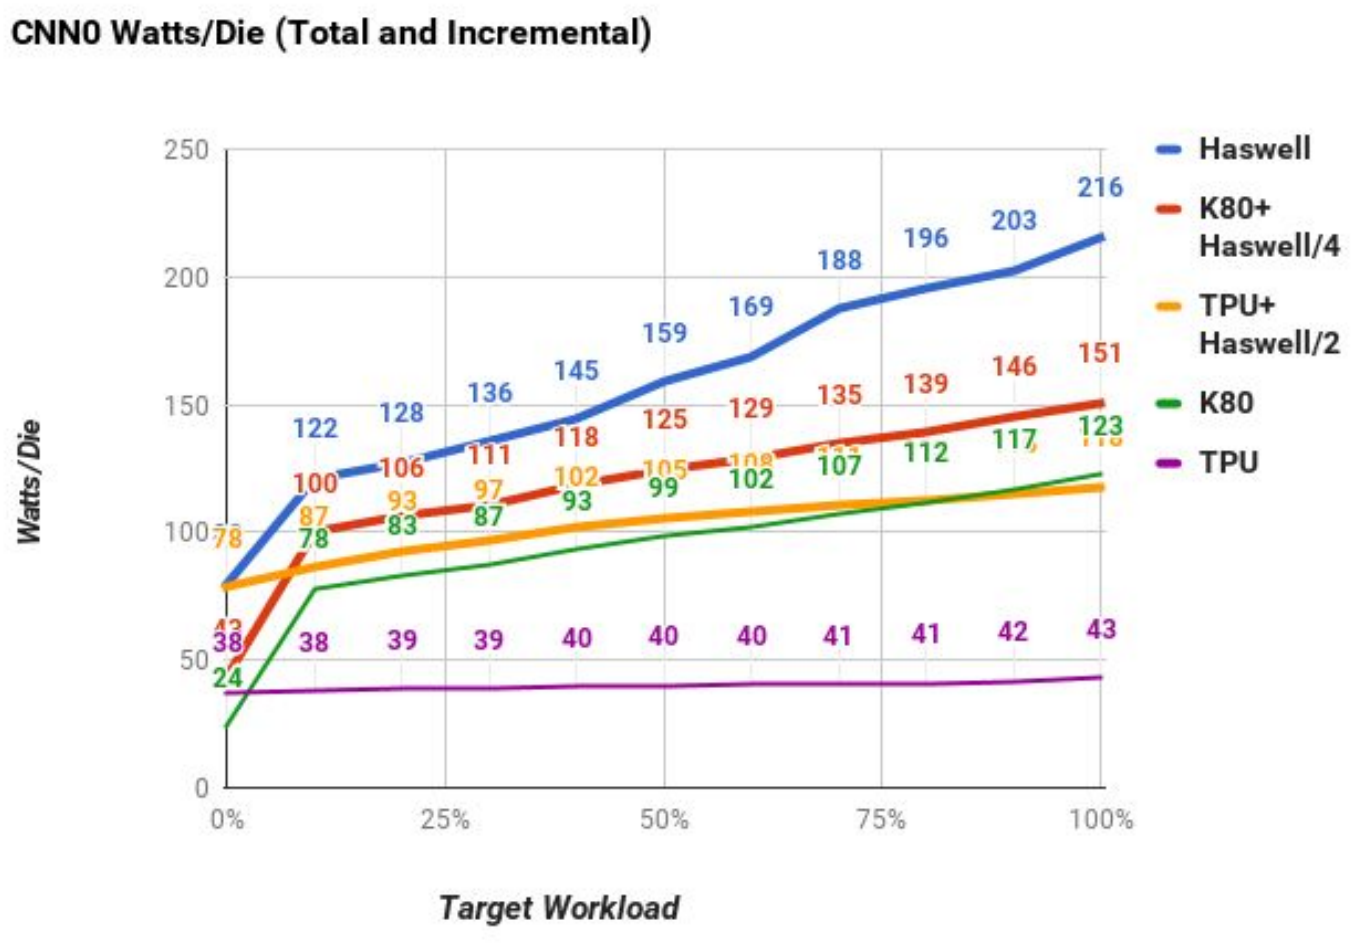
Chúng tôi đo hiệu năng và công suất khi mức sử dụng tải công việc được cung cấp thay đổi từ 0% đến 100%, được thu thập trong các nhóm với độ lệch tải công việc 10% [Lan09]. Hình 10 cho thấy công suất của server chia cho số die trên mỗi server đối với ba chip bằng cách thay đổi tải công việc của CNN0. Chúng tôi biểu diễn công suất tăng thêm (K80 và TPU) cũng như công suất tổng (K80+Haswell/4 và TPU+Haswell/2) cho GPU và TPU. Lưu ý rằng tất cả đều được cung cấp cùng kích thước lô.
Chúng tôi thấy rằng TPU có công suất thấp nhất—118W trên mỗi die cho tổng công suất (TPU+Haswell/2) và 40W trên mỗi die cho công suất tăng thêm (TPU trong Hình 10)—nhưng nó có tính tỷ lệ thuận với năng lượng kém: ở mức tải 10%, TPU sử dụng 88% công suất mà nó sử dụng ở mức 100%. (Lịch trình thiết kế ngắn đã ngăn việc đưa vào nhiều tính năng tiết kiệm năng lượng.) Không có gì đáng ngạc nhiên, Haswell có tính tỷ lệ thuận với năng lượng tốt nhất trong nhóm: nó sử dụng 56% công suất ở mức tải 10% so với khi ở mức 100%. K80 gần với CPU hơn TPU, sử dụng 66% công suất khi đầy tải ở mức tải công việc 10%. LSTM1, vốn không bị giới hạn bởi tính toán, hoạt động tương tự: ở mức tải 10%, CPU sử dụng 47% công suất đầy tải, GPU sử dụng 78%, và TPU sử dụng 94%.
Điều gì xảy ra với mức sử dụng công suất của server khi chạy CNN0 nếu nó trở thành máy chủ cho các bộ tăng tốc? Khi GPU và TPU ở mức tải 100%, server CPU sử dụng 52% công suất đầy tải cho GPU và 69% cho TPU. (CPU thực hiện nhiều công việc hơn cho TPU vì nó đang chạy nhanh hơn GPU rất nhiều.) Do đó, server Haswell cùng với bốn TPU sử dụng <20% công suất bổ sung nhưng chạy CNN0 nhanh hơn 80 lần so với riêng server Haswell (4 TPU so với 2 CPU).
7 Đánh giá các thiết kế TPU thay thế
Giống như một FPU, bộ đồng xử lý TPU có kiến trúc vi mô (microarchitecture) tương đối dễ đánh giá, vì vậy chúng tôi đã tạo một mô hình hiệu năng (performance model) cho sáu ứng dụng của mình. Bảng 7 cho thấy sự khác biệt giữa các kết quả của mô hình và các bộ đếm hiệu năng phần cứng, với giá trị trung bình dưới 10%. Sau đó chúng tôi mô hình hóa hiệu năng khi thay đổi băng thông bộ nhớ, tần số xung nhịp và số lượng bộ tích lũy, cùng với kích thước của đơn vị nhân ma trận.
Hình 11 cho thấy độ nhạy hiệu năng trung bình của khuôn TPU khi chúng tôi mở rộng các tham số này trong phạm vi từ 0.25x đến 4x. Hình này biểu diễn các giá trị trung bình có trọng số, nhưng các giá trị trung bình hình học trông tương tự. Ngoài việc đánh giá tác động của chỉ tăng tần số xung nhịp (clock trong Hình 11), chúng tôi cũng biểu diễn một thiết kế (clock+) trong đó tần số xung nhịp được tăng lên và số lượng bộ tích lũy được mở rộng tương ứng để trình biên dịch có thể giữ nhiều tham chiếu bộ nhớ hơn đang được xử lý. Tương tự, chúng tôi biểu diễn việc mở rộng đơn vị ma trận nếu tăng số lượng bộ tích lũy theo bình phương của mức tăng ở một chiều (matrix+), vì số lượng bộ nhân trong ma trận tăng theo cả hai chiều, cũng như chỉ tăng riêng đơn vị ma trận (matrix).
| MLP0 | MLP1 | LSTM0 | LSTM1 | CNN0 | CNN1 |
|---|---|---|---|---|---|
| 6.8% | 10.9% | 7.7% | 5.4% | 8.2% | 11.2% |
Bảng 7. Sự khác biệt về số chu kỳ xung nhịp giữa các bộ đếm hiệu năng phần cứng TPU và mô hình hiệu năng TPU. Giá trị trung bình là 8%.
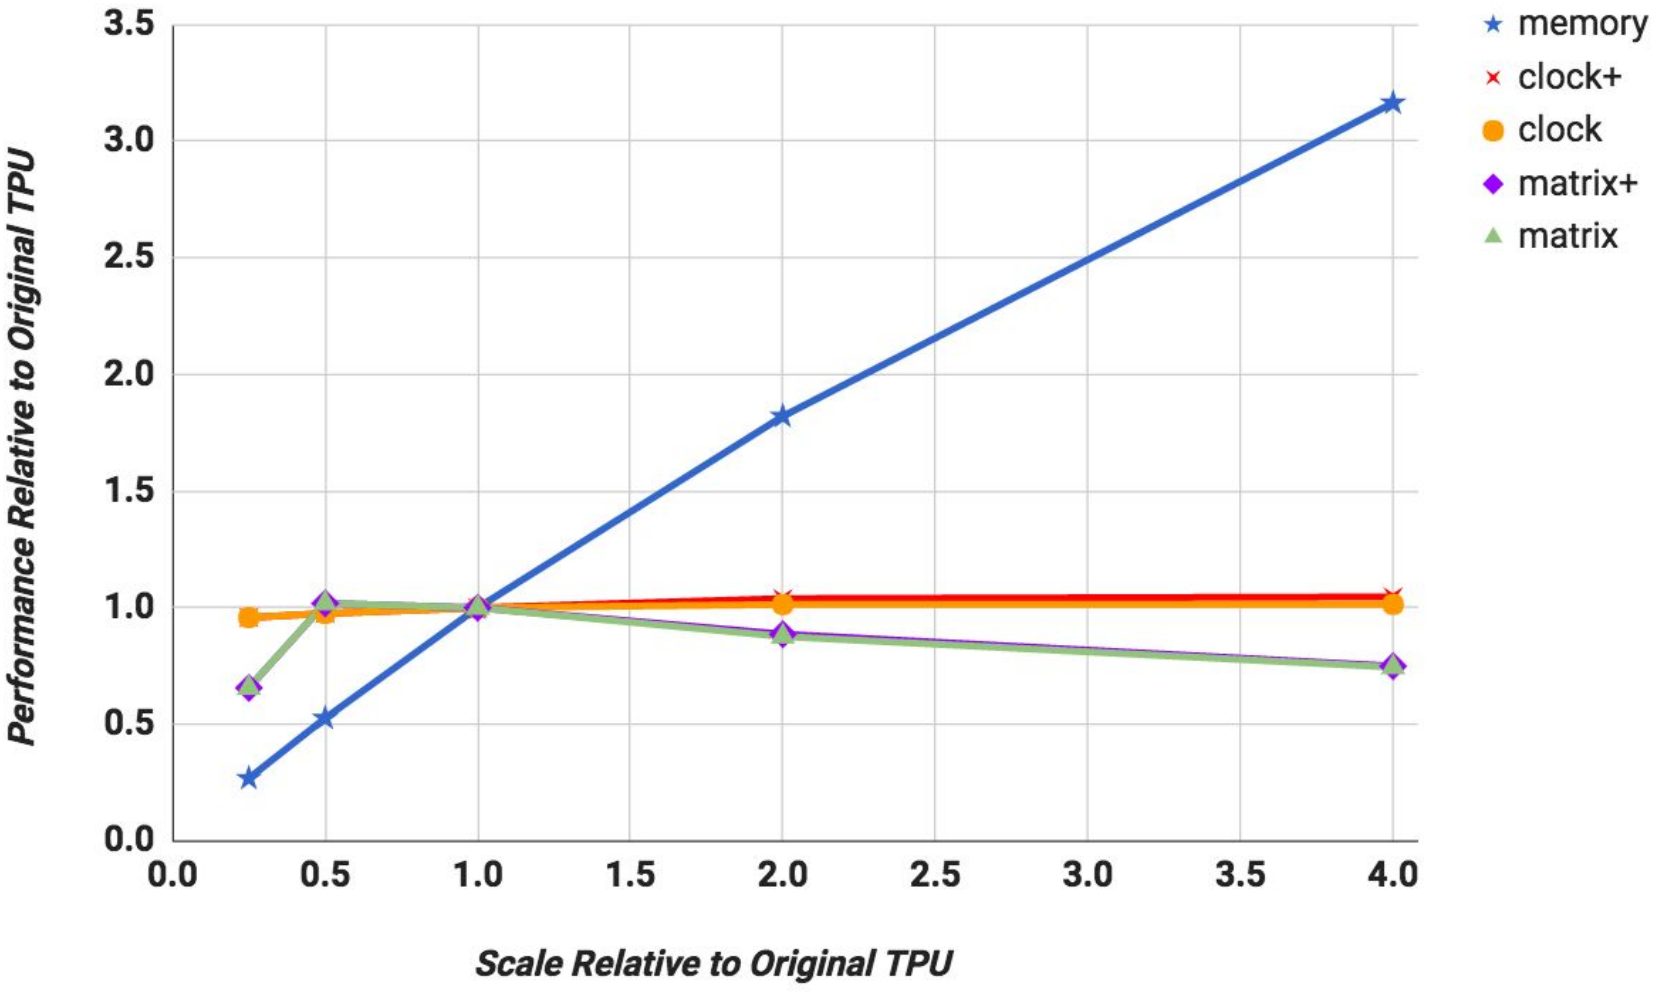
Thứ nhất, việc tăng băng thông bộ nhớ (memory) có tác động lớn nhất: hiệu năng cải thiện trung bình 3X khi bộ nhớ tăng 4X. Thứ hai, tần số xung nhịp có ít lợi ích trung bình dù có hay không có thêm bộ tích lũy. Lý do là MLP và LSTM bị giới hạn bởi bộ nhớ nhưng chỉ CNN bị giới hạn bởi tính toán. Mặc dù khó thấy trong Hình 11, vì hình này chỉ hiển thị giá trị trung bình có trọng số của cả sáu DNN, việc tăng tần số xung nhịp lên 4X hầu như không có tác động đến MLP và LSTM nhưng cải thiện hiệu năng của CNN khoảng 2X. Thứ ba, hiệu năng trung bình trong Hình 11 hơi giảm khi đơn vị ma trận mở rộng từ 256x256 lên 512x512 cho tất cả ứng dụng, bất kể chúng có nhận thêm bộ tích lũy hay không. Vấn đề này tương tự như phân mảnh nội bộ của các trang lớn, chỉ tệ hơn vì nó xảy ra trong hai chiều. Xét ma trận 600x600 được sử dụng trong LSTM1. Với một đơn vị ma trận 256x256, cần 9 bước để lát ma trận 600x600, tổng cộng mất 18 us thời gian. Đơn vị 512x512 lớn hơn chỉ cần bốn bước, nhưng mỗi bước mất thời gian dài gấp bốn lần, tổng cộng 32 us. Các lệnh CISC của chúng tôi dài, vì vậy giải mã không đáng kể và không che giấu được chi phí phụ trội của việc tải từ DRAM.
Bảng 8 cho thấy mức sử dụng của Unified Buffer 24 MiB, ban đầu được định kích thước để cho phép MLP chạy với kích thước lô lên đến 2048. Gần đây chúng tôi đã cải thiện bộ cấp phát lưu trữ cho Unified Buffer, giúp giảm bộ nhớ cần thiết cho ứng dụng lớn nhất trong sáu ứng dụng xuống còn 14 MiB. Trong 18 tháng đầu tiên triển khai, TPU sử dụng toàn bộ dung lượng của nó trong khi bộ cấp phát mới được phát triển. Hiện nay dung lượng bổ sung tạo ra khoảng dự phòng cho việc áp dụng các mô hình lớn hơn.
Tiếp theo chúng tôi sử dụng mô hình hiệu năng để đánh giá một khuôn TPU giả định (TPU') có thể đã được thiết kế trong cùng công nghệ quy trình nếu chúng tôi có hơn 15 tháng. Việc tổng hợp logic và thiết kế khối tích cực hơn có thể đã tăng tần số xung nhịp lên 50%. Thiết kế một mạch giao diện cho bộ nhớ GDDR5, như trong K80, sẽ cải thiện băng thông Weight Memory hơn năm lần, dịch chuyển điểm gờ roofline của nó từ 1350 xuống 250. Như Hình 11 cho thấy, tăng tần số xung nhịp lên 1050 MHz nhưng không hỗ trợ bộ nhớ hầu như không tạo ra thay đổi. Nếu chúng tôi giữ xung nhịp ở 700 MHz nhưng sử dụng GDDR5 cho Weight Memory, mức tăng trung bình hình học tăng lên 2.6 đầy ấn tượng và trung bình có trọng số tăng lên 3.9. Thực hiện cả hai việc làm tăng trung bình hình học (2.9) nhưng không tăng trung bình có trọng số, vì vậy TPU’ chỉ có bộ nhớ nhanh hơn.
Hình 11 không bao gồm thời gian của server máy chủ. Chúng tôi sử dụng Bảng 5 để tính toán thời gian cho chi phí phụ trội tương tác với server máy chủ của TPU. Việc thêm cùng khoảng thời gian bổ sung đó làm giảm các giá trị trung bình của TPU’ từ 2.6 xuống 1.9 và từ 3.9 xuống 3.2. Thay đổi này vừa lạc quan, vì nó không bao gồm thời gian CPU để chạy phần ứng dụng của nó, vừa bi quan, vì chúng tôi có khả năng sẽ tinh chỉnh mạnh mã máy chủ khi có một TPU’ nhanh hơn 3X.
Thay thế chỉ Weight Memory DDR3 bằng bộ nhớ GDDR5 tương đương yêu cầu tăng gấp đôi số kênh bộ nhớ lên bốn. Cải tiến này sẽ mở rộng kích thước khuôn khoảng 10%. Tuy nhiên, băng thông bộ nhớ cao hơn làm giảm áp lực lên Unified Buffer, vì vậy việc giảm Unified Buffer xuống 14 MiB có thể lấy lại 10% diện tích. GDDR5 cũng sẽ tăng ngân sách công suất hệ thống TPU từ 861 Watts lên khoảng 900 Watts, vì có 4 TPU trên mỗi server.
Hình 9 ở trên cho thấy hiệu năng tổng thể/Watt/khuôn tương đối của TPU’ tăng vọt lên 31X - 86X so với Haswell và 25X - 41X so với K80. Chỉ số gia tăng tăng vọt lên mức đáng kinh ngạc 69X - 196X so với Haswell và 42X - 68X so với K80.
| MLP0 | MLP1 | LSTM0 | LSTM1 | CNN0 | CNN1 |
|---|---|---|---|---|---|
| 11.0 | 2.3 | 4.8 | 4.5 | 1.5 | 13.9 |
Bảng 8. MiB tối đa của Unified Buffer 24 MiB được sử dụng cho mỗi ứng dụng NN. Một Unified Buffer 14 MiB là đủ cho các ứng dụng này.
8 Thảo luận
Phần này tuân theo kiểu bác bỏ của [Hen18] đối với các ngụy biện và cạm bẫy. • Ngụy biện: Các ứng dụng suy luận NN trong các datacenter coi trọng thông lượng ngang với thời gian phản hồi. Chúng tôi rất ngạc nhiên khi các nhà phát triển của mình có những yêu cầu mạnh mẽ về thời gian phản hồi, vì một số người đã đề xuất vào năm 2014 rằng kích thước lô sẽ đủ lớn để TPU đạt hiệu năng cực đại hoặc rằng các yêu cầu về độ trễ sẽ không quá chặt chẽ. Một ứng dụng thúc đẩy là xử lý ảnh ngoại tuyến, và trực giác là nếu các dịch vụ tương tác cũng muốn sử dụng TPU, hầu hết chúng sẽ chỉ tích lũy các lô lớn hơn. Ngay cả các nhà phát triển của một ứng dụng vào năm 2014 quan tâm đến thời gian phản hồi (LSTM1) cũng nói rằng giới hạn là 10 ms vào năm 2014, nhưng đã giảm xuống còn 7 ms khi họ thực sự chuyển nó sang TPU. Mong muốn bất ngờ đối với TPU của nhiều dịch vụ như vậy kết hợp với tác động và sự ưu tiên dành cho thời gian phản hồi thấp đã thay đổi phương trình, với các nhà viết ứng dụng thường chọn giảm độ trễ thay vì chờ tích lũy các lô lớn hơn. May mắn thay, TPU có một mô hình thực thi đơn giản và có thể lặp lại để giúp đáp ứng các mục tiêu về thời gian phản hồi của các dịch vụ tương tác và có thông lượng cực đại cao đến mức ngay cả các kích thước lô nhỏ cũng tạo ra hiệu năng cao hơn các CPU và GPU đương thời. • Ngụy biện: Kiến trúc GPU K80 là sự phù hợp tốt cho suy luận NN. GPU theo truyền thống được xem là các kiến trúc có thông lượng cao dựa vào DRAM băng thông cao và hàng nghìn luồng để đạt được mục tiêu của chúng. Góc nhìn này giúp giải thích tại sao K80 chỉ nhanh hơn một chút khi suy luận so với Haswell và chậm hơn nhiều so với TPU. Các thế hệ kế nhiệm của K80 chắc chắn sẽ bao gồm các tối ưu hóa để cải thiện hiệu năng suy luận cực đại, nhưng do cách tiếp cận kiến trúc hướng tới thông lượng của chúng, việc GPU đáp ứng các giới hạn độ trễ nghiêm ngặt có thể khó khăn hơn. Và như Section 7 chỉ ra, vẫn còn nhiều dư địa để cải thiện TPU, vì vậy đây không phải là một mục tiêu dễ dàng.
• Cạm bẫy: Các kiến trúc sư đã bỏ qua các tác vụ NN quan trọng. Chúng tôi hài lòng với sự chú ý mà cộng đồng kiến trúc đang dành cho NN: 15% các bài báo tại ISCA 2016 nói về các bộ tăng tốc phần cứng cho NN [Alb16] [Che16a][Chi16][Han16][Kim16][LiK16][Liu16][Rea16] [Sha16]! Tuy nhiên, cả chín bài báo đều xem xét CNN, và chỉ hai bài đề cập đến các NN khác. CNN phức tạp hơn MLP và nổi bật trong các cuộc thi NN [Rus15], điều này có thể giải thích sức hấp dẫn của chúng, nhưng chúng chỉ chiếm khoảng 5% tải công việc NN trong datacenter của chúng tôi. Mặc dù CNN có thể phổ biến trong các thiết bị biên, khối lượng các mô hình tích chập vẫn chưa bắt kịp MLP và LSTM trong datacenter. Chúng tôi hy vọng các kiến trúc sư sẽ cố gắng tăng tốc MLP và LSTM với ít nhất sự nhiệt tình tương đương. • Cạm bẫy: Đối với phần cứng NN, Inferences Per Second (IPS) là một chỉ số hiệu năng tổng hợp không chính xác. Kết quả của chúng tôi cho thấy IPS là một bản tóm tắt hiệu năng tổng thể kém cho phần cứng NN, vì nó đơn giản là nghịch đảo của độ phức tạp của suy luận điển hình trong ứng dụng (ví dụ: số lượng, kích thước và kiểu của các lớp NN). Ví dụ, TPU chạy MLP1 4 lớp ở 360,000 IPS nhưng CNN1 89 lớp chỉ ở 4,700 IPS, vì vậy IPS của TPU thay đổi 75X! Do đó, việc sử dụng IPS làm chỉ số tốc độ duy nhất là gây hiểu lầm nhiều hơn nữa đối với các bộ tăng tốc NN so với việc MIPS hoặc FLOPS là đối với các bộ xử lý thông thường [Hen18], vì vậy IPS thậm chí còn nên bị xem nhẹ hơn. Để so sánh các máy NN tốt hơn, chúng ta cần một bộ phép đo chuẩn được viết ở mức cao để chuyển nó sang nhiều kiến trúc NN khác nhau. Fathom là một nỗ lực mới đầy hứa hẹn cho một bộ phép đo chuẩn như vậy [Ado16]. • Ngụy biện: Kết quả GPU K80 sẽ tốt hơn nhiều nếu bật chế độ Boost. Bỏ qua tác động tiêu cực của chế độ Boost của K80 lên TCO (Section 3), chúng tôi đã đo nó trên LSTM1. Chế độ Boost tăng tốc độ xung nhịp lên hệ số tối đa 1.6—từ 560 đến 875 MHz—làm tăng hiệu năng 1.4X, nhưng nó cũng tăng công suất lên 1.3X. Mức tăng ròng về hiệu năng/Watt là 1.1X, và do đó đối với LSTM1, chế độ boost sẽ có tác động nhỏ đến phân tích tốc độ năng lượng của chúng tôi. • Ngụy biện: Kết quả CPU và GPU sẽ tương đương với TPU nếu chúng ta sử dụng chúng hiệu quả hơn hoặc so sánh với các phiên bản mới hơn. Ban đầu chúng tôi có kết quả 8-bit chỉ cho một DNN trên CPU, do lượng công việc đáng kể cần thiết để sử dụng hỗ trợ số nguyên AVX2 một cách hiệu quả. Lợi ích là ~3.5X. Việc trình bày tất cả kết quả CPU ở dạng dấu phẩy động ít gây nhầm lẫn hơn (và tốn ít không gian hơn), thay vì có một ngoại lệ với roofline riêng của nó. Nếu tất cả DNN có mức tăng tốc tương tự, tỷ lệ hiệu năng/Watt sẽ giảm từ 41-83X xuống 12-24X. GPU datacenter P40 mới 16-nm, 1.5GHz, 250W có thể thực hiện 47 Tera 8-bit ops/sec, nhưng không có sẵn vào đầu năm 2015, nên không cùng thời với ba nền tảng của chúng tôi. Chúng tôi cũng không thể biết phần tỷ lệ của đỉnh P40 được cung cấp trong các giới hạn thời gian cứng nhắc của mình. Nếu chúng tôi so sánh các chip mới hơn, Section 7 cho thấy chúng tôi có thể tăng gấp ba hiệu năng của TPU 28-nm, 0.7GHz, 40W chỉ bằng cách sử dụng bộ nhớ GDDR5 của K80 (với chi phí thêm 10W). • Cạm bẫy: Các bộ đếm hiệu năng được thêm vào như một ý nghĩ sau đối với phần cứng NN. TPU có 106 bộ đếm hiệu năng, và nếu có điều gì thì chúng tôi muốn có thêm một vài bộ nữa (xem Table 3). Lý do tồn tại của các bộ tăng tốc NN là hiệu năng, và còn quá sớm trong quá trình phát triển của chúng để có trực giác tốt về những gì đang diễn ra. • Ngụy biện: Sau hai năm tinh chỉnh phần mềm, con đường duy nhất còn lại để tăng hiệu năng TPU là nâng cấp phần cứng. Hiệu năng của CNN1 trên TPU có thể được cải thiện nếu các nhà phát triển và người viết trình biên dịch làm nhiều công việc hơn để ghép CNN1 với phần cứng TPU. Ví dụ, các nhà phát triển có thể tổ chức lại các ứng dụng để tổng hợp nhiều lô ngắn từ các lớp tích chập thành một lô đơn, sâu hơn (từ 32 đến 128) cho bốn lớp kết nối đầy đủ. Một lớp đơn như vậy sẽ cải thiện mức sử dụng của đơn vị ma trận (Table 3). Vì CNN1 hiện chạy nhanh hơn CPU hơn 70 lần trên TPU, các nhà phát triển CNN1 đã rất hài lòng, vì vậy không rõ liệu hoặc khi nào các tối ưu hóa như vậy sẽ được thực hiện.
9 Công trình liên quan
Hai bài báo khảo sát ghi nhận rằng các ASIC NN tùy chỉnh đã xuất hiện từ ít nhất 25 năm trước [Ien96][Asa02]. Ví dụ, các chip CNAPS chứa một mảng SIMD 64 phần tử gồm các bộ nhân 16-bit với 8-bit, và một số chip CNAPS có thể được kết nối với nhau bằng một bộ tuần tự [Ham90]. Hệ thống Synapse-1 dựa trên một chip nhân-tích lũy dạng tâm thu tùy chỉnh có tên MA-16, thực hiện mười sáu phép nhân 16-bit cùng một lúc [Ram91]. Hệ thống ghép nối nhiều chip MA-16 với nhau và có phần cứng tùy chỉnh để thực hiện các hàm kích hoạt.
Hai mươi lăm máy trạm SPERT-II, được tăng tốc bởi ASIC tùy chỉnh T0, đã được triển khai bắt đầu từ năm 1995 để thực hiện cả huấn luyện NN và suy luận cho nhận dạng tiếng nói [Asa98]. T0 40-Mhz đã bổ sung các lệnh vectơ vào kiến trúc tập lệnh MIPS. Đơn vị vectơ tám làn có thể tạo ra tối đa mười sáu kết quả số học 32-bit mỗi chu kỳ xung nhịp dựa trên các đầu vào 8-bit và 16-bit, khiến nó nhanh hơn 25 lần trong suy luận và nhanh hơn 20 lần trong huấn luyện so với một máy trạm SPARC-20. Họ nhận thấy rằng 16 bit không đủ cho huấn luyện, vì vậy họ sử dụng hai từ 16-bit thay thế, làm tăng gấp đôi thời gian huấn luyện. Để khắc phục nhược điểm đó, họ đưa vào các “bunches” (batches) gồm 32 đến 1000 tập dữ liệu để giảm thời gian dành cho việc cập nhật trọng số, giúp nó nhanh hơn so với huấn luyện bằng một từ nhưng không có batches.
Họ kiến trúc NN DianNao gần đây hơn giảm thiểu các truy cập bộ nhớ cả trên chip và tới DRAM bên ngoài bằng cách có hỗ trợ kiến trúc hiệu quả cho các mẫu truy cập bộ nhớ xuất hiện trong các ứng dụng NN [Keu16]
[Che16a]. Tất cả đều sử dụng các phép toán số nguyên 16-bit và tất cả các thiết kế đều đi sâu đến mức bố trí, nhưng không có chip nào được chế tạo. DianNao ban đầu sử dụng một mảng gồm 64 đơn vị nhân-tích lũy số nguyên 16-bit với 44 KB bộ nhớ trên chip và được ước tính có kích thước 3 mm² (65 nm), chạy ở 1 GHz, và tiêu thụ 0.5W [Che14a]. Phần lớn năng lượng này dành cho các truy cập DRAM tới các trọng số, vì vậy một phiên bản kế nhiệm DaDianNao ("big computer") bao gồm eDRAM để giữ 36 MiB trọng số trên chip [Che14b]. Mục tiêu là có đủ bộ nhớ trong một hệ thống nhiều chip để tránh các truy cập DRAM bên ngoài. PuDianNao kế nhiệm ("general computer") hướng tới các thuật toán học máy truyền thống hơn ngoài DNN, chẳng hạn như máy vectơ hỗ trợ [Liu15]. Một nhánh khác là ShiDianNao ("vision computer") hướng tới CNN, tránh các truy cập DRAM bằng cách kết nối bộ tăng tốc trực tiếp với cảm biến [Du15].
Convolution Engine cũng tập trung vào CNN cho xử lý ảnh [Qad13]. Thiết kế này triển khai 64 đơn vị nhân-tích lũy 10-bit và tùy chỉnh một bộ xử lý Tensilica được ước tính chạy ở 800 MHz trong 45 nm. Nó được dự đoán có hiệu quả năng lượng-diện tích cao hơn từ 8X đến 15X so với một bộ xử lý SIMD, và nằm trong khoảng từ 2X đến 3X so với phần cứng tùy chỉnh chỉ được thiết kế cho một kernel cụ thể.
Bài báo phép đo chuẩn Fathom dường như báo cáo các kết quả trái ngược với chúng tôi, với GPU thực hiện suy luận nhanh hơn nhiều so với CPU [Ado16]. Tuy nhiên, CPU và GPU của họ không thuộc lớp server, CPU chỉ có bốn lõi, các ứng dụng không sử dụng các lệnh AVX của CPU, và không có giới hạn thời gian đáp ứng (xem Table 4) [Bro16].
Catapult là ví dụ được triển khai rộng rãi nhất về việc sử dụng khả năng cấu hình lại để hỗ trợ DNN, điều mà nhiều nghiên cứu đã đề xuất [Far09][Cha10][Far11][Pee13][Cav15][Zha15]. Họ chọn FPGA thay vì GPU để giảm công suất cũng như rủi ro rằng các ứng dụng nhạy cảm với độ trễ sẽ không ánh xạ tốt lên GPU. FPGA cũng có thể được tái sử dụng, chẳng hạn như cho tìm kiếm, nén và các card giao diện mạng [Put15]. Dự án TPU thực sự bắt đầu với FPGA, nhưng chúng tôi đã từ bỏ chúng khi nhận thấy rằng các FPGA thời điểm đó không có hiệu năng cạnh tranh so với GPU thời điểm đó, và TPU có thể có công suất thấp hơn nhiều so với GPU trong khi nhanh tương đương hoặc nhanh hơn, mang lại các lợi ích đáng kể tiềm năng so với cả FPGA và GPU.
Mặc dù được công bố lần đầu vào năm 2014 [Put14], Catapult là một sản phẩm cùng thời với TPU vì nó triển khai FPGA Stratix V 28-nm vào các trung tâm dữ liệu đồng thời với TPU vào năm 2015. Catapult có xung nhịp 200 MHz, 3,926 MAC 18-bit, 5 MiB bộ nhớ trên chip, băng thông bộ nhớ 11 GB/s, và sử dụng 25 Watts. TPU có xung nhịp 700 MHz, 65,536 MAC 8-bit, 28 MiB, 34 GB/s, và thường sử dụng 40 Watts. Một phiên bản sửa đổi của Catapult sử dụng các FPGA mới hơn và được triển khai ở quy mô lớn hơn vào năm 2016 [Cau16].
Catapult V1 chạy CNN, sử dụng một bộ nhân ma trận dạng tâm thu, nhanh gấp 2.3X so với một server 2.1 GHz, 16 lõi, hai socket [Ovt15a]. Sử dụng thế hệ FPGA tiếp theo (14-nm Arria 10) của Catapult V2, hiệu năng có thể tăng lên 7X, và thậm chí có thể đạt 17X với việc floorplanning cẩn thận hơn [Ovt15b]. Mặc dù đây là so sánh giữa táo và cam, một die TPU hiện tại chạy các CNN của nó nhanh hơn từ 40X đến 70X so với một server nhanh hơn đôi chút (Tables 2 và 6). Có lẽ khác biệt lớn nhất là để đạt hiệu năng tốt nhất, người dùng phải viết các chương trình dài bằng ngôn ngữ thiết kế phần cứng cấp thấp Verilog [Met16][Put16] thay vì viết các chương trình ngắn sử dụng khung TensorFlow cấp cao. Nghĩa là, khả năng lập trình lại đến từ phần mềm cho TPU thay vì từ firmware cho FPGA.
Các nghiên cứu gần đây, xuất hiện sau khi TPU được triển khai, tăng tốc DNN bằng cách tối ưu hóa các trường hợp khi trọng số và dữ liệu rất nhỏ hoặc bằng không. Lịch trình chặt chẽ của chúng tôi đã ngăn cản các tối ưu hóa như vậy trong TPU, nhưng chúng tôi nhận thấy cùng cơ hội này trong các nghiên cứu của mình. Efficient Inference Engine dựa trên một bước đầu tiên làm giảm số lượng trọng số khoảng một hệ số 10 [Han15] như một bước riêng biệt bằng cách lọc ra các giá trị rất nhỏ, sau đó sử dụng mã hóa Huffman để thu nhỏ dữ liệu hơn nữa nhằm cải thiện hiệu năng suy luận [Han16]. Cnvlutin [Alb16] tránh các phép nhân khi đầu vào kích hoạt bằng không, điều xảy ra 44% thời gian, có lẽ một phần do hàm phi tuyến ReLU biến đổi các giá trị âm thành không, để cải thiện hiệu năng trung bình 1.4 lần.
Eyeriss là một kiến trúc luồng dữ liệu mới, công suất thấp, tận dụng các giá trị 0 bằng cách mã hóa độ dài chạy dữ liệu để giảm dấu chân bộ nhớ và tiết kiệm năng lượng bằng cách tránh các phép tính khi đầu vào là 0 [Che16a]. Sử dụng thuật ngữ Eyeriss, một lớp tích chập TPU ánh xạ C và M tới các hàng và cột của đơn vị ma trận, mất HWN chu kỳ để thực hiện một lượt quét. Với C/M cao, cần RS lượt quét để xử lý lớp; với C/M thấp, một số kỹ thuật làm giảm số lượt quét và cải thiện mức sử dụng. (Có thể tìm thêm trong các tài liệu tham khảo trực tuyến [Ros15a][Ros15b][Ros15c][Ros15f][Tho15][You15]).
Minerva là một hệ thống đồng thiết kế vượt qua các lĩnh vực thuật toán, kiến trúc và mạch để giảm công suất 8X, một phần bằng cách cắt tỉa dữ liệu kích hoạt với các giá trị nhỏ và một phần bằng cách lượng tử hóa dữ liệu [Rea16]. [Gup15] xem xét phép toán dấu phẩy cố định 16-bit cho huấn luyện thay vì cho suy luận. Các công trình khác tận dụng độ chính xác thấp hơn của các phép tính DNN bằng cách sử dụng các mạch tương tự trong quá trình tính toán để cải thiện năng lượng và hiệu năng [LiK16] [Sha16]. Bằng cách điều chỉnh một tập lệnh cho DNN, Cambricon giảm kích thước mã [Liu16]. Các công trình gần đây xem xét các kiến trúc bộ xử lý trong bộ nhớ cho NN [Chi16][Kim16].
So sánh TPU với một số kiến trúc này: • [Che14a] DMA dữ liệu từ DRAM tới các bộ đệm đầu vào và trọng số. Chúng được đọc bởi NFU có đường ống 3 giai đoạn, thực hiện các phép nhân, phép cộng và các hàm phi tuyến; các kết quả đi tới bộ đệm đầu ra, sau đó tới DRAM. NFU không có lưu trữ và không phải là systolic.
• [Gup15] dường như truyền luồng cả hai đầu vào ma trận trong khi lưu các tổng từng phần trong mảng systolic; TPU lưu tile ma trận trọng số trong khi truyền luồng đầu vào còn lại và các tổng từng phần trước kích hoạt. TPU không hỗ trợ làm tròn ngẫu nhiên. • [Zha15] được xây dựng từ các đơn vị tính toán tương đương với phiên bản 4x2 của đơn vị ma trận TPU. Trong một ASIC, chi phí nối dây của các crossbar kết nối bộ đệm đầu vào và đầu ra với các engine tính toán này sẽ rất đáng kể. Chúng tôi ngạc nhiên khi không thấy hỗ trợ kiến trúc cho các phép rút gọn bổ sung để kết hợp các kết quả từ các engine tính toán trong [Zha15]. Cả ba công trình [Gup15][Che14][Zha15] đều lưu các giá trị kích hoạt trong DRAM trong quá trình tính toán; Unified Buffer của TPU có kích thước đủ lớn để không xảy ra việc tràn sang DRAM hoặc nạp lại trong quá trình hoạt động bình thường.
10 Kết luận
Mặc dù sống trên một bus I/O và có băng thông bộ nhớ tương đối nhỏ làm hạn chế việc sử dụng TPU—bốn trong sáu ứng dụng NN bị giới hạn bởi bộ nhớ—một phần nhỏ của một con số lớn vẫn có thể tương đối lớn, như mô hình hiệu năng Roofline chứng minh. Kết quả này gợi ý một “Hệ quả Cornucopia” đối với Định luật Amdahl: mức sử dụng thấp của một tài nguyên khổng lồ, giá rẻ vẫn có thể mang lại hiệu năng cao, hiệu quả về chi phí.
TPU tận dụng sự giảm bậc độ lớn về năng lượng và diện tích của các bộ nhân ma trận dạng tâm thu số nguyên 8-bit so với các đường dẫn dữ liệu dấu phẩy động 32-bit của GPU K80 để tích hợp số lượng MAC gấp 25 lần (65,536 8-bit so với 2,496 32-bit) và bộ nhớ trên chip lớn gấp 3.5 lần (28 MiB so với 8 MiB) trong khi sử dụng ít hơn một nửa công suất của K80 trong một die tương đối nhỏ. Bộ nhớ lớn hơn này giúp tăng cường độ hoạt động của các ứng dụng để cho phép chúng tận dụng các MAC dồi dào một cách đầy đủ hơn nữa.
Chúng tôi nhận thấy rằng mặc dù gần đây cộng đồng kiến trúc nhấn mạnh vào CNN, chúng chỉ chiếm khoảng 5% tải công việc NN đại diện cho các datacenter của chúng tôi, điều này cho thấy cần chú ý nhiều hơn đến MLP và LSTM. Lặp lại lịch sử, điều này tương tự như khi nhiều kiến trúc sư tập trung vào hiệu năng dấu phẩy động trong khi phần lớn tải công việc chính thống hóa ra lại bị chi phối bởi các phép toán số nguyên.
Chúng tôi quan sát thấy rằng số lượng suy luận mỗi giây (IPS) phụ thuộc nhiều hơn vào NN chứ không phải phần cứng bên dưới, và do đó IPS là một chỉ số hiệu năng đơn lẻ còn tệ hơn đối với các bộ xử lý NN so với MIPS và MFLOPS đối với CPU và GPU.
Chúng tôi cũng nhận thấy rằng các ứng dụng suy luận có các cận thời gian đáp ứng nghiêm ngặt vì chúng thường là một phần của các ứng dụng hướng tới người dùng, do đó kiến trúc NN cần hoạt động tốt khi xử lý các thời hạn độ trễ ở phân vị thứ 99. Mặc dù K80 có thể vượt trội trong huấn luyện, trung bình nó chỉ nhanh hơn Haswell một chút trong suy luận đối với tải công việc của chúng tôi, có lẽ vì nó nhấn mạnh vào thông lượng thay vì độ trễ; điều đó xung đột với các thời hạn đáp ứng nghiêm ngặt của các ứng dụng suy luận của chúng tôi.
Die TPU tận dụng lợi thế về MAC và bộ nhớ trên chip để chạy các chương trình ngắn được viết bằng khung TensorFlow chuyên biệt theo miền nhanh gấp 15 lần die GPU K80, dẫn đến lợi thế hiệu năng/Watt là 29 lần, tương quan với hiệu năng/tổng chi phí sở hữu. So với die CPU Haswell, các tỷ lệ tương ứng là 29 và 83. Mặc dù các CPU và GPU tương lai chắc chắn sẽ chạy suy luận nhanh hơn, một TPU được thiết kế lại sử dụng bộ nhớ GPU vào khoảng năm 2015 sẽ nhanh hơn từ hai đến ba lần và nâng lợi thế hiệu năng/Watt lên gần 70 lần so với K80 và 200 lần so với Haswell.
Tóm lại, TPU thành công nhờ đơn vị nhân ma trận lớn—nhưng không quá lớn; bộ nhớ trên chip đáng kể được điều khiển bằng phần mềm; khả năng chạy toàn bộ mô hình suy luận để giảm sự phụ thuộc vào CPU máy chủ; mô hình thực thi đơn luồng, xác định đã chứng minh là phù hợp với các giới hạn thời gian đáp ứng ở phân vị thứ 99; đủ tính linh hoạt để phù hợp với các NN của năm 2017 cũng như năm 2013; việc loại bỏ các tính năng đa dụng giúp tạo ra một die nhỏ và công suất thấp mặc dù có đường dẫn dữ liệu và bộ nhớ lớn hơn; việc sử dụng số nguyên 8-bit bởi các ứng dụng lượng tử hóa; và việc các ứng dụng được viết bằng TensorFlow, giúp dễ dàng chuyển chúng sang TPU với hiệu năng cao thay vì phải viết lại để chạy tốt trên phần cứng TPU rất khác biệt.
Sự khác biệt bậc độ lớn giữa các sản phẩm thương mại là hiếm trong kiến trúc máy tính, điều này có thể khiến TPU trở thành một nguyên mẫu cho các kiến trúc chuyên biệt theo miền. Chúng tôi kỳ vọng rằng nhiều người sẽ xây dựng các thế hệ kế nhiệm, nâng cao tiêu chuẩn hơn nữa.
Lời cảm ơn
Chúng tôi cảm ơn ban lãnh đạo công ty vì đã nhận ra nhu cầu về một TPU và cung cấp các tài nguyên để xây dựng, phân phối, đánh giá và công bố. Đặc biệt cảm ơn Luiz Barroso và James Laudon vì đã giúp khởi đầu dự án. Cần có sự đóng góp của nhiều người để thiết kế, xác minh và triển khai phần cứng cùng phần mềm của một hệ thống như TPU, cũng như để sản xuất, triển khai và sử dụng nó ở quy mô lớn, đó là lý do có nhiều tác giả. (Tất cả tác giả ngoại trừ David Patterson đều làm việc trên TPU; ông tham gia vào năm 2016.) Bốn tác giả đầu tiên thực hiện phần lớn việc đánh giá trong bài báo này, đó là lý do họ đứng trước, với những người còn lại theo thứ tự bảng chữ cái. Jouppi cũng là kiến trúc sư trưởng của toàn bộ dự án; phần thưởng cho những nỗ lực bền bỉ của ông là trở thành tác giả chính.